



Mikrocontroller entwickeln sich weiter, um AIoT zu ermöglichen
Die Kombination von KI mit IoT ergibt das AIoT – ein expandierender Bereich, in dem Mikrocontroller nun anspruchsvolles Machine Learning hosten, dank Durchbrüchen in neuronaler Netzwerk-Kompression und -Optimierung. Moderne Smartphone-Applikationsprozessoren führen routinemäßig KI-Inferenz für Aufgaben wie Bildanalyse und Empfehlungs-Engines aus und zeigen, dass hochperformantes ML nicht mehr auf Supercomputer beschränkt ist.
Ein Ökosystem von Milliarden IoT-Geräten wird in den nächsten Jahren Machine-Learning-Fähigkeiten erhalten (Bild: NXP)
Die Bereitstellung solcher Intelligenz auf Low-Power-Mikrocontrollern erschließt transformative Use Cases: KI-gesteuerte Hörgeräte, die Umgebungsgeräusche unterdrücken, smarte Geräte, die Nutzer identifizieren und personalisierte Profile anwenden, oder Sensorknoten, die jahrelang mit Mikrojoule-Energiebudgets arbeiten. Edge-Inferenz reduziert Latenz, erhöht Datensicherheit und wahrt Nutzerprivatsphäre.
Doch das Einbetten von ML auf Mikrocontrollern bleibt herausfordernd. Begrenztes SRAM und Flash beschränken die Größe neuronaler Modelle, und der rechnerische Durchsatz ist bescheiden. Rasante Fortschritte in Modell-Quantisierung und Pruning, gekoppelt mit herstellerspezifischem Tooling, schließen diese Lücke stetig.
TinyML gewinnt an Schwung
Die rasche Expansion der Industrie spiegelt sich im TinyML Summit wider, einer Silicon Valley Veranstaltung, die dieses Jahr 27 Sponsoren anzog verglichen mit 11 im Vorjahr, wobei Registrierungsplätze Monate im Voraus ausgebucht waren. Organisatoren berichteten auch von einem Anstieg der Mitgliedschaft für ihre globalen, monatlichen design-orientierten Meetups.
„Wir stellen uns Billionen intelligenter Geräte vor, die von TinyML angetrieben werden, jedes sensierend, analysierend und autonom handelnd, um gesündere, nachhaltigere Umgebungen zu schaffen“, sagte Qualcomms Evgeni Gousev, Co-Chair des TinyML Committee, während der Eröffnungskeynote.
Er führte diesen Schwung auf energieeffizientere Hardware, verfeinerte Algorithmen und ausgereifte Software-Stacks zurück und bemerkte einen Anstieg von Unternehmens- und Venture-Capital-Investitionen sowie gesteigerte Startup-Aktivität und M&A.
Das TinyML Committee betrachtet die Technologie nun als validiert und prognostiziert, dass frühe KI-fähige Mikrocontroller-Produkte in 2–3 Jahren auf den Markt kommen, während wirklich transformative Anwendungen in 3–5 Jahren erscheinen könnten.
Ein wichtiger Meilenstein wurde letzten Frühling erreicht, als Google TensorFlow Lite for Microcontrollers vorstellte – eine leichte Inferenz-Engine, maßgeschneidert für Geräte mit nur Kilobytes RAM. Der Kern-Runtime belegt nur 16 KB auf einem ARM Cortex-M3, und ein vollständiges Speech-Keyword-Detection-Modell passt in 22 KB. Die Bibliothek unterstützt nur Inferenz, kein Training.
Industriegrößen beobachten TinyML
Große Mikrocontroller-Anbieter verfolgen TinyML-Fortschritte genau, da schrumpfende neuronale Modelle ihre Produktchancen erweitern. Die meisten bieten bereits ML-Support. Zum Beispiel liefert STMicroelectronics STM32Cube.AI, ein Extension Pack, das neuronale Netze auf seine STM32 ARM Cortex-M-Familie abbildet und ausführt. Renesas bietet die e-AI Entwicklungsumgebung, die Modelle in C/C++-kompatiblen Code via e² Studio übersetzt. NXP berichtet von Kunden, die Machine Learning auf seinen Low-End Kinetis und LPC MCUs einsetzen, KI sowohl durch Hardware als auch Software integrierend, besonders in seinen Crossover-Prozessoren, die Applikationsprozessoren und Mikrocontroller verbinden.
Arm-zentrierte Architektur
Arm dominiert den Mikrocontroller-Markt mit seiner Cortex-M-Serie. Das Unternehmen führte kürzlich den Cortex-M55 Kern ein, entwickelt für ML-Workloads und gekoppelt mit dem Ethos-U55 KI-Beschleuniger, beide zielen auf ultraniedrigenergetische, ressourcenbeschränkte Umgebungen. Zusammen liefern sie ausreichend Rechenleistung für Gestenerkennung, Biometrie und Spracherkennung.
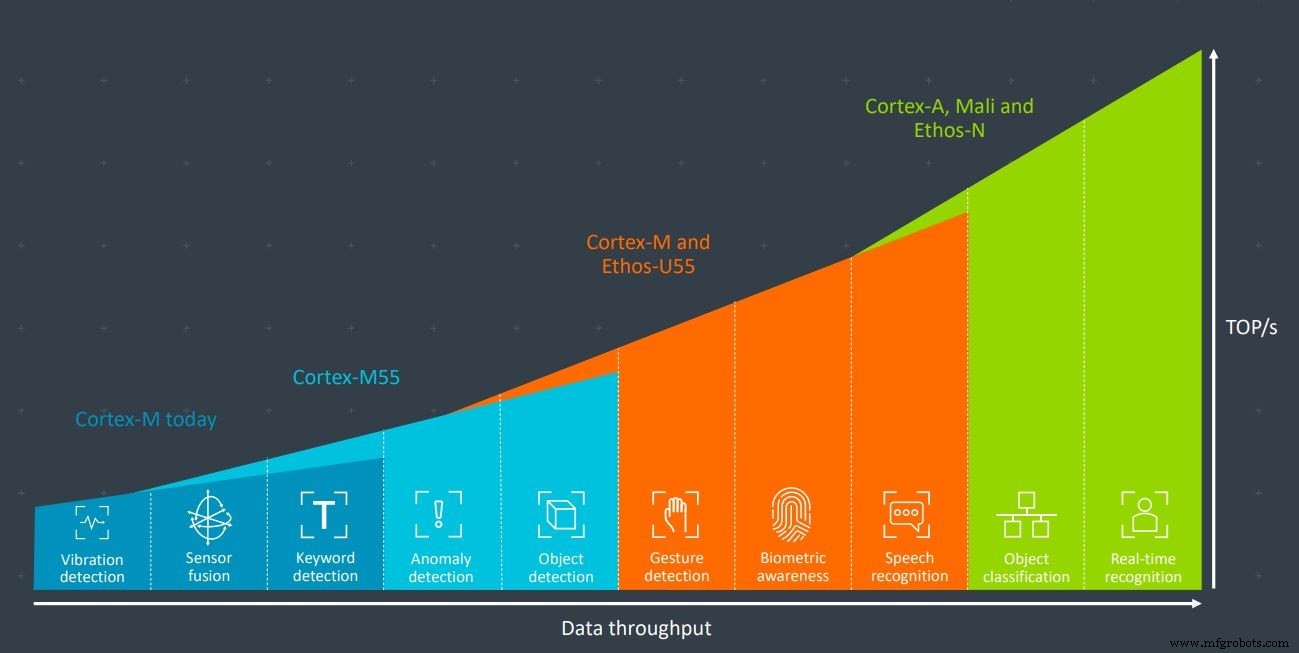
Im Tandem genutzt, haben Arms Cortex-M55 und Ethos-U55 genug Rechenleistung für Anwendungen wie Gestenerkennung, Biometrie und Spracherkennung (Bild: Arm)
Wie können sich kleinere Firmen gegen Arms etabliertes Ökosystem differenzieren?
XMOS CEO Mark Lippett scherzte: „Man kann Arm nicht schlagen, indem man einen weiteren Arm-basierten SoC baut – sie sind darin exzellent. Der einzige Weg ist, architektonische Vorteile einzuführen – sowohl Leistung als auch Flexibilität.“ XMOS' Xcore.ai, ein Crossover-Prozessor für Sprachschnittstellen, illustriert diese Philosophie, auch wenn er nicht direkt mit Mikrocontrollern konkurriert.
Spannungs- & Frequenzskalierung in ultraniedrigenergetischen Chips
Auf dem TinyML Summit enthüllte Eta Compute den ECM3532 – ein ultraniedrigenergetisches Gerät, fähig zu Always-On-Bildverarbeitung und Sensorfusion mit 100 µW Leistungsbudget. Es integriert einen ARM Cortex-M3 Kern und einen NXP CoolFlux DSP Kern; entweder oder beide können ML-Workloads handhaben. Der Schlüsselinovationspunkt des Chips ist die kontinuierliche Skalierung von Taktfrequenz und Spannung für beide Kerne, eliminierend die Notwendigkeit einer Phasenregelschleife (PLL) und drastisch den Stromverbrauch senkend.
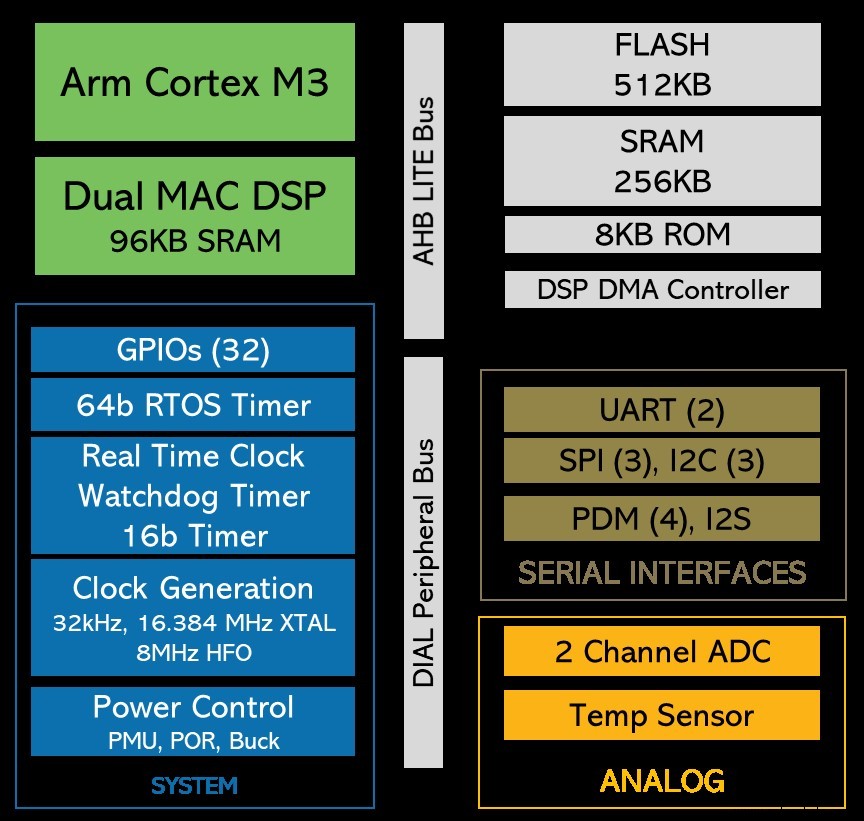
Eta Computes ECM3532 nutzt einen Arm Cortex-M3 Kern plus einen NXP CoolFlux DSP Kern. Die Machine-Learning-Workload kann von entweder oder beiden bearbeitet werden (Bild: Eta Compute)
Mit aufstrebenden Wettbewerbern wie RISC-V, warum wählte Eta Compute einen Arm-Kern für seine ML-Beschleunigung?
Tewksbury erklärte gegenüber EETimes: „Arms Ökosystem ist einfach ausgereifter. Es ist einfacher, ein Produkt mit Arm auf den Markt zu bringen als mit RISC-V derzeit, obwohl sich das entwickeln mag. RISC-V glänzt im chinesischen Markt, aber wir zielen auf heimische und europäische Kunden ab, wo das Arm-Ökosystem am stärksten ist.“
Tewksbury hob hervor, dass AIoT einen breiten, fragmentierten Markt mit zahlreichen Nischenanwendungen mit moderaten Volumen umfasst. Kollektiv könnte der Sektor jedoch Milliarden Geräte umfassen. Er betonte, dass Entwickler die Kosten vermeiden müssen, Lösungen für jeden Use Case maßzuschneidern; Flexibilität und Benutzerfreundlichkeit sind daher kritisch, was Arms Ökosystem bietet.
Letzten Oktober kündigte Arm an, Kunden die Erstellung benutzerdefinierter Instruktionen für spezialisierte Workloads wie ML zu erlauben. Diese Fähigkeit, einmal auf zukünftige Kerne angewendet, könnte den Stromverbrauch weiter reduzieren.
Während der aktuelle M3-Kern von diesem Feature nicht profitieren kann, ist Tewksbury optimistisch: „Absolut, wir planen, Arms benutzerdefinierte Instruktionen in nächsten Generationen zu nutzen, um Energieeffizienz noch weiter zu treiben.“
Aufstrebende ISA-Optionen: RISC-V
RISC-Vs Open-Source-ISA eliminiert Lizenzgebühren und erlaubt Designern, proprietäre Erweiterungen hinzuzufügen. Unternehmen können Kerne auf spezifische Workloads zuschneiden und IP nach Bedarf schützen. GreenWaves, ein französisches Startup, nutzt RISC-V Kerne in seinen GAP8 und GAP9 Chips – 8-Kern- und 9-Kern-Cluster соответственно. Die GAP9-Architektur incorporiert nun 10 RISC-V Kerne.
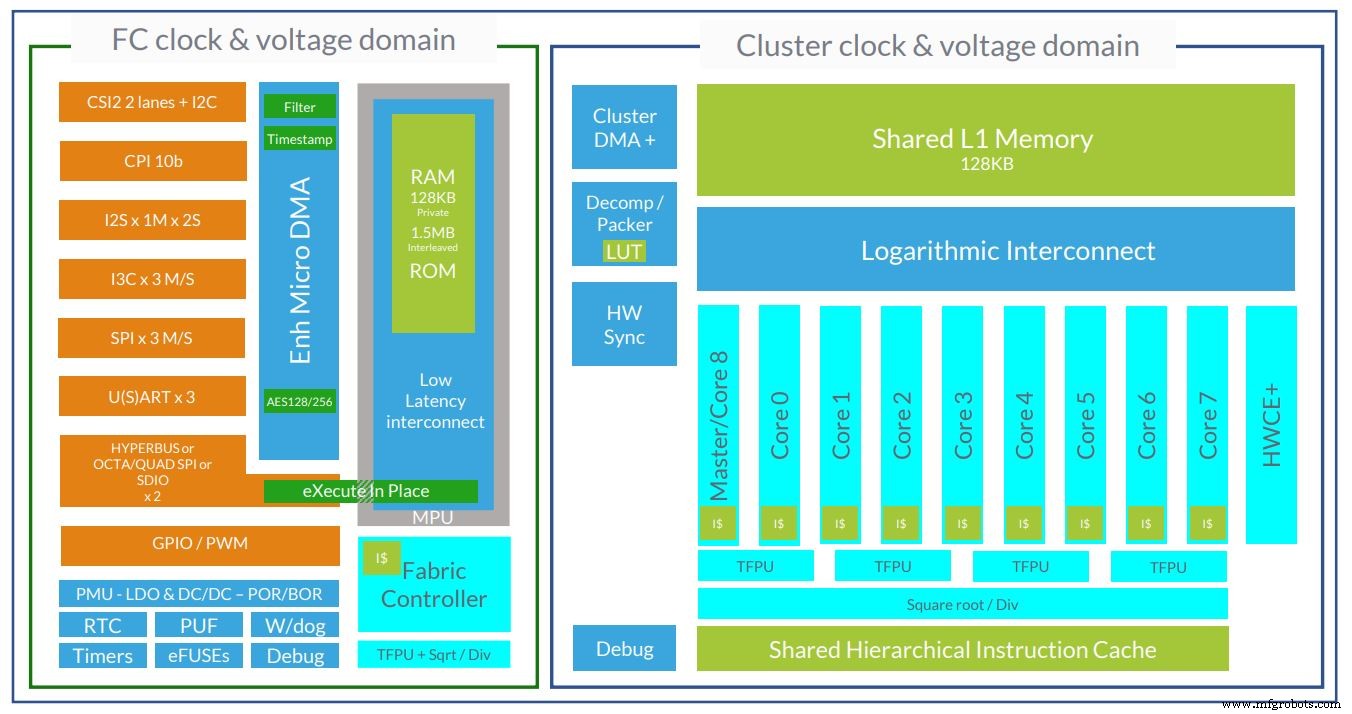
Die Architektur von GreenWaves' GAP9 ultra-low power AI Chip nutzt nun 10 RISC-V Kerne (Bild: GreenWaves)
GreenWaves VP Martin Croome sagte EETimes, dass RISC-Vs Konfigurierbarkeit auf Instruktionsentscheidungsebene ein entscheidender Vorteil sei. Benutzerdefinierte Erweiterungen ermöglichen signifikante Stromreduktionen für ML- und Signalverarbeitungsaufgaben. Für ein neues Unternehmen wäre die Erstellung solcher benutzerdefinierten Kerne auf anderen Architekturen, wo Lizenz- oder IP-Kosten explodieren würden, prohibitiv teuer.
Benutzerdefinierte Erweiterungen allein erzielen eine 3,6× Verbesserung der Energieeffizienz gegenüber unveränderten RISC-V Kernen. Croome lobte auch RISC-Vs modernes, sauberes ISA, das Implementierungskomplexität und damit Stromverbrauch reduziert. Präzise Kontrolle über die Ausführung jedes Kerns ist essenziell für maximale Energieeffizienz – etwas, was RISC-V erleichtert.
Croome erkannte an, dass Arm, wenn es dieselbe Anpassungsfähigkeit bieten könnte, die natürliche Wahl wäre. Allerdings übertrifft Arms ausgereifter Software-Toolchain derzeit RISC-V, obwohl letztere Ökosystem rasant reift.
Zusammenfassend: Während einige Arms Dominanz als erodierend sehen, kontert das Unternehmen durch Ermöglichung benutzerdefinierter Erweiterungen und Entwicklung ML-orientierter Kerne von Grund auf. Sowohl Arm- als auch Non-Arm-Lösungen sind nun für ultraniedrigenergetische KI verfügbar, und da TinyML-Communities weiterhin Modellgrößen schrumpfen und Frameworks verfeinern, ist der Markt zum Blühen bereit.
Eingebettet
- Digitale Schneidlösungen für die Teppichindustrie – OMNI CNC
- Essentieller Checklist für Laser Alignment & Soft Foot Prävention
- Clever kaufen: Ihr Leitfaden für den Kauf gebrauchter CNC-Maschinen
- CNC-Fräsen meistern: 4 unverzichtbare Tipps für Einsteiger
- Umfassender Leitfaden: Gebrauchte CNC-Drehmaschine kaufen – Tipps & Überlegungen
- CNC-Dreher-Sicherheit: Wichtige Arbeitsplatzrichtlinien
- Expertenrat zum Kauf zuverlässiger gebrauchter CNC-Maschinen
- Wie Sie die ideale CNC-Maschine für langfristige Leistung auswählen
- Top Metall-CNC-Maschinen 2024: Effizienz & Präzision maximieren
- High-Precision 2090 CNC-Holzrouter nach Australien – Erfolgsgeschichte