



Anwendungen beschleunigen mit maßgeschneiderten RISC‑V Custom Instructions
Die offene Instruction Set Architecture (ISA) von RISC‑V bietet beispiellose Flexibilität: Entwickler können Extensions designen, die exakt auf ihre Applikationsanforderungen passen. Während der Basisprozessor mit Standard-Extensions konfigurierbar ist, liegt der eigentliche Vorteil in neuen Instruktionen, die spezifische Performance- oder Power-Herausforderungen adressieren.
Die Software-Herausforderung fester ISAs
Historisch waren ISAs proprietäres IP kommerzieller Anbieter. Embedded-Entwickler mussten multiple feste ISAs benchmarken, um die beste Passform für ihre Workloads zu finden – aber die Unfähigkeit, Instruktionssemantik zu ändern, machte kritische Optimierungen (z. B. dedizierte Verschlüsselungsinstruktion) unmöglich. Dies zwang Designer oft, sich allein auf Prozess-Scaling oder Peripherie-Integration zur Differenzierung zu verlassen – kostspielig und zeitlich begrenzt.
Die RISC‑V ISA entstand an der UC Berkeley und wird heute von der RISC‑V International Association (Non-Profit, 300+ Mitglieder) gestewardet. Ihre freie, offene Lizenz gibt Entwicklern eine saubere Basis: einen Standard-Core, der erweiterbar ist, oder ein brandneues Design von Grund auf.
Offene ISAs ziehen Academia, Start-ups und Großunternehmen an. Einsetzbar in FPGAs, SoCs oder als Herz eines Mikrocontrollers, unterstützen sie diverse Business-Modelle – von kommerziellem IP bis Open Source und Custom Silicon.
RISC‑Vs Flexibilität nutzen
Einstieg ist unkompliziert. Typischer Einstiegspunkt: 32-Bit RV32IM-Konfiguration (Integer „I“ + Multiply „M“ Extensions). Simulations-Tools erlauben Instanziierung einer Basis-ISA, Anbindung eines Speichermodells mit realistischen Delays, Ausführung von C/C++-Code auf virtuellem Prozessor.
Mit IDE (z. B. Eclipse) und GNU Debugger (GDB) können Entwickler Applikationen profilieren, Hotspots identifizieren und Kandidaten für Custom Instructions modellieren. Resultierende RTL-Spezifikation und Performance-Schätzungen fließen zurück in den Entwicklungsloop.
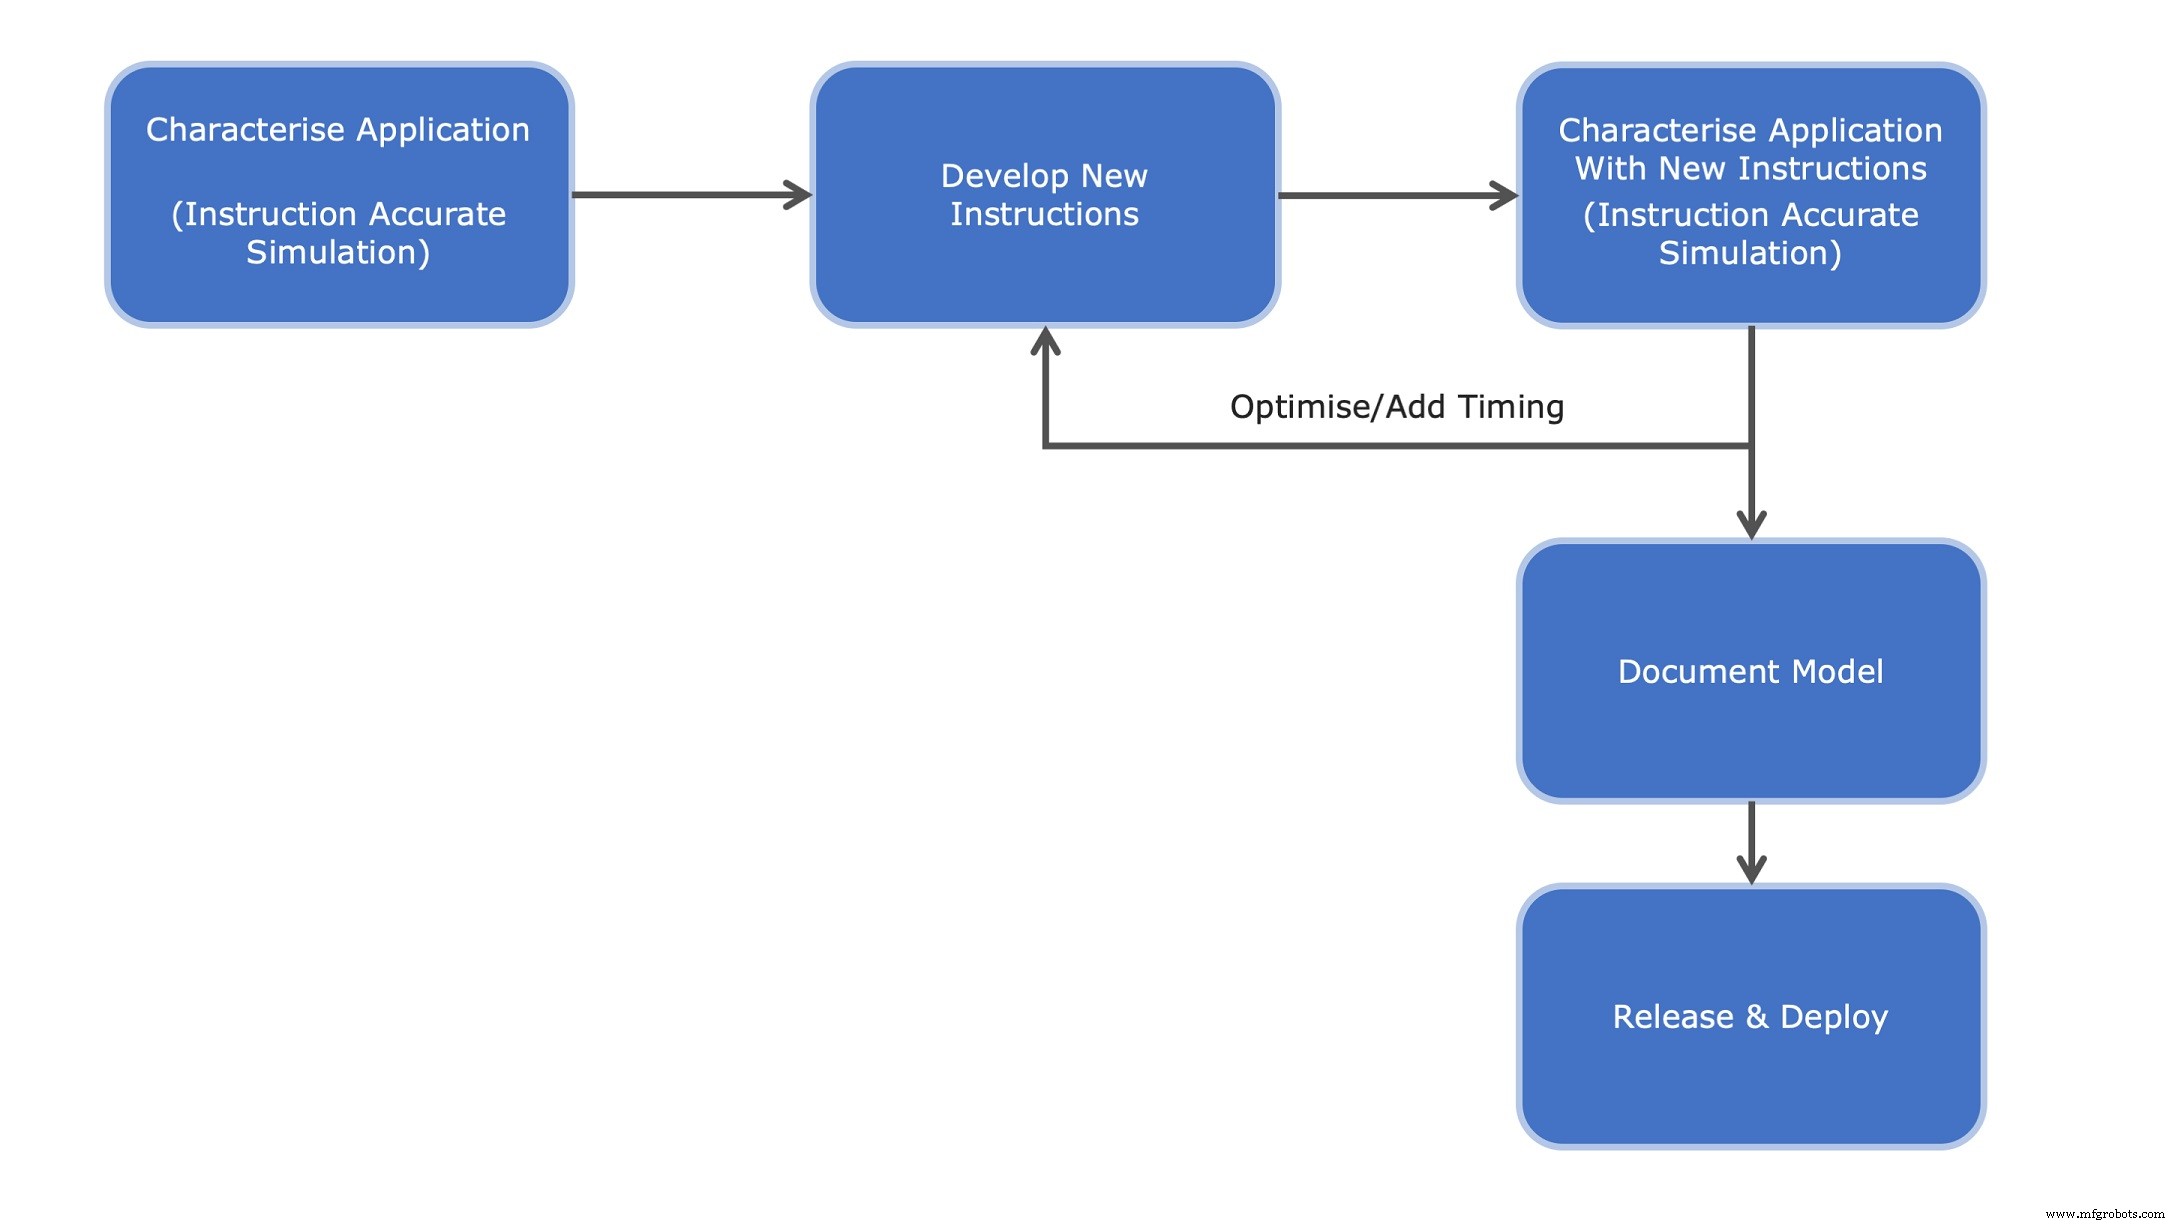
Betrachten wir ChaCha20-Verschlüsselung – gängiger Benchmark in Low-Power-Geräten. Nach Kompilieren eines vanilla RV32IM-Binaries und Ausführen eines Basic-Block-Profilers konzentriert sich die meiste Ausführungszeit in XOR- und Rotate-„Quarter-Round“-Operationen (Abb. 2).

Visualisierungstools erzeugen einen einklappbaren Baum aus Ausführungsstatistiken – dominante Funktionen wie processWord() und ihre Sub-Calls leicht erkennbar (Abb. 3).

Ist der Performance-Flaschenhals klar, designen wir Custom Instructions, die das XOR-plus-Rotate-Muster in eine einzelne Micro-Operation konsolidieren. Da RISC‑V Load-Store-Architektur ist, operieren diese Instruktionen auf 32-Bit-Registern – passend für den custom-1 Opcode-Space.

Mit den ISA-Encoding-Regeln identifizieren die unteren sieben Bits den Opcode, drei funct3-Bits geben Raum für acht distinkte Operationen. Vier davon – XOR plus 7-, 8-, 12- oder 16-Bit-Linksrotation – genügen für ChaCha20.
Vor Hardware-Commitment modellieren wir diese Instruktionen in der ISS-Umgebung mittels OVP VMI API. Dieser schnelle Simulationsschritt verifiziert funktionale Korrektheit und gibt ersten Performance-Gewinn-Einblick.
Zwei Ansätze für funktionale Validierung:
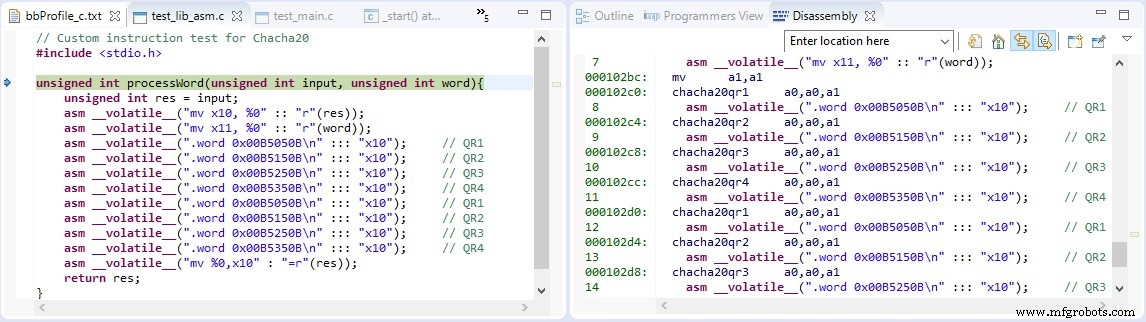
- Original C/C++-Routine aufrufen und neue Instruktionen via Inline-Assembly binden (Abb. 5a).
- Instruktionen als VMI Morph Ops implementieren, die dasselbe Verhalten reproduzieren (Abb. 5b).


Nach Rekompilieren mit Inline-Assembly berichtet der Simulator drastische Reduktion in Instruktionsanzahl und Zykluszeit:
Ergebnisse mit Original C-Implementation
Info Simulated instructions: 316.709.013
Info Simulated time: 5,15 Sekunden
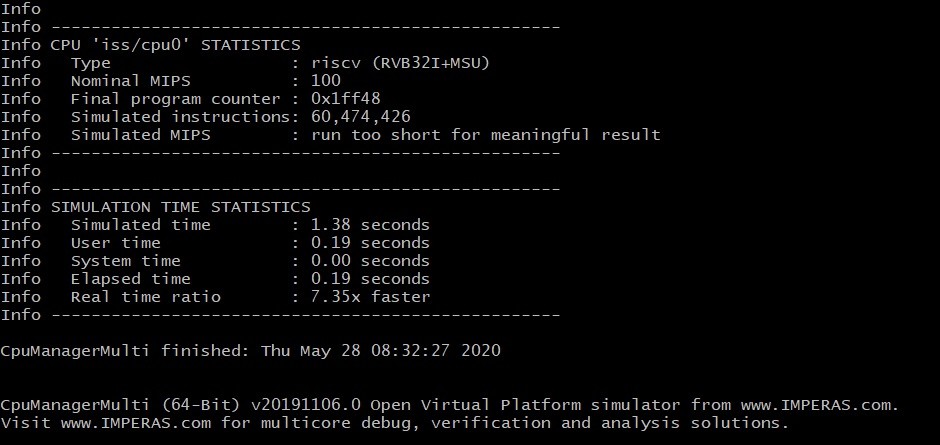
Ergebnisse mit Custom Instructions
Info Simulated instructions: 60.474.426
Info Simulated time: 1,38 Sekunden
Mit den neuen Instruktionen verbraucht processWord() noch ~66 % der Runtime, aber der Gesamtalgorithmus ist nun dreimal schneller.
Weitere Verfeinerung: Realistische Zyklus-Latenzen je Custom Instruction zuweisen und Re-Profiling inkl. Memory Wait States, die in Silizium auftreten würden.
Da ISS nahtlos mit Eclipse und GDB integriert ist, kann vollständiges Debugging sowohl der Host-Applikation als auch der Custom ISA vor Hardware-Commitment durchgeführt werden.
Von Simulation zur RTL-Implementierung
Mit validierten Performance-Metriken übersetzen Entwickler Custom Instructions in RTL. Das zuvor generierte funktionale Modell und der Verifikationsplan dienen als Goldstandard-Referenz, reduzieren Risiko bei Synthese und Timing Closure.
Dokumentation folgt demselben Workflow: OVP Fast-Processor-Modelle beinhalten templatierte Dokumentation, erweiterbar für neue Instruktionen. Einmal in TeX formatiert, wird PDF für Community-Referenz generiert (Abb. 8).

Fazit
RISC‑Vs offene ISA erschließt eine Welt Custom Extensions, die Applikationsperformance dramatisch verbessern, Power-Verbrauch senken und harte Echtzeit-Deadlines erfüllen können – Fähigkeiten, die feste ISAs nicht bieten. Durch Profiling realer Workloads, Modellieren Custom Instructions in Simulation und rigorose RTL-Verifikation können Entwickler maßgeschneidertes Silizium mit bewiesenen Gewinnen selbstbewusst in den Markt bringen.
Eingebettet
- Verteilte Applikationen mit Linux perf profilieren: Ein praktischer Leitfaden
- Binder Jetting 3D-Druck: Funktionsweise, Vorteile und Best Practices
- Microchip bringt Arm-basierte MCUs für skalierbare Weltraummissionen – von COTS bis strahlungstolerant und gehärtet
- Renesas bringt RX72M MCUs mit integriertem EtherCAT für Industrial Automation
- Axiomtek tBOX400-510-FL: Dual-Processor Transport PC mit integriertem 10-Port Managed PoE Switch
- Kostenverhandlungen mit bestehenden Lieferanten meistern – Ein praktischer Leitfaden
- CNC-Holzrouter: Vielseitige Präzision für Möbel, Türen & mehr
- KI in der Versicherung: Ein praxisnaher Starter-Guide für die reale Umsetzung
- KI in der Medizin: 5 bewährte reale Anwendungen mit praktischen Beispielen
- Maßgefertigte Bremsschuhe & -beläge: Sicherheit im Hochgeschwindigkeitszugverkehr