



Mikrocontroller treiben die nächste Welle von Edge AI an
Bis vor kurzem wurde Machine Learning – und sogar Deep Learning – als Domäne mächtiger Server betrachtet, mit Training und Inference handled by Gateways, Edge Servern oder Data Centers. Diese Sicht hielt, weil der Shift toward Distributing Computation zwischen Cloud und Edge noch nascent war. Heute haben Breakthroughs aus Industrie und Academia dieses Paradigma shifted.
Konsequenterweise sind High-Performance Prozessoren, die Trillionen Operations per Second (TOPS) liefern, keine Prerequisite mehr für ML Workloads. Moderne Mikrocontroller, viele ausgestattet mit dedizierten ML Accelerators, bringen nun Intelligent Inference direkt zu Edge Devices.
Diese Controller execute ML Tasks effizient, bei minimalem Cost und Power, connecting zur Cloud nur when needed. Im Wesentlichen markieren Mikrocontroller mit Embedded ML Accelerators den nächsten Sprung in der Befähigung von Sensoren – Mikrofonen, Kameras, Environmental Monitoren – mit On-Device Intelligence, dem Cornerstone der IoT Value Chain.
Wie tief ist der Edge?
Der Edge wird commonly defined als der fernste Punkt von der Cloud in einem IoT Network, oft represented by einem Advanced Gateway oder Edge Server. In Realität terminiert der Edge an den Sensoren selbst – jenen positioniert nah am End User. Es ist daher logisch, so viel Analytics wie möglich direkt in diesen Sensoren einzubetten, eine Rolle, für die Mikrocontroller perfekt suited sind.
Single-Board Computers können indeed Edge Processing performen, delivering Impressive Performance und, when clustered, approaching Small-Scale Supercomputers. Doch sie bleiben zu bulky und expensive für die Tausende Units, demanded by Large-Scale Deployments. Zudem benötigen sie External DC Power – oft unavailable in Constrained Environments – wohingegen ein MCU nur Milliwatts zieht und auf Coin-Cell Batterien oder wenigen Solar Cells operieren kann.
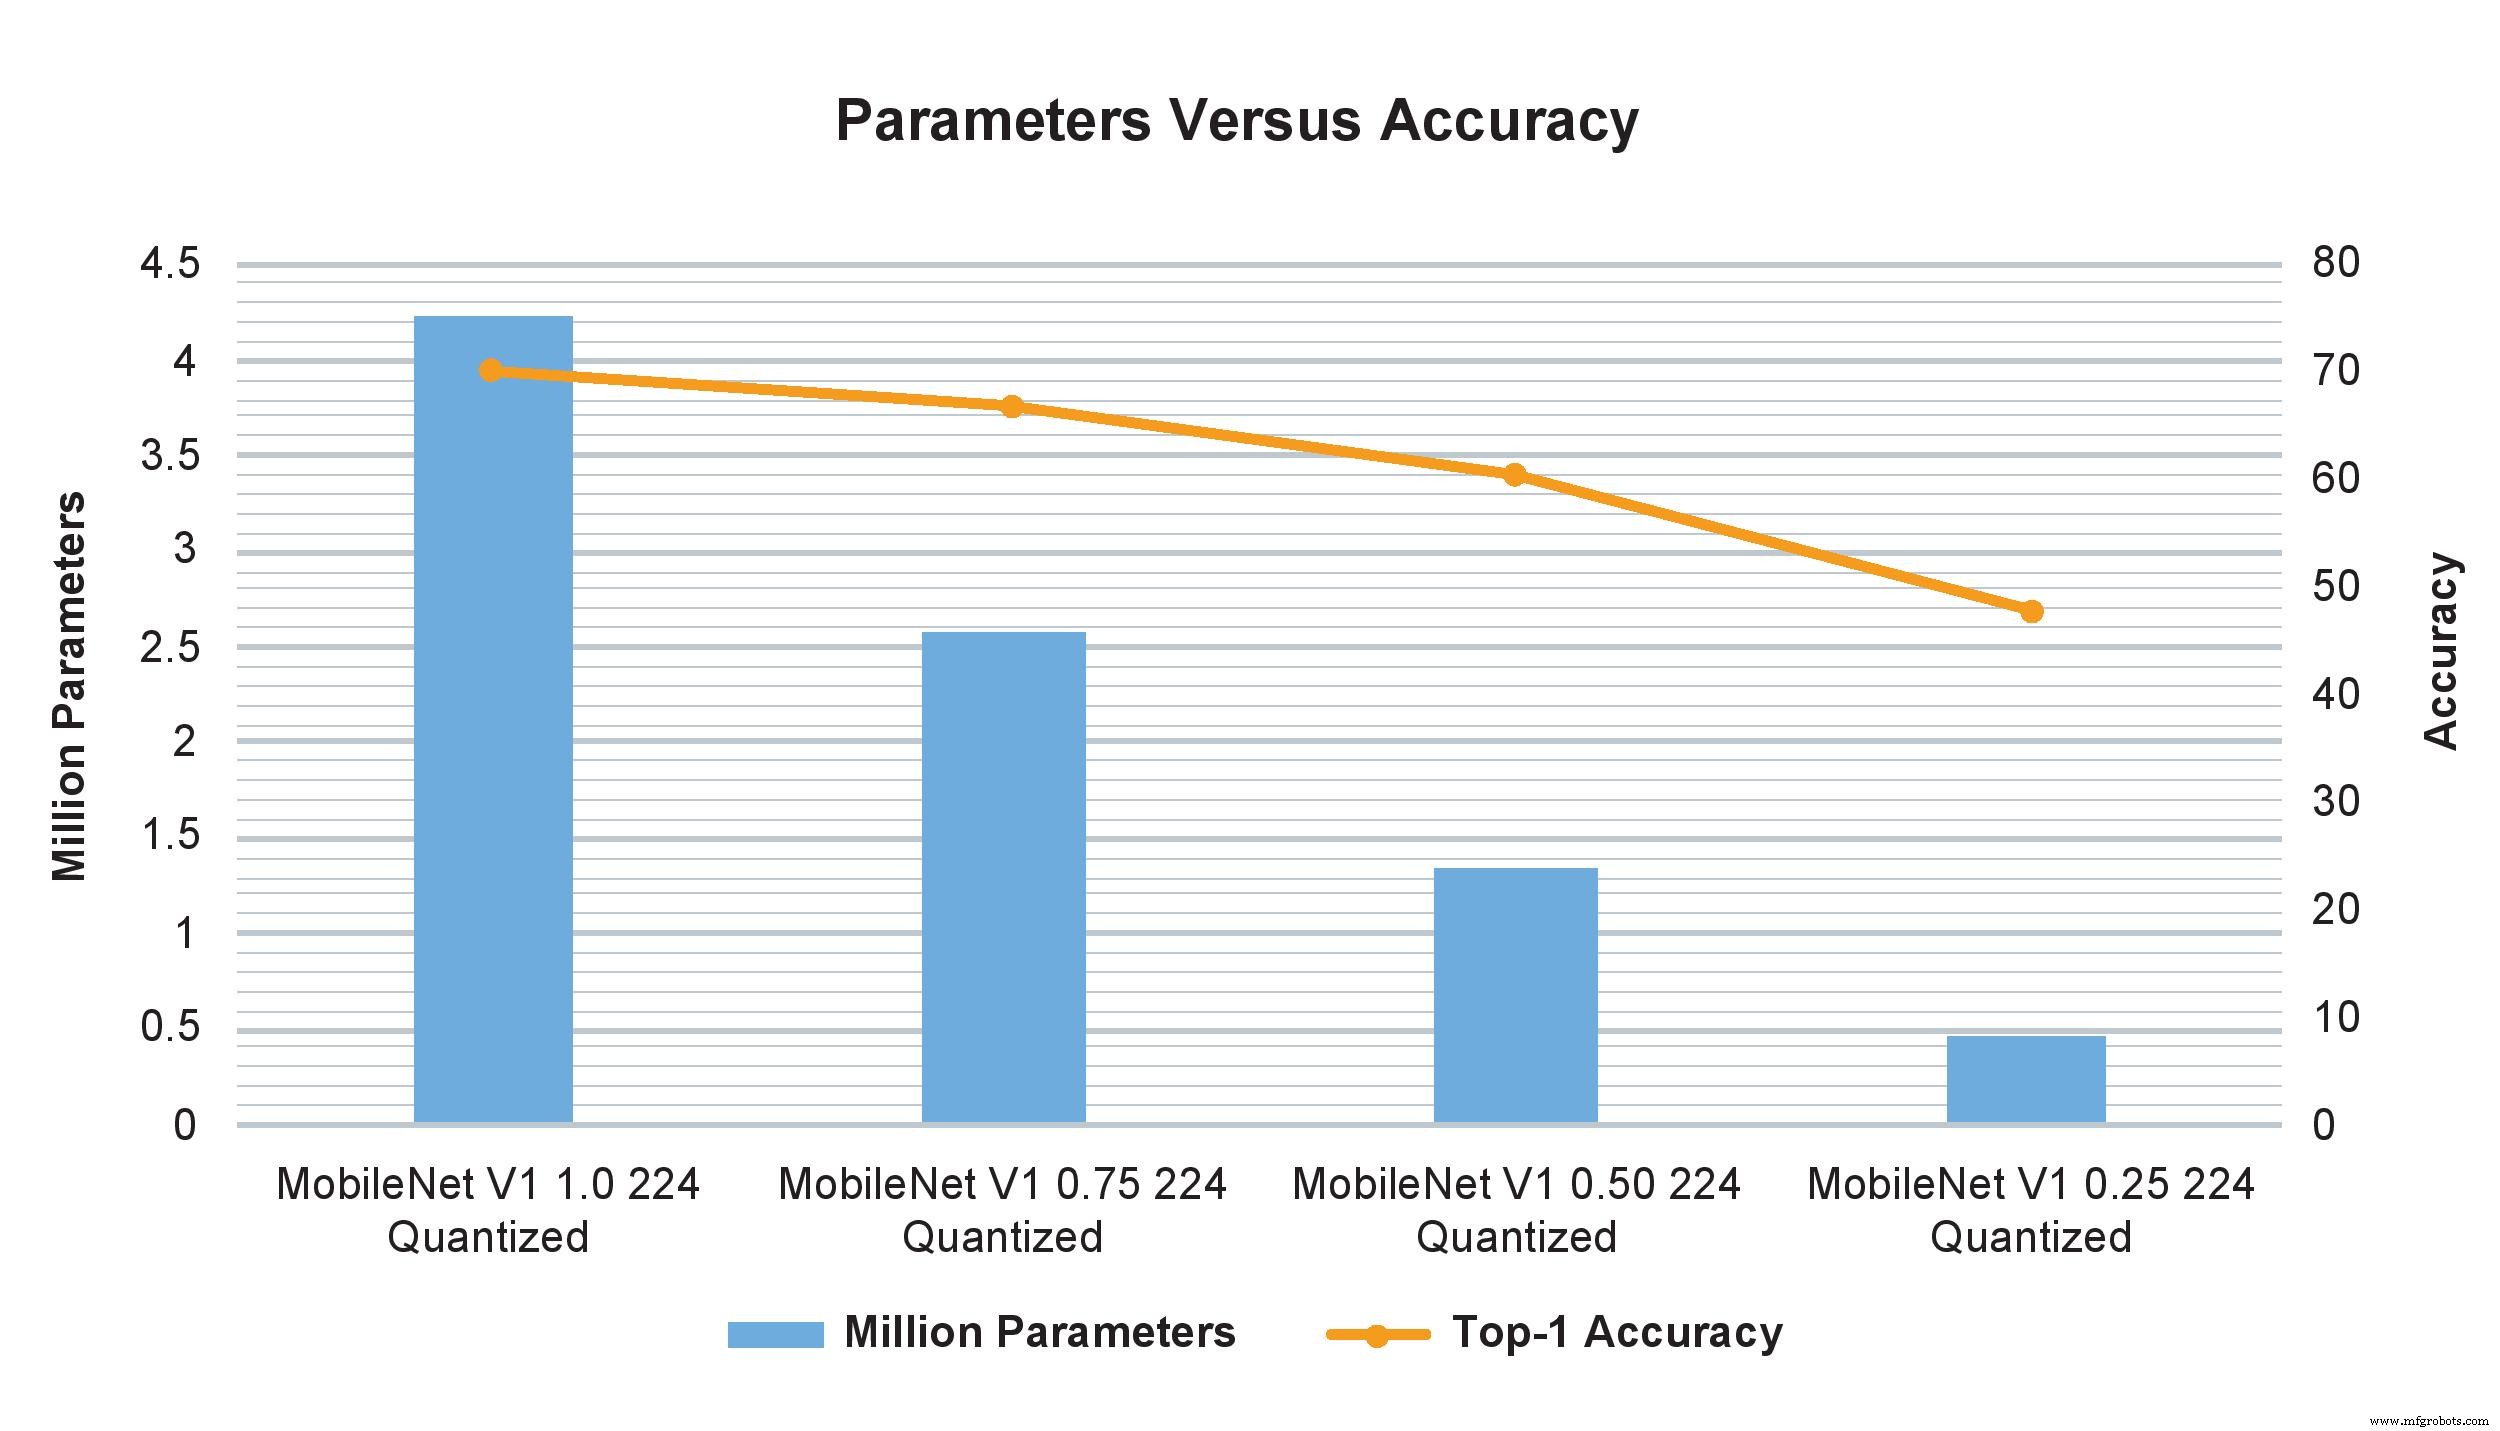
Konsequenterweise hat das Feld Microcontroller-Based Edge ML – bekannt als TinyML – an Popularität exploded. TinyML aims to enable Inference, und eventualmente Training, auf Small, Low-Power, Resource-Constrained Devices, particularly Mikrocontrollern, statt auf größeren Platformen oder der Cloud zu rely. Dies necessitates Compact Neural Network Models, die innerhalb limitierter Processing, Storage und Bandwidth Budgets fit während Performance preserved wird.
Resource-Optimized Models enable Devices, adequate Sensor Data für ihre Tasks zu capture während Fine-Tuning Accuracy und Reducing Resource Demands. Konsequenterweise, obwohl einige Data noch transmitted werden mögen – direkt zur Cloud oder via Edge Gateway – ist das Volumen signifikant niedriger, weil Preliminary Analysis bereits auf dem Device executed wurde.
Ein Common TinyML Use Case ist ein Camera-Based Object-Detection System, das High-Resolution Images capture kann, doch Limited Storage faces, necessitating Resolution Reduction. Mit On-Device Analytics captured die Kamera nur Objects of Interest, preserving Higher Resolution für Selected Frames. Dieses Level von Funktionalität – einst reserved für Powerful Hardware – ist jetzt auf Mikrocontrollern achievable dank TinyML.
Small but Mighty
Obwohl TinyML ein nascent Field ist, delivers es bereits Impressive Inference – und zunehmend Training – Performance auf Modest Mikrocontrollern, mit Negligible Accuracy Loss. Recent Successes spannen Voice und Facial Recognition, Voice-Command Natural Language Processing, und Simultaneous Execution multiple Sophisticated Vision Algorithmen.
Praktisch kann ein Mikrocontroller, priced under $2, featuring einen 500-MHz Arm Cortex-M7 Core und 28 KB–128 KB Memory, die Performance liefern, necessary um Sensoren truly Intelligent zu machen.
Even at diesem Cost incorporieren solche Mikrocontroller Robuste Security Features (AES-128), Support Multiple External Memory Types, Ethernet, USB, SPI, und Interfaces für Range von Sensoren, inklusive Bluetooth, Wi-Fi, SPDIF, und I²C Audio. Ein Modest Price Increase yielded typically einen 1-GHz Cortex-M7, 400-MHz Cortex-M4, 2 MB RAM, und Graphics Acceleration, all while Drawing nur wenige Milliamps von 3,3 V Supply.
Ein paar Worte zu TOPS
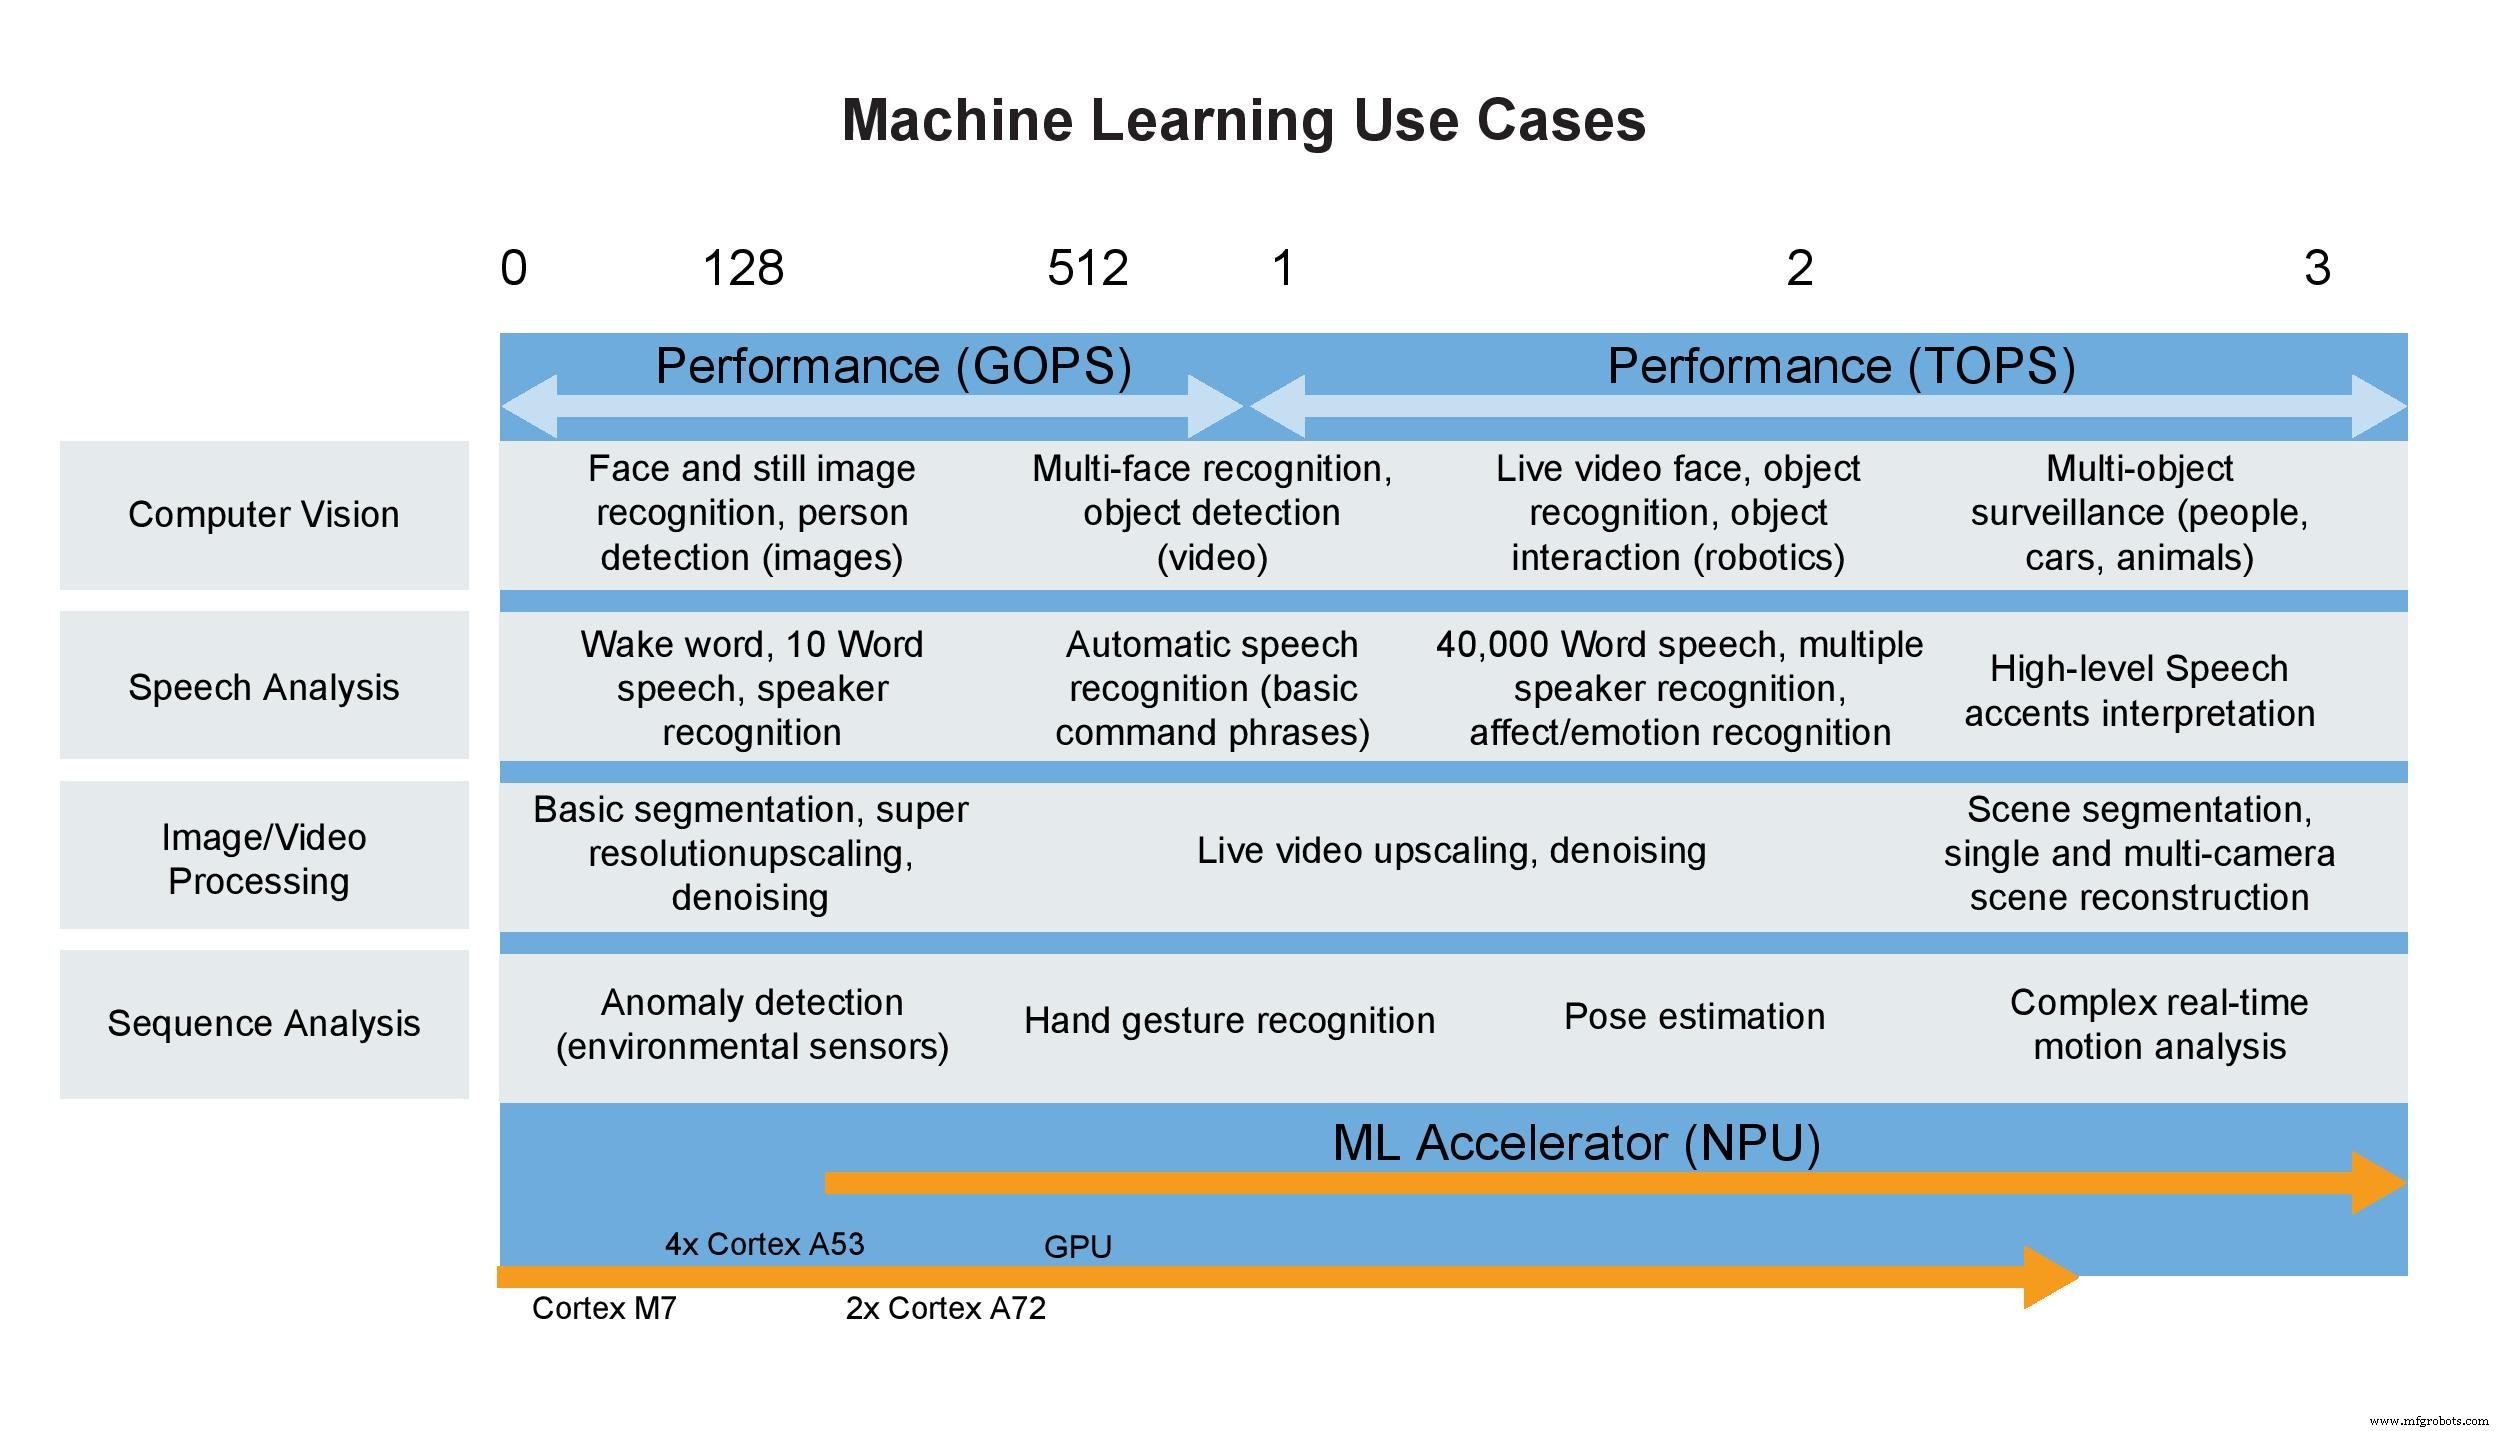
Hersteller benchmarken Neural Network Accelerators oft using a Single Metric – Trillions of Operations per Second (TOPS). Während attraktiv, kann diese Figure misleading sein. Sie reflektiert Raw Computational Capacity in Controlled Lab Setting und ignores Practical Constraints wie Memory Bandwidth, CPU Overhead, und Data Pre- und Post-Processing. In Real Deployments kann Achievable Throughput 50–60 % des Advertised TOPS Value sein.
Zudem, für Mikrocontroller, die typischerweise nur 1–3 TOPS bieten, ist die Metric sogar weniger Informative. Die Real Power dieser Tiny Devices liegt in ihren Tightly Integrated Arm Cortex Prozessoren, Support für Integer und Floating-Point Operations, und Ability, Inference Engines wie TensorFlow Lite mit Minimal Footprint zu runnen.
Fazit
Der Push, Inference direkt auf oder adjacent zu Sensoren zu runnen – ob Still oder Video Kameras – accelerates, as das IoT Ecosystem toward Edge-Centric Processing moved. Rapid Advances in Mikrocontroller-Level Neural Network Accelerators konsolidieren AI Funktionalität mit Application Prozessoren ohne dramatischen Rise in Power Consumption oder Size. Models trained auf Powerful CPUs oder GPUs können mit TensorFlow Lite geslimmt und zu Mikrocontrollern deployed werden, Scaling Effortlessly to Meet Growing ML Demands. Bald wird sogar Training auf diesen Devices feasible sein, positioning Mikrocontroller als Formidable Competitors zu Larger, Costlier Systems.
>> Dieser Artikel wurde ursprünglich auf unserer Schwesterseite EE Times veröffentlicht.
Eingebettet
- Wie Cloud Computing KI-Innovation antreibt und Business-Effizienz steigert
- Wie Embedded Systems moderne Fahrzeuginnovation antreiben
- Vapor-Chamber Cooling: Wachsende Lösung für High-Heat Elektronik
- RF Energy Harvesting treibt Expansion KI-gestützter Wireless-Applikationen an
- USB-Cs wachsende Rolle im Power Management für Wearables und Mobile Devices
- Murata & Google präsentieren kleinstes Edge TPU KI-Modul: 4 TOPS in 10×15×1,5 mm Chip
- ECM3532: Eta Computes erstes integriertes Ultra-Low-Power KI Sensor Board beschleunigt Edge Development
- ADLINK launcht NEON‑1000‑MDX: Turnkey Edge AI Smart Camera für schnelles Industrial Vision Deployment
- Roboter treiben Industrie 4.0 auf der NPE voran
- Wie Edge Computing kommerzielle IoT-Deployments revolutioniert