



BrainChip bringt Akida neuromorphe Entwicklungs-Kits für Edge KI
BrainChip, ein führender Anbieter von neuromorpher Computing-IP, stellte auf der jüngsten Linley Fall Processor Conference zwei neue Entwicklungs-Kits vor, die seinen Akida neuromorphen SoC enthalten. Die Kits gibt es im x86 Shuttle PC-Format und als Arm-basiertes Raspberry Pi Design, was Entwicklern sofort einsatzbereite Plattformen für das Erstellen und Testen von Spiking Neural Network (SNN) Applikationen bietet. Akida Silizium ist auch für die Integration in kundenspezifische Designs verfügbar.
Akidas neuromorphe Architektur liefert ultra-energiesparende KI, indem sie die ereignisgesteuerte Verarbeitung des Gehirns nachahmt. Im Gegensatz zu herkömmlichen Deep-Learning-Modellen übertragen SNNs Information durch diskrete Spikes, die sowohl räumliche Muster als auch zeitliche Sequenzen kodieren. Diese Ereignisdomäne ist ideal für Edge-Geräte, die Echtzeit-, strombewusste Inferenz aus Sensordatenströmen benötigen.
Zusätzlich zu nativen SNN-Workloads können BrainChips Neural Processing Units (NPUs) Convolutional Neural Networks (CNNs) nach Konvertierung in die Ereignisdomäne ausführen. Die Konvertierung, durchgeführt vom MetaTF Software-Flow, bewahrt CNN-Feature-Extraktion und ermöglicht On-Chip-Lernen durch Spike-Timing-Dependent Plasticity – wodurch Cloud-basiertes Neutrainieren entfällt.
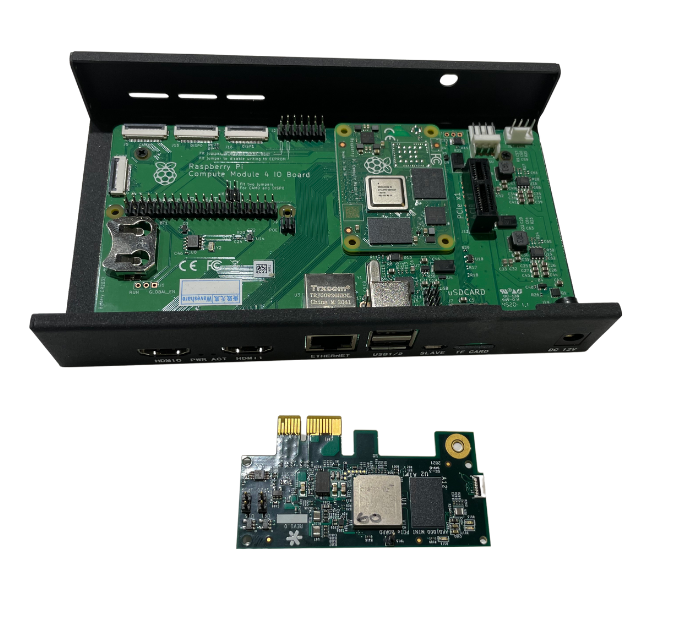
BrainChips Entwicklungsboards sind für x86 Shuttle PC oder Raspberry Pi verfügbar. (Quelle: BrainChip)
„Akida ist bereit für die neuromorphe Technologie von morgen, löst aber schon heute Edge-KI-Herausforderungen“, sagte Anil Mankar, BrainChip Mitgründer und Chief Development Officer, gegenüber EE Times. „Unsere Runtime-Software entfernt die Lernkurve um SNNs und die Ereignisdomäne, sodass Entwickler, die mit TensorFlow oder Keras vertraut sind, Modelle portieren und Leistung und Genauigkeit direkt auf unserer Hardware evaluieren können.“
Mankar erklärte, dass CNNs bei der Feature-Extraktion aus großen Datensätzen glänzen. Durch Konvertierung von CNN-Layern in ereignisbasierte Operationen – außer der finalen Klassifikationsschicht – behält Akida diese Fähigkeit bei und fügt Spike-Timing-Lernen hinzu. Native SNNs können Ein-Bit-Präzision nutzen, während konvertierte CNNs typischerweise 1-, 2- oder 4-Bit-Spikes verwenden. BrainChips Quantisierungstool hilft Designern, die passende Bitbreite pro Layer zu wählen. Beispielsweise erreichte ein MobileNet V1 Modell, quantisiert auf 4 Bit, 93,1 % Genauigkeit bei einer 10-Klassen-Klassifikationsaufgabe.
Die Konvertierung in die Ereignisdomäne bringt auch signifikante Stromersparnisse durch Sparsity. In der Ereignisdomäne generieren nur nicht-null Aktivierungswerte Spikes, und die NPU verarbeitet nur diese Events. Bei einem typischen CNN sind nach ReLU ungefähr die Hälfte der Aktivierungen null, sodass die ereignisbasierte Implementierung die Anzahl der MAC-Operationen drastisch reduziert und den Stromverbrauch senkt.
Funktionen wie Faltung, Pointwise-Faltung, Depthwise-Faltung, Max-Pooling und Global Average Pooling können alle in die Ereignisdomäne übersetzt werden. Das folgende Diagramm veranschaulicht die Reduktion der MAC-Operationen für eine Objektklassifikationsaufgabe: Dunkelblau repräsentiert das traditionelle CNN, Hellblau die ereignisdomänenbasierte Akida-Implementierung, Grün zeigt weitere Aktivitätsregularisierung.
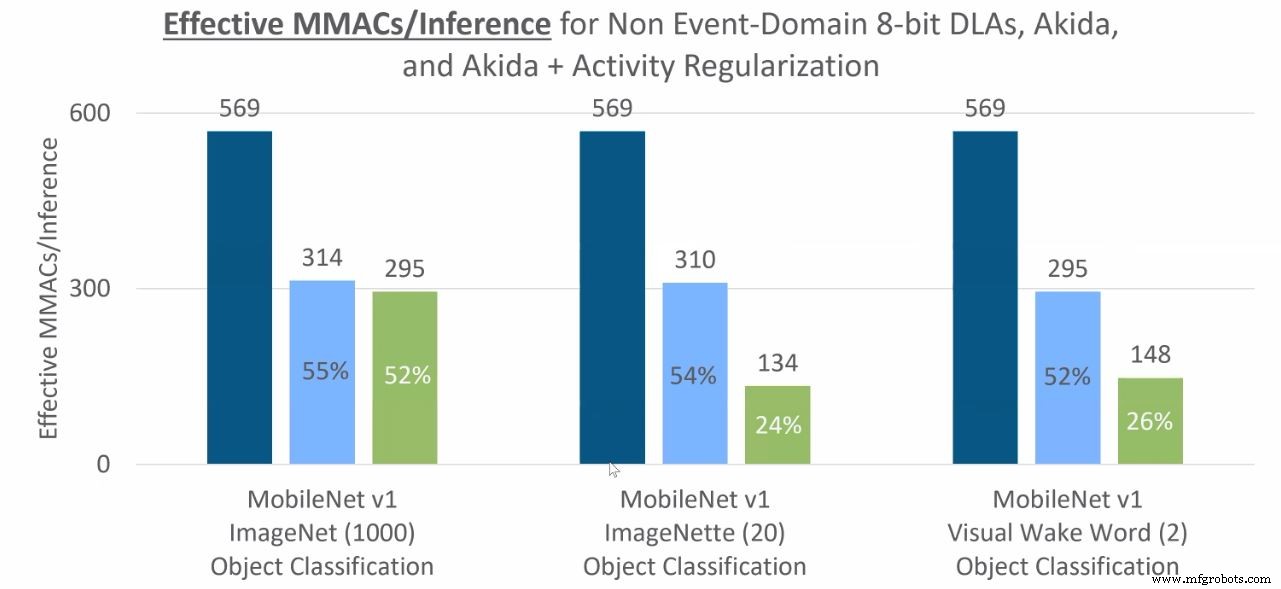
MAC-Operationen für Objektklassifikations-Inferenz (dunkelblau: CNN in Nicht-Ereignisdomäne, hellblau: Ereignisdomäne/Akida, grün: Ereignisdomäne mit weiterer Aktivitätsregularisierung). (Quelle: BrainChip)
In einem realen Benchmark verbrauchte ein Keyword-Spotting-Modell, das auf dem Akida-Board nach 4-Bit-Quantisierung lief, nur 37 µJ pro Inferenz (entsprechend 27.336 Inferenzen pro Sekunde pro Watt). Das Modell erreichte 91,3 % Genauigkeit bei bescheidenen 5 MHz Taktfrequenz.
Sensor-agnostisch
BrainChips NPU IP und Akida Chip sind netzwerk-agnostisch und unterstützen eine breite Palette von Sensoren. Ob Bild-, Audio-, olfaktorische, gustatorische oder taktile Daten verarbeitet werden – dieselbe Hardware kann sowohl CNNs (via Konvertierung) als auch native SNNs handhaben.
Jeder NPU-Knoten enthält 100 kB lokalen SRAM für Parameter, Aktivierungen und Event-Buffer, und bis zu vier Knoten können zu einem Mesh-Netzwerk geclustert werden. Netzwerke, die mehrere Knoten umspannen, kommunizieren direkt zwischen Layern ohne CPU-Eingriff, obwohl bestimmte Non-CNN-Workloads weiterhin CPU-Unterstützung benötigen. Das IP kann auf 20 Knoten skaliert werden, was größere Modelle in mehreren Durchläufen auf kleinerer Hardware ermöglicht.
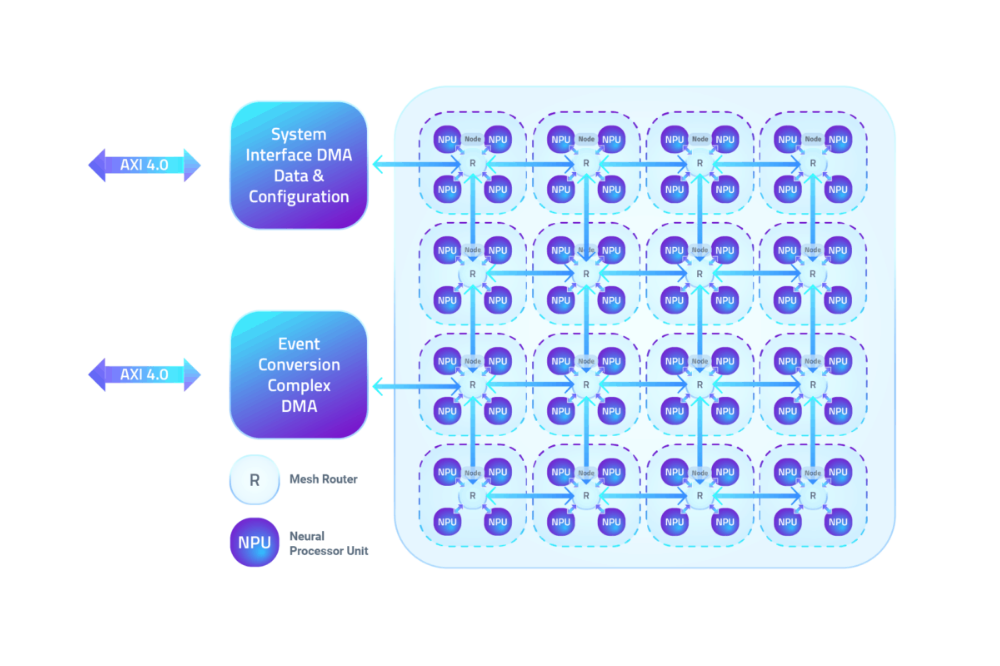
Vier BrainChip NPU-Knoten sind durch ein Mesh-Netzwerk verbunden. (Quelle: BrainChip)
Ein Demo-Video zeigte Akida in einer Fahrzeugkabine: Ein Chip detektierte gleichzeitig den Fahrer, erkannte dessen Gesicht und identifizierte dessen Stimme. Keyword Spotting benötigte nur 600 µW, Gesichtserkennung 22 mW und visuelles Wake-Word-Inferenz 6–8 mW – was die Eignung des Chips für automotives Edge-KI demonstriert.
Rob Telson, BrainChips Vice President of Worldwide Sales, merkte an, dass Akidas 28-nm TSMC-Prozess eine starke Basis bietet und IP-Kunden zu feineren Knoten für noch größere Energieeffizienz wechseln können. Er hob auch On-Chip-Lernen für Gesichtserkennung hervor: Mit ausreichend Neuronen in der finalen Schicht kann ein System von der Erkennung von 10 Gesichtern auf über 50 mit One-Shot-Lernen wachsen, wodurch Cloud-Abhängigkeit entfällt.
Early-Access-Kunden
BrainChip beschäftigt 55 Mitarbeiter an seinem Hauptsitz in Aliso Viejo, CA, und Designbüros in Toulouse, Frankreich; Hyderabad, Indien; und Perth, Australien. Das Unternehmen hält 14 Patente, wird an der australischen Börse gehandelt und ist auf dem US-OTC-Markt gelistet.
Frühzugangskunden umfassen NASA, Automobil-, Militär-, Luft- und Raumfahrt-, Medizin- (z. B. olfaktorische COVID-19-Detektion) und Consumer-Electronics-Firmen. Renesas hat ein 2-Knoten Akida NPU IP für die Integration in zukünftige Mikrocontrollereinheiten lizenziert, die auf Sensordatenanalyse in IoT-Einsätzen abzielen.
Akida IP und Silizium sind jetzt verfügbar.
>> Dieser Artikel wurde ursprünglich auf unserer Schwesterseite EE Times veröffentlicht.
Verwandte Inhalte:
- Startup packt 1000 RISC-V Kerne in KI-Beschleuniger-Chip
- KI-Chip zielt auf Low-Power Edge-Geräte ab
- KI-fähige SoCs handhaben multiple Videostreams
- Sicherheit in KI-SoC durch CPU-Features mit Extensions aufbauen
- Mikrocontroller-Architekturen entwickeln sich für KI weiter
Für weitere Embedded-Inhalte abonnieren Sie den wöchentlichen E-Mail-Newsletter von Embedded.
Eingebettet
- Warum Linux die Cloud antreibt: Ein umfassender Leitfaden
- 10 essenzielle Cloud Computing Vorteile für moderne Unternehmen
- Cloud Computing vs. On-Premise: Welche Infrastruktur passt am besten zu Ihrem Unternehmen?
- Event Flag Groups in Nucleus SE: Einführender Guide zu Konfiguration und API Usage
- Neuromorphe Chips: Die nächste Frontier für AI Performance
- Kontron enthüllt COM HPC: Neuer High-Performance Embedded Computing Standard
- STMicroelectronics launcht $99 LoRa Development Kits für Rapid IoT Deployment
- RSL10 Mesh Development Kit befähigt Ultra-Low-Power BLE Netzwerke
- ams stellt NanoVision und NanoBerry Kits mit 1 mm × 1 mm NanEyeC Sensor vor
- C# Events: Behandlung von Benutzeraktionen und Systembenachrichtigungen