



XML Parsing in Python meistern: Praktischer Guide mit Minidom und ElementTree
Was ist XML?
XML (eXtensible Markup Language) wurde entwickelt, um strukturierte Daten effizient zu speichern und zu transportieren. Es wird breit für Informationsaustausch zwischen Systemen und Anwendungen genutzt.
Python stellt robuste Bibliotheken für Parsing und Manipulation von XML-Dokumenten bereit. Allerdings muss zum Parsen einer XML-Datei das gesamte Dokument zunächst in den Speicher geladen werden. In diesem Tutorial demonstrieren wir, wie Pythons xml.dom.minidom und xml.etree.ElementTree Module verwendet werden, um XML-Dateien zu lesen, zu inspizieren und zu modifizieren.
Am Ende dieses Guides können Sie:
- XML mit
minidomparsen - Neue XML-Nodes erstellen
- XML mit
ElementTreeparsen
XML mit minidom parsen
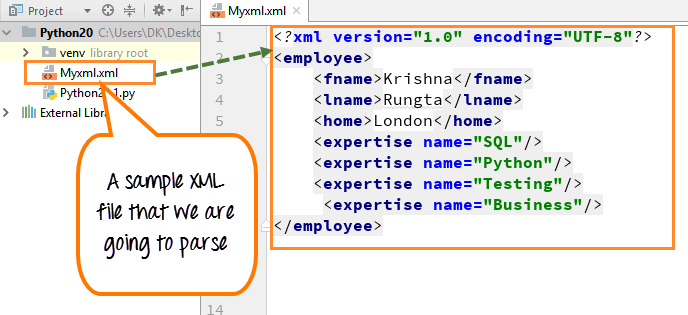
Wir starten mit einer XML-Beispieldatei, die Employee-Daten enthält. Die Datei sieht so aus:
Schritt 1) Die Datei listet Vorname, Nachname, Wohnort und Expertise-Bereiche wie SQL, Python, Testing und Business eines Mitarbeiters.
Schritt 2) Nach Laden des Dokuments geben wir den nodeName des Root-Elements und den tagName seines ersten Childs aus. Das sind Standard-Properties eines DOM-Objekts.
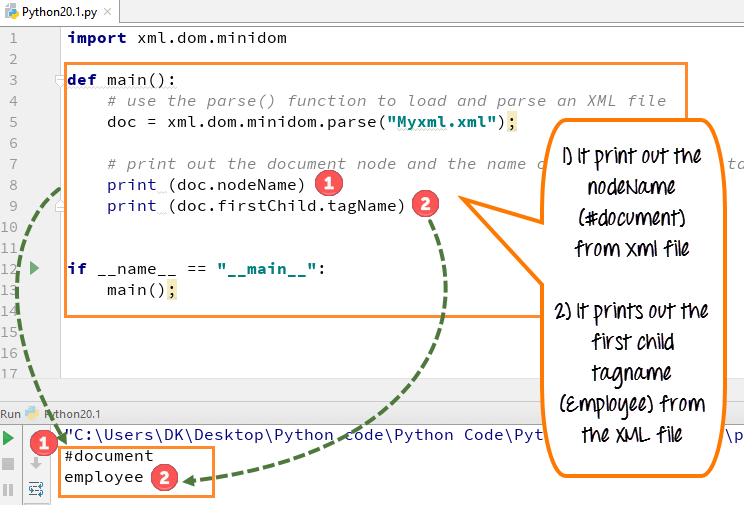
xml.dom.minidomimportieren und XML-Datei (myxml.xml) laden.- Datei mit
parse()parsen, um Document-Objekt zu erhalten. - Dokuments
nodeNameund ersten Child'stagNameabrufen und anzeigen. getElementsByTagName()nutzen, um alleexpertiseElemente aufzulisten und jeden Skill auszugeben.
Hinweis: Die nodeName und tagName Werte folgen XML DOM Namenskonventionen, die ungewohnt sein können, wenn Sie neu in XML sind.
Schritt 3) Wir können eine Liste aller Skills aus dem Dokument extrahieren. Der folgende Code demonstriert, wie Skill-Namen in ein Set gesammelt werden.
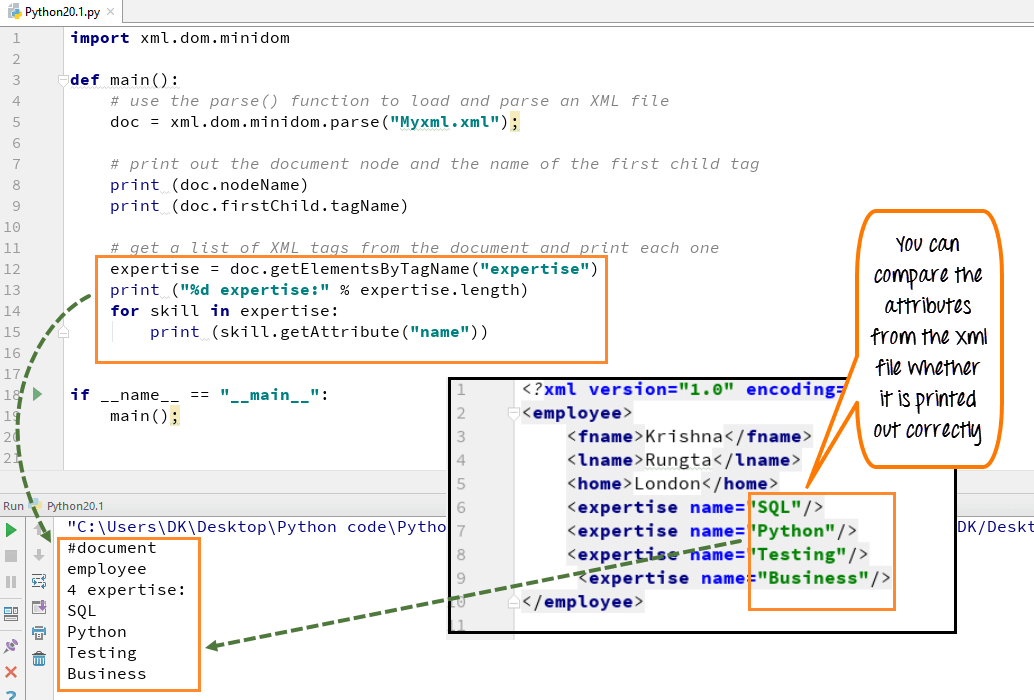
getElementsByTagName("skill")nutzen, um alle Skill-Elemente abzurufen.- Über die zurückgegebene Liste iterieren und jedes Skill's
name-Attribut ausgeben.
Neuen XML Node erstellen
Neue Daten zu einer bestehenden XML-Struktur hinzuzufügen ist mit minidom unkompliziert. In unserem Beispiel fügen wir einen neuen expertise-Node mit Label "BigData" hinzu.
- Neues Element mit
createElement("expertise")erstellen undname-Attribut setzen. - Neues Element an das Root-Child des Dokuments anhängen.
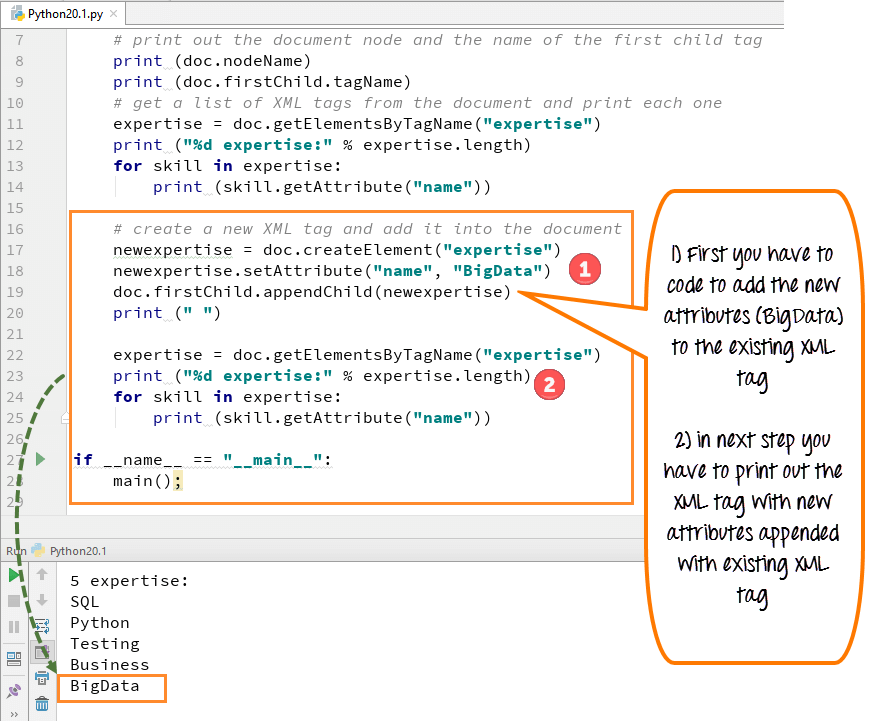
- Nach Einfügung enthält die
expertise-Liste nun den neuen "BigData"-Skill.
XML Parser Beispiel
Python 2 Beispiel
import xml.dom.minidom

def main():
    # XML-Datei laden und parsen
    doc = xml.dom.minidom.parse("Myxml.xml")
    # Root-Informationen ausgeben
    print doc.nodeName
    print doc.firstChild.tagName
    # Bestehende Expertise-Einträge auflisten
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")
    # Neuen Expertise-Eintrag hinzufügen
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print " "
    # Hinzufügen verifizieren
    expertise = doc.getElementsByTagName("expertise")
    print "%d expertise:" % expertise.length
    for skill in expertise:
        print skill.getAttribute("name")

if __name__ == "__main__":
    main()
Python 3 Beispiel
import xml.dom.minidom

def main():
    # XML-Datei laden und parsen
    doc = xml.dom.minidom.parse("Myxml.xml")
    # Root-Informationen ausgeben
    print(doc.nodeName)
    print(doc.firstChild.tagName)
    # Bestehende Expertise-Einträge auflisten
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))
    # Neuen Expertise-Eintrag hinzufügen
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print(" ")
    # Hinzufügen verifizieren
    expertise = doc.getElementsByTagName("expertise")
    print("%d expertise:" % expertise.length)
    for skill in expertise:
        print(skill.getAttribute("name"))

if __name__ == "__main__":
    main()
XML mit ElementTree parsen
ElementTree ist eine leichte API, die XML-Manipulation einfach und pythonisch macht. Sie ist ideal für das Lesen großer XML-Dateien ohne den Overhead eines vollen DOM.
Unsere XML-Beispieldaten:
<data>
  <items>
    <item name="expertise1">SQL</item>
    <item name="expertise2">Python</item>
  </items>
</data>
XML mit ElementTree lesen:
Zuerst das Modul importieren:
import xml.etree.ElementTree as ET
Datei parsen und Root-Element erhalten:
tree = ET.parse('items.xml')
root = tree.getroot()
Hier der vollständige Code, um alle Skill-Namen anzuzeigen:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()
print('Expertise Data:')
for elem in root:
    for subelem in elem:
        print(subelem.text)
Output:
Expertise Data:
SQL
Python
Zusammenfassung
Pythons xml.dom.minidom und xml.etree.ElementTree Module befähigen Entwickler, XML-Dokumente effizient zu laden, zu analysieren und zu modifizieren. Während minidom eine volle DOM-Repräsentation für komplexe Manipulationen bietet, liefert ElementTree eine leichte Alternative für einfaches Parsing und Extraktion.
- XML mit
parse()laden (z. B.doc = xml.dom.minidom.parse(file)). getElementsByTagName()nutzen, um Elemente abzurufen.- Neue Nodes erstellen und anhängen mit
createElement()undappendChild(). - Mit ElementTree einfach über Child-Elemente iterieren, um Daten zuzugreifen.
Python
- Python File I/O: Dateioperationen, Lesen, Schreiben und Verwaltung meistern
- Dateien in Java mit BufferedReader lesen – Praktischer Leitfaden mit Beispielen
- Pythons strip()-Methode meistern: Umfassender Leitfaden & Praxisbeispiele
- Python len(): Praktischer Leitfaden zur Messung von Objektlängen
- Pythons yield meistern: Generator vs. Return – Ein praktischer Leitfaden
- Python Counter in collections: Effizientes Zählen, Aktualisieren und arithmetische Operationen
- Pythons enumerate() meistern: Schleifen mit Indizes für Listen, Tupel, Strings und Dictionaries
- Datei- und Verzeichnisexistenz in Python prüfen – Ein praktischer Leitfaden
- Python JSON: Encoding, Decoding und Datei-Handling – Ein praktischer Leitfaden
- Python list.index(): Element-Positionen finden mit praktischen Beispielen