



Wie fortschrittliche Signalverarbeitung nahtlose Voice Assistant Interaktion ermöglicht
Smart Speaker und sprachgesteuerte Geräte expandieren rasant ihren Reach, mit Assistenten wie Amazons Alexa und Google Assistant, die mit jedem Update besser darin werden, unsere gesprochenen Commands zu entschlüsseln.
Einer der größten Reize dieser Schnittstelle ist ihre mühelose Natur – keine Lernkurve, nur natürliche Konversation. Hinter diesem reibungslosen Erlebnis liegt eine anspruchsvolle Kette von Signalverarbeitungsschritten, die rohes Audio in einen klaren, actionable Request transformieren.
In diesem Artikel untersuchen wir die Architektur, die Voice-Controlled Lösungen antreibt, und enthüllen die verborgenen Layer aus Hardware und Software, die sie zum Leben erwecken.
Signal Flow und Architektur
Obwohl die Details über Produkte variieren, ist der fundamentale Flow konsistent. Als Beispiel dient ein Smart Speaker wie Amazons Echo, die Schlüssel-Subsysteme sind in Abbildung 1 illustriert.
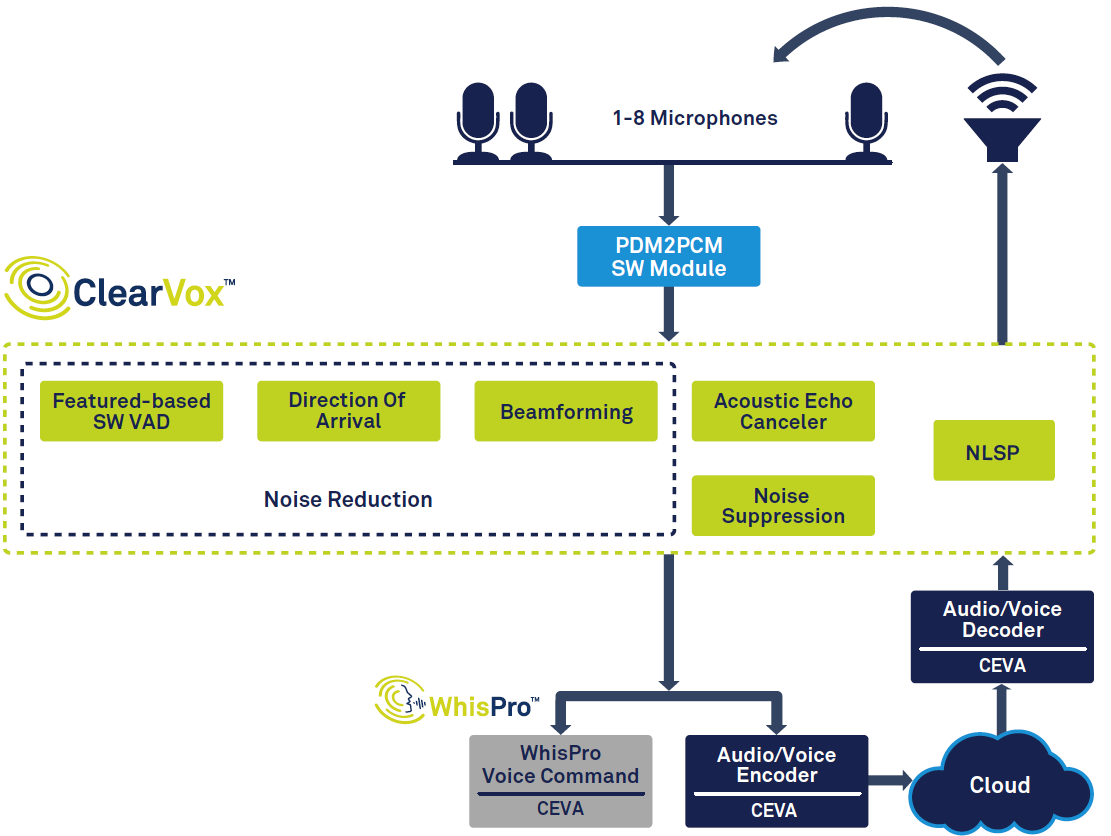
Die Kette beginnt mit Voice Activity Detection (VAD), die gesprochene Segmente isoliert. Das erfasste Audio wird digitalisiert und einer Reihe von Front-End Algorithmen unterzogen, die Klarheit erhöhen, indem sie auf die Ankunftsrichtung des Nutzers fokussieren. Das verarbeitete Signal wird dann an Back-End Speech Processing weitergeleitet, das teilweise auf dem Gerät (Edge) und teilweise in der Cloud laufen kann. Schließlich wird eine Response – Text oder Speech – synthetisiert, dekodiert und über den Digital-to-Analog Pfad des Speakers gerendert.
Verschiedene Use Cases führen Variationen ein. In-Vehicle Voice Interfaces müssen beispielsweise Road Noise tacklen, während aufstrebende Wearables ultra-low Power und minimalen Cost demanden.
Front-End Signalverarbeitung
Nach VAD und Digitalisierung muss das Gerät unerwünschte Sounds unterdrücken. Acoustic Echo Cancellation (AEC) entfernt Reflexionen, verursacht durch das eigene Playback des Geräts, was nahtloses „Barge-In“ ermöglicht, selbst während Musik spielt. Noise Suppression bereinigt dann residuales Background Rauschen.
Voice-Controlled Devices fallen in zwei Kategorien: Near-Field (Headsets, Earbuds) und Far-Field (Smart Speaker, TVs). Near-Field Einheiten nutzen typischerweise ein oder zwei Mikrofone, während Far-Field Einheiten drei bis acht Mikrofone deployen. Letztere stehen einer härteren akustischen Umgebung gegenüber – Stimmen verblassen mit Distanz, Background Noise bleibt konstant, und Reverberation kompliziert Signal Extraktion.
Far-Field Einheiten setzen Beamforming ein, eine Technik, die die Quellrichtung aus Zeitdifferenzen über Mikrofone berechnet. Dies erlaubt dem System, sich auf den Nutzer zu fokussieren, Reflexionen zu ignorieren, Bewegung zu tracken und einen einzelnen Sprecher zu isolieren, wenn mehrere Stimmen präsent sind.
Trigger-Word Detection (z. B. „Alexa“) ist ein kritisches Feature. Continuous Listening wirft Privacy Bedenken auf; daher führen viele Systeme Wake-Word Recognition lokal aus und senden Audio an die Cloud erst nach Erkennung eines vollständigen Commands.
Das bereinigte Voice Sample wird vor Transmission zum Cloud Backend für tiefere Analyse encodiert.
Spezialisierte Lösungen
Front-End Processing muss schnell, akkurat und power-efficient sein – besonders für batteriebetriebene Wearables. General-Purpose DSPs oder CPUs kämpfen, diese Demands in Sachen Cost, Size und Energy Consumption zu treffen. Die Lösung ist ein anwendungsspezifischer DSP, engineered für Audio Tasks.
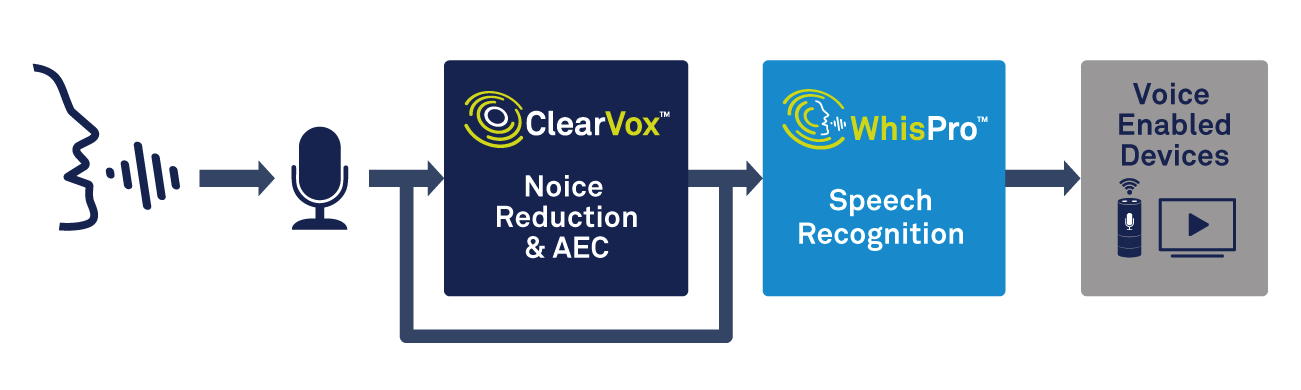
CEVAs ClearVox ist eine Software Suite, die Multi-Mic Beamforming, Direction-of-Arrival Estimation, Noise Suppression und AEC über diverse akustische Szenarien handhabt. Optimiert für CEVA Sound DSPs, liefert ClearVox einen Low-Cost, Low-Power Pfad zu hochwertiger Voice Capture.
Trigger-Word Detection wird von CEVAs WhisPro gehandhabt, einem Neural-Network-basierten Recognizer, exklusiv für CEVA DSPs. WhisPro hält den Hauptprozessor schlafend, bis ein Wake-Word detektiert wird, was den Gesamtsystemstrom drastisch senkt, während eine >95% Erkennungsrate gehalten wird. Es unterstützt multiple Trigger Phrases und Custom Words – ein kritischer Faktor für Consumer Satisfaction.
Speech Recognition: Lokal oder Cloud
Sobald das Audio clean und digitalisiert ist, ist der nächste Schritt Automatic Speech Recognition (ASR). Das Spektrum reicht von einfachem Keyword Spotting bis zu vollwertigem Natural Language Processing (NLP). Keyword Detection ist ideal für narrow-scope Devices (z. B. ein smarter Thermostat), was offline, instant Responses ermöglicht.
Gegensätzlich erfordern viele Applikationen kontextuelles Verständnis. Eine Anfrage wie „Zeig mir ein gutes Hotel nahe dem Stadtzentrum“ muss nach Intent, Entities und Follow-up Kontext geparst werden – ein Job, der typischerweise Neural Network Inference weit jenseits der Fähigkeit Low-Power Edge Chips verlangt.
Cloud-basiertes Processing bietet den computativen Hebel für sophistiziertes NLP, auf Kosten von Latenz und Internet Verbindung. Edge Lösungen verbessern sich jedoch; CEVAs NeuPro AI Prozessoren bringen On-Device Neural Network Inference zum Edge, was smartere, schnellere lokale Responses ermöglicht, während sie bei Bedarf auf die Cloud fallen.
Die Wahl zwischen Edge und Cloud involviert Trade-offs. Lokales Processing glänzt in Speed und Privacy, kämpft aber mit komplexen Queries. Cloud Processing skaliert zu komplexem NLP, führt aber Latenz und Konnektivitätsabhängigkeit ein.
Fazit
Voice Interfaces werden rasch zum Eckpfeiler alltäglicher Technologie. Kontinuierliche Fortschritte in Signalverarbeitung, ASR und KI – gekoppelt mit spezialisierter Hardware – treiben höhere Akkuratesse, niedrigeren Power und reduzierte Kosten.
OEMs, die purpose-built Lösungen wie ClearVox, WhisPro und NeuPro adoptieren, können strenge Performance, Cost und Power Targets treffen, während sie Time-to-Market verkürzen.
Während Voice Technology reift, können wir noch natürlichere Interaktion und breitere Applikationshorizonte erwarten – eine aufregende Reise, die neu definieren wird, wie wir mit Geräten interagieren.
Eingebettet
- Wie Edge-KI und Mikrofon-Fortschritte Sprachassistenten beschleunigen
- Der komplette Leitfaden zur Glasfaserproduktion
- Lieferkette für Resilienz und Effizienz heute optimieren
- SCADA-Systeme: Überwachung und Steuerung industrieller Prozesse
- Digitaler Kompass in Echtzeit mit Arduino & Processing bauen
- Gewinnbringenden Prototyp bauen: Schritt-für-Schritt-Anleitung für schnelle Produktentwicklung
- Wie Lufttrockner funktionieren: Druckluft sauber & effizient halten
- Inkjet-gedrucktes Graphen: Die Zukunft 3D-gedruckter Elektronik
- Elektrobremsen verstehen: Funktionsweise & Bedeutung
- Bewährte Strategien für ein funktionierendes umfassendes Sicherheitsprogramm