



Deep Learning vs. Machine Learning: Die wichtigsten Unterschiede verstehen
In den Anfangstagen von Computern nutzten Wissenschaftler sie hauptsächlich für einfache mathematische und logische Operationen. Dann entwickelten sich Computer langsam weiter, um komplexe Berechnungen, aufwendige Problemlösungen und das Informationsrückgrat der Welt zu bilden. Jenseits des traditionellen Computings bedeutete dies, dass der Computer Intelligenz benötigte.
Forscher und Computeringenieure wandten sich der Nachahmung menschlicher Intelligenz zu. Künstliche Intelligenz (KI) ist der Bereich der Informatik, der sich der Erstellung von Computersystemen widmet, die so intelligent sind wie Menschen. Anfängliche KI-Modelle waren Computersysteme, die komplexe logische Operationen durchführten. Später wurden fortgeschrittenere Techniken entwickelt, um „intelligente“ Aufgaben auszuführen.
Zwei der am häufigsten verwendeten Begriffe in der KI sind Machine Learning und Deep Learning. Dieser Artikel betrachtet die Ursprünge dieser beiden Techniken, ihre Gemeinsamkeiten und Unterschiede.
Deep Learning und Machine Learning
Machine Learning und Deep Learning sind Teilmengen der KI. Deep Learning ist eine Teilmenge von Machine Learning. Das bedeutet: Alles Deep Learning ist Machine Learning, aber nicht alles Machine Learning ist Deep Learning. Um die Unterschiede zu verstehen, schließt der Begriff Machine Learning Deep Learning für den Rest dieses Artikels aus.
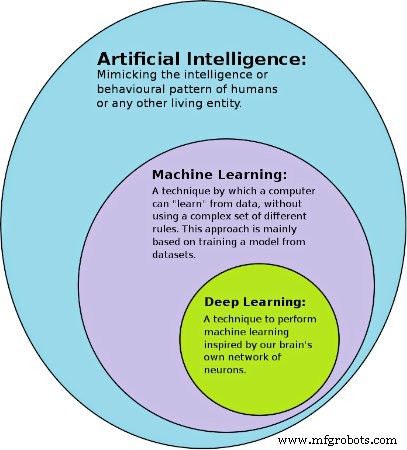
Abbildung 1. Eine Grafik, die zeigt, wie KI, Machine Learning und Deep Learning zueinander in Beziehung stehen. Bild mit freundlicher Genehmigung von Avimanyu786
Machine Learning
Machine Learning analysiert große Datenmengen, um die Merkmale eines Trainingsdatensatzes zu verstehen. Was aus dem Trainingsdatensatz gelernt wurde, wird auf andere Datensätze angewendet, um „intelligente“ Entscheidungen zu treffen. Die mit dem Trainingsdatensatz erstellten Modelle können mit anderen ähnlichen Datensätzen arbeiten, um die gewünschte Ausgabe zu generieren.
Der Trainingsdatensatz für Machine-Learning-Modelle sollte gelabelt sein, und die Entwickler müssen den Lernprozess überwachen und anpassen, während das neue Modell trainiert wird. Neben grundlegendem Computing werden statistische Modelle stark für das Training von Machine-Learning-Modellen verwendet.
Die Unterscheidung zwischen Katzen und Hunden ist ein gängiges Beispiel im KI-Bereich. Folgend eine Übersicht, wie Machine-Learning-Modelle mit Daten trainiert werden.
Das Trainingsmodell wird mit Tausenden von Bildern von Katzen und Hunden gefüttert. Jedes dieser Bilder ist entweder „Katze“ oder „Hund“ gelabelt. Das Modell in der Identifikation identifiziert Merkmale aus den Bildern, die Katzen, Hunde und den Rest der Objekte unterscheiden. Die Merkmale werden mithilfe statistischer Techniken aus den Bildern identifiziert. Sobald das Modell mit ausreichend Daten trainiert wurde, wird es mit ungelabelten Bildern gefüttert. Wenn das trainierte Modell erfolgreich zwischen Katzen- und Hundebildern mit der gewünschten Genauigkeit unterscheiden kann, ist es ein erfolgreiches Machine-Learning-Modell.
Deep Learning
Deep Learning ist die Evolution des konventionellen Machine Learning. Menschen lernen nicht mit Tausenden gelabelter Beispiele; sie lernen automatisch ohne viel externe Hilfe oder Validierung. Deep Learning bringt Machine Learning einen Schritt näher an dieses Modell intelligenten Lernens.
Deep-Learning-Modelle müssen ebenfalls mit großen Datenmengen trainiert werden, aber die Modelle werden nicht mit gelabelten Daten trainiert. Alle Daten, die dem Deep-Learning-Modell zugeführt werden, sind ungelabelt. Das Modell identifiziert verschiedene Elemente aus den Daten, um die gewünschte Ausgabe zu liefern.
Abbildung 2. Eine visuelle Darstellung neuronaler Netze in der Landwirtschaft.
Deep-Learning-Modelle nutzen komplexe mathematische Systeme, sogenannte neuronale Netze, um aus Daten zu lernen. Sie enthalten mehrere Schichten mathematischer Funktionen mit unterschiedlichen Gewichten. Das „Deep“ im Begriff Deep Learning stammt von diesen Verarbeitungsschichten.
Lassen Sie uns überblicken, wie Deep-Learning-Modelle die Unterscheidung von Katzen und Hunden angehen. Ein neuronales Netz wird mit zahlreichen ungelabelten Bildern von Katzen und Hunden gefüttert. Das neuronale Netz muss herausfinden, dass es zwei Tiergruppen in den Bildern gibt, und dann identifizieren, wie man zwischen den beiden Tieren unterscheidet. Es sind keine gelabelten Daten oder Entwicklerüberwachung erforderlich.
Einmal erfolgreich trainiert, kann das Modell beliebig viele Bilder von Katzen und Hunden unterscheiden.
Vergleich von Machine Learning und Deep Learning
Die folgende Tabelle ist ein schneller Vergleich der Unterschiede zwischen Machine Learning und Deep Learning. Beachten Sie, dass Deep Learning für diesen Vergleich vom Begriff Machine Learning ausgeschlossen ist, obwohl Deep Learning eine Teilmenge von Machine Learning ist.
Machine Learning |
Deep Learning |
|
Trainingsdaten |
Gelabelte Daten |
Ungelabelte Daten |
Überwachung |
Supervised Learning |
Unsupervised Learning |
Techniken |
Meist statistische Techniken |
Fortgeschrittene mathematische Funktionen |
Datenvolumen |
Relativ weniger Trainingsdaten erforderlich |
Sehr großes Datenvolumen erforderlich |
Genauigkeit |
Relativ geringere Genauigkeit |
Höhere Genauigkeit bei großen Datenmengen |
Trainingszeit |
Relativ kurz |
Sehr lange Trainingszeit |
Abbildung 3. Eine Tabelle zum Vergleich von Machine Learning und Deep Learning.
Industrielle Anwendungen für Deep Learning
Sowohl Machine Learning als auch Deep Learning haben industrielle Anwendungen. Deep Learning kann in allen Anwendungen eingesetzt werden, die durch Machine Learning bewältigt werden können. Aber Deep Learning erfordert mehr Expertise, ein viel größeres Datenvolumen, höhere Rechenleistung und Zeit. Aufgrund dieser Faktoren beinhaltet die Wahl zwischen beiden Techniken die Berücksichtigung vieler Faktoren.
Wenn höhere Genauigkeit erforderlich ist, sind Deep-Learning-Modelle vorzuziehen. Um jedoch höhere Genauigkeit mit Deep Learning zu erreichen, muss ein sehr großes Datenvolumen verarbeitet werden, was einen viel längeren Trainingszeitraum involviert. Machine-Learning-Algorithmen können in den meisten Fällen routinemäßig eingesetzt werden.
Ein weiteres allgemeines Merkmal ist die Komplexität des Problems. Je komplexer das Problem, desto besser funktionieren Deep-Learning-Modelle im Vergleich zu Machine-Learning-Modellen. Es gibt jedoch keine harte Regel, wo welche Technik einzusetzen ist. Zum Beispiel reicht Machine Learning aus, um den Energieverbrauch in einer Anlage zu analysieren und vorherzusagen. Es ist jedoch unzureichend, um ein automatisiertes Qualitätskontrollsystem aufzubauen – hier sind Deep-Learning-Algorithmen nötig.
Heute ist Machine Learning in der Industrie viel zugänglicher als Deep Learning. Aber in Zukunft werden Deep-Learning-Modelle sich verbessern, Implementierungskosten und Eintrittsbarrieren senken, was bedeutet, dass mehr Rechenleistung zu niedrigeren Preisen verfügbar sein wird. Die Akzeptanz von Deep Learning in der Industrie wird mit der Zeit zunehmen.
Internet der Dinge-Technologie
- Machine Learning auf AWS meistern: Ein umfassender Leitfaden
- Machine Learning zur Optimierung des MRO Supply Chain Managements nutzen
- Wie robustes Data Management Machine Learning und KI im Industrial IoT antreibt
- Machine Learning für Unternehmenserfolg nutzen
- KI, Maschinelles Lernen und Deep Learning erklärt: Unterschiede und Funktionsweise
- Machine Learning beschleunigt Pipeline-Sicherheit: Echtzeit-Fehlererkennung spart 10 Mio. $
- Maschinelles Lernen für Predictive Maintenance: Revolution der Asset-Zuverlässigkeit
- Präzise Batterielebensdauer-Vorhersage mit KI – DOE Argonne Studie
- Einblick in die Rolle von KI-Forschern & ML-Engineers bei JPMorgan
- Machine Learning entschlüsseln: Praktische Einblicke für Industrie-Führungskräfte