



Robuste KI-Systeme bauen: Fehlerabsicherung von Algorithmen für die Industrie
Störungen an Machine-Vision-Kameras, unkalibrierte Sensoren oder unvorhersehbare Schatten können zu potenziell kostspieligen und gefährlichen Fehlern in industriellen KI-Systemen führen. Doch Forscher entwickeln Fehlerabsicherungs-Algorithmen sowie einfache Maßnahmen, die die Fehlerwahrscheinlichkeit reduzieren können.
Industrielle Anwendungen für Künstliche Intelligenz
Es gibt zahlreiche industrielle Anwendungen für KI (Künstliche Intelligenz): Robotik-Plattformen, Materialhandhabung, Verpackung, Maschinenbestückung, Montage, Inspektion und Building Automation Systems (BAS). Spezifischere Beispiele sind Drohnen- und Schwarmtechnologie für Sortieren, Bewegen, Transportieren von Items oder Detektion von Anomalien in Produktionsprozessen.
KI ist zu einem kritischen, aber oft vergessenen Aspekt der industriellen Automatisierung geworden, die auf Machine Vision, Roboterarmen, Remote Sensing und Prozesssteuerung basiert.
KI-Tools sind jedoch keine einfache Black Box, in die Daten als Input gegeben und in präzisen Output transformiert werden. Manchmal ist der Output falsch – und das ist Anlass zur Sorge.
Fehlertypen in industriellen Anwendungen
Computer tun, was man ihnen sagt – also ist ein Mensch an der Wurzel jedes Fehlers. Es kann ein Designfehler, Algorithmenfehler, Ingenieursfehler oder schlechte Daten sein – aber ein Mensch steckt dahinter.
Das gilt auch für KI, einschließlich industrieller KI. Fehler in industrieller KI fallen in zwei Kategorien: algorithmischer Bias und Machine Bias.
Algorithmischer Bias umfasst Fehler, die sowohl wiederholbar als auch systemisch sind. Solche Fehler können sich auf verschiedene Weisen manifestieren: inhärenter Fehler in der Algorithmenlogik, unvorhergesehene Nutzung des Algorithmenoutputs oder Probleme mit den der KI zugeführten Daten.
Machine Bias tritt auf, wenn ein begrenzter Datensatz zum Training des Systems genutzt wird, was zu fehlerhaftem Output führt.
Die Wichtigkeit, KI-Fehler unter Kontrolle zu halten
Als Beispiel für algorithmischen Bias betrachten wir ein KI-gestütztes Machine-Vision-System für automatisierte Qualitätskontrolle. Solch eine Anwendung hängt stark von präzisen Messungen ab, die als Daten an die KI geliefert werden, um zu bestimmen, ob ein Teil innerhalb der Toleranzen liegt. Werden ungenaue Messungen an die KI geliefert, resultiert dies in fehlerhafter Teileklassifizierung.
Die Algorithmen hinter der Machine-Vision-KI können 100 % korrekt sein, aber schlechte Daten bedeuten schlechten Output. Akzeptable Teile werden entsorgt, während minderwertige Teile an Kunden gelangen. Das führt zu unnötigen Kosten und Ausfallzeiten, während die Fehlerquelle aufgespürt wird.
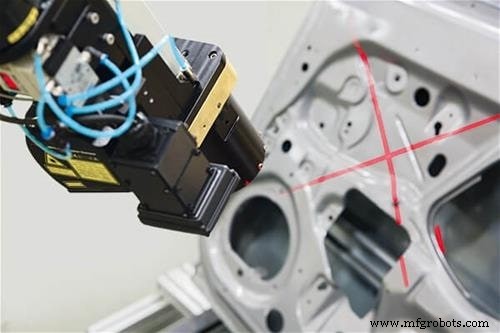
Einige KI-Systeme erfordern Training vor dem Einsatz in einer bestimmten Umgebung oder Anwendung. In solchen Fällen sind die Trainingsdaten, die dem System zugeführt werden, extrem wichtig. Beispiel: Erhält ein System Training, das auf beleuchtete Bereiche beschränkt ist, gibt es Probleme, wenn das System ohne Licht performen muss.
KI fehlerabsichern (KI trainieren)
Weil ein menschliches Element hinter KI und Machine Learning steckt, kann sie nicht vollständig fehlerabsichert werden. Es gibt jedoch Wege, Fehler in KI-Systemen zu minimieren. Ein Beispiel ist CARRL (Certified Adversarial Robustness for Deep Reinforcement Learning), ein Deep-Learning-Algorithmus, der am MIT entwickelt wurde. Sein Zweck: autonome Systeme zu unterstützen, indem ein Maß an Skepsis gegenüber den Daten gefördert wird, das Rauschen in den Daten und adversariale Versuche, das System zu verwirren, berücksichtigt.
Carnegie Mellon arbeitet ebenfalls an einem KI-Algorithmus für Deep-Learning-Modelle. RATT (Randomly Assign, Train and Track) nutzt unlabeled und rauschhafte Trainingsdaten, um eine obere Schranke für das wahre Fehlerrisiko zu etablieren. Diese obere Schranke kann dann bestimmen, wie gut ein KI-Modell sich an neue Eingabedaten anpasst. Zudem forschen Princeton-Forscher an Algorithmen, die es KI-Systemen ermöglichen, effektiv zu lernen, wenn Fehler in den Trainingsdaten vorhanden sind.
Es gibt auch Standards in Entwicklung, die Fehlerabsicherungsbemühungen beeinflussen werden. NIST (National Institute of Standards and Technology) trägt aktiv zu KI-Standards bei, die einen Fokus auf die Bewertung der Vertrauenswürdigkeit von KI-Technologie beinhalten. NIST hat auch einen Ansatz vorgeschlagen, das Risiko von Bias in KI-Systemen zu reduzieren.
Die US-CISA (Cybersecurity and Infrastructure Security Agency) schaut bereits auf Standards für die Prüfung von KI-Algorithmen und Datenerfassung, wie während eines 2020er Panels „Genius Machines“ enthüllt. Diese Bemühung, zusammen mit der von NIST, betont Accountability.
Fehler in KI-Systemen adressieren
Während das vollständige Fehlerabsichern der KI-Systeme, für die Sie verantwortlich sind, aufgrund des menschlichen Elements möglicherweise nicht möglich ist, gibt es sicherlich Wege, die Fehlerwahrscheinlichkeit zu minimieren.
Wenn Sie vermuten, dass Fehler aus Ihrem KI-System kommen, schuldigen Sie nicht automatisch den Algorithmus; analysieren Sie die Fehler auf Muster. Beispiel: Wenn ein autonomer Bin-Picking-Roboter Fehler macht, prüfen Sie, ob die fehlerhaft sortierten Items etwas gemeinsam haben oder ob sich die Roboterumgebung geändert hat (Beleuchtung, Schatten etc.), was die Performance beeinflussen könnte. Es könnte auch ein Problem mit einer verschmutzten Kameralinse im Machine-Vision-Teil des Systems geben – wie bei autonomen mobilen Robotern.
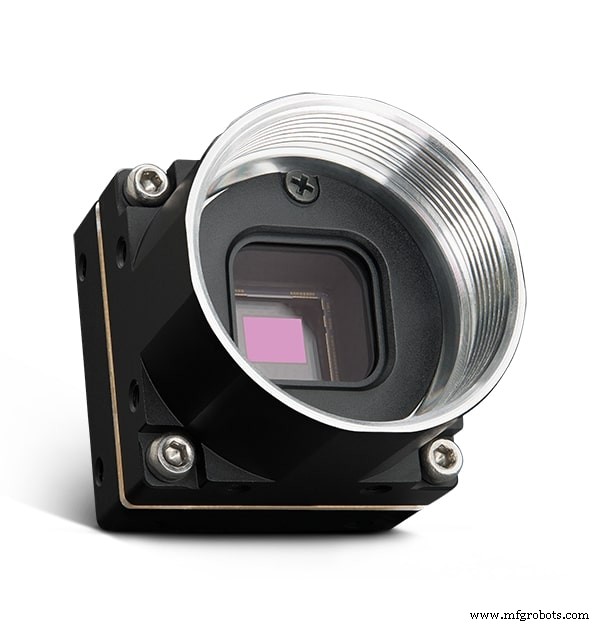
Eine harte Programmierregel: Schlechter Input führt immer zu schlechtem Output. Der erste Schritt zur Minimierung der von einem industriellen KI-System generierten Fehler ist sicherzustellen, dass seine Daten so präzise wie möglich sind – beginnend bei den Sensoren. Sensoren, die Inputdaten an KI-Systeme liefern, sollten regelmäßig kalibriert werden.
Tools innerhalb des KI-Systems, die Nutzern erlauben, akzeptable Datenbereiche festzulegen, sollten nach sorgfältiger Abwägung eines akzeptablen Bereichs implementiert werden: zu streng, und die KI liefert wenig Wert; zu locker, und sie generiert zu viele Fehler. Und denken Sie daran: Diese Werte können angepasst werden.
Zudem, wie früher angedeutet: Halten Sie Kameras sauber. Zwar sind Machine-Vision-Systeme für Robustheit in verschiedenen Umgebungsbedingungen designed, aber das heißt nicht, dass sie noch gut performen, wenn die Sicht durch eine verschmutzte Linse beeinträchtigt ist. Gleiches gilt für andere Industriesensoren, deren Genauigkeit durch Ablagerungen, korrosive Umgebungen, mechanische Probleme oder Alterung beeinträchtigt werden kann.
KI wird im Industriesektor breit eingesetzt – von Prozesssteuerung bis Qualitätsinspektion. Und wegen des menschlichen Faktors sind diese KI-Systeme auch fehleranfällig. Fehlerabsicherungs-Algorithmen werden entwickelt, aber diese Methoden sind noch nicht voll ausgereift und nicht extensiv auf industrielle Anwendungen getestet. Und während Organisationen wie NIST und CISA an Fehlerabsicherungsstandards arbeiten, sind diese noch in Entwicklung. Doch einige einfache Maßnahmen können die Fehlerwahrscheinlichkeit in Ihren KI-Systemen reduzieren.
Industrieroboter
- C++-Datentypen verstehen: Grundlagen, Modifizierer und Best Practices
- C Datentypen erklärt: int, float, char und mehr – Ein vollständiger Leitfaden
- Python-Datentypen meistern: Praxisleitfaden
- Java-Kapselung meistern: Praktischer Leitfaden zum Datenverbergen
- Java Collections Algorithmen meistern: Sortieren, Mischen und mehr
- Java Type Casting meistern: Von Widening zu Narrowing und darüber hinaus
- C-Datentypen verstehen: Umfassender Leitfaden
- C-Unions erklärt: Effizientes Speichermanagement für mehrere Datentypen
- MATLAB Datentypen: Umfassender Leitfaden
- Umfassender Leitfaden zu C# Datentypen: Wert-, Referenz- und Zeigertypen