



Die versteckten Kosten von Applikations- und Netzwerk-Performance-Problemen berechnen
Viele Prospects und Kunden sind überrascht, wie umfassend Infrastruktur-Monitoring sein kann. Heutige Umgebung – Cloud-Anbieter, SaaS-Apps, Remote-Büros und tech-affine verteilte Teams – schafft einen komplexen Teppich, der überwältigend wirken kann. Kein Wunder, dass Monitoring des gesamten Stacks unmöglich scheinen kann; IT-Teams lernen noch, wie man das wachsende Array an Tools und Nutzern managt.
Wenn Performance-Probleme auftauchen, werden sie meist erst gefangen, nachdem Nutzer Tickets für langsame Applikationen, Wi-Fi-Glitches oder wiederkehrende Task-Fehler einreichen. IT taucht dann in Troubleshooting ein, oft mit gemischten Ergebnissen. Root-Cause-Discovery wird zur reaktiven Übung, die flüchtige „Geister“-Issues lange nachdem der Nutzer betroffen war, jagt – ein Ansatz, der wie das Schließen der Scheunentür nachdem das Pferd bereits entflohen ist.
Für sowohl IT als auch Business sind diese Nutzerfrustrationen mehr als Ärgernis. Netzwerk- und Applikationsverlangsamungen übersetzen sich in echten finanziellen Verlust. Betrachten Sie eine 300-Personen-Organisation, die auf Google Workspace oder Office 365 angewiesen ist. Mit einem durchschnittlichen Stundenlohn von 25 $ pro Nutzer kostet jede Stunde, in der Mitarbeiter nicht auf eine Applikation zugreifen können, das Unternehmen ca. 7.500 $. Eine aktuelle Umfrage ergab, dass 98 % der Organisationen glauben, eine einzelne Stunde Downtime koste mehr als 100.000 $, und 33 % berichten, dass eine Stunde Downtime zwischen 1 und 5 Millionen $ kostet.
Was Performance-Probleme Ihr Business kosten
Historisch war Downtime die Hauptsorge. Heute jedoch sind Applikationen für Hochverfügbarkeit engineered; die echte Bedrohung ist träge Performance. Nutzer beschweren sich mehr über eine App, die an einem Task hängt oder zu lange lädt, als über völlige Ausfälle. Viele Performance-Hickups sind intermittierend und schwer zu reproduzieren, oft als vage „Wi-Fi-Probleme“ surfacing.
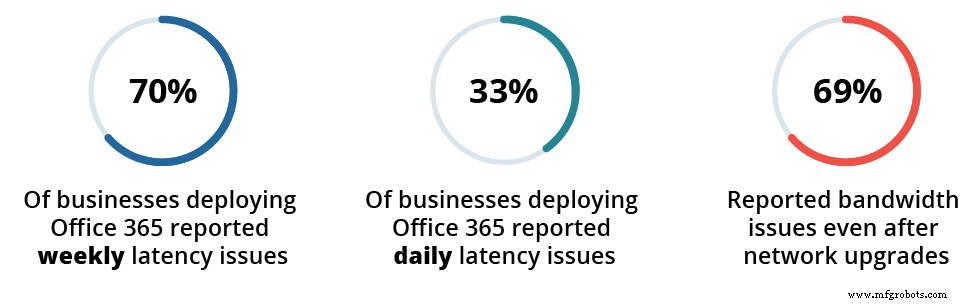
Forschung fokussiert auf Office-365-Deployments zeigt, dass 70 % der Unternehmen wöchentliche Latenzissues berichten, und 69 % immer noch Bandbreitenprobleme erleben, selbst nach Netzwerk-Upgrades. Das Versprechen von SaaS entfernt Performance-Druck nicht automatisch.
 Quelle: Talkin' Cloud
Was kostet eine 10 % Verlangsamung in einer kritischen Applikation? Wenn jeder Mitarbeiter 10 % länger für Tasks braucht, übersetzt das in einen 10 % Performance-Drop. Mit einem 8-Stunden-Arbeitstag und 25 $ Stundenlohn beträgt der tägliche Kosten pro Mitarbeiter 200 $. Eine 10 % Degradation resultiert in 20 $ Verlust pro Mitarbeiter pro Tag – äquivalent zu 48 Minuten verlorener Produktivität. Über 300 Mitarbeiter sind das 6.000 $ täglicher Schlag.
Über ein Jahr, wenn 10 % der 250 Arbeitstage solche Verlangsamungen erleben (ca. 25 Tage), steht die Organisation vor 150.000 $ Produktivitätsverlust. Selbst eine konservative Schätzung von 5 betroffenen Tagen verursacht noch 30.000 $ Verlust.
Die Kosten der IT-Verwaltung im Dunkeln
Diese Zahlen sind illustrativ, aber die Realität ist, dass die meisten Unternehmen keine kontinuierliche Transparenz in ihre Applikations- und Netzwerkperformance haben. Performance-Diskussionen entfachen typischerweise nur während eines Feuerwehreinsatzes oder Ausfalls, lassen Root-Cause-Analyse als Nachgedanken zurück – wenn sie überhaupt passiert – so dass Probleme rezidivieren.
Moderne IT-Infrastrukturen enthalten weit mehr Komponenten als je zuvor, und Issues können in mehreren Layern entstehen. Zum Beispiel: Wissen Sie, ob Ihre SaaS-Anbieter oder ISPs ihre vertraglichen SLA-Verpflichtungen letztes Jahr eingehalten haben? Die Arbeit mit Cloud- und SaaS-Partnern involviert jetzt oft eine neue Art von Fingerzeigen: „Ist es der ISP oder der Cloud-Anbieter?“
Da die meisten modernen Applikationen stark vom Netzwerk abhängen, verlangt Performance-Messung Transparenz über sowohl die Applikationsschicht als auch das zugrunde liegende Netzwerk. Hier kommt AppNeta ins Spiel. Unsere Performance-Monitoring-Lösung pinpointet die Root Cause von Problemen in SaaS- und Webapplikationen sowie in Public- und Cloud-Provider-Netzwerken.
Cloud Computing
- Warum Molybdän die Glasherstellung dominiert
- Cloud-Applikations-Monitoring meistern: Einblicke für IT-Führungskräfte
- Azure DevOps-Zertifizierungskosten im Überblick – Was Sie wissen müssen
- AWS DevOps-Zertifizierung: Kosten, Vorteile & Karriereauswirkungen
- 10 Schlüsselfaktoren für die Auswahl des perfekten Schalters für Ihre Applikation
- Internet of Things überwachen: Sichere, zuverlässige IoT-Netzwerke sicherstellen
- SIM-Lebenszyklus straffen: Digitale Strategie für CSPs
- IoT von Hardware bis Applikation sichern: Ein Layer-für-Layer-Blaupause
- Die Rolle der 0G-Technologie bei der Bewältigung von Epidemien
- CNC-Bearbeitungskosten verstehen: Schlüsselfaktoren & Optimierung