



Integration domänenspezifischer Beschleuniger in RISC-V für KI, AR/VR und Vision Workloads
Als das RISC-V Ökosystem erstmals entstand, lag der primäre Fokus auf Kostensenkung in tief eingebetteten Systemen, die zuvor auf proprietäre CPU Instruction Set Architectures (ISAs) angewiesen waren. Als SoCs zu FinFET-Prozessen migrierten, trieben hohe Maskenkosten viele Designer dazu, Finite State Machines durch programmierbare Micro-Sequencer auf Basis der RISC-V ISA zu ersetzen. Dieser Shift löste initiale Begeisterung aus und führte von 2014 bis 2018 zur Kommoditisierung leichter RISC-V Cores.
Mit Reifung der Architektur gewann RISC-V Traktion in Echtzeit-High-Performance-Applikationen – besonders als Frontend zu hochspezialisierten Beschleunigungs-Engines für KI, AR/VR und Computer Vision. Die offene Natur von RISC-V erlaubt Designern, die ISA zu erweitern, sodass Prozessoren mit Beschleunigern via Low-Latency Co-Prozessor-Interfaces statt traditionellem Memory-Mapped I/O kommunizieren können.
Die RISC-V Vektor-Erweiterung befähigte diese Beschleuniger weiter, Intermediate Layer innerhalb von Kernel Inner Loops zu verarbeiten. Dies erforderte jedoch purpose-built Extensions, wie eine Custom Load Instruktion, die Daten von einem externen Beschleuniger in interne Vektor-Register transferiert.
Diese Applikationen verlangen ein Programmiermodell, das Effizienz mit Flexibilität balanciert. Ein domänenspezifischer Beschleuniger – im Wesentlichen ein großes Multiplier-Array – ist hoch effizient, aber limitiert in den Operationen, die er ausführen kann, und in seinen Data-Movement-Fähigkeiten. Im Gegensatz dazu bietet ein General-Purpose CPU wie x86 maximale Flexibilität, aber die meisten Designs können sich das >100 W Power Budget für solche Vielseitigkeit nicht leisten.
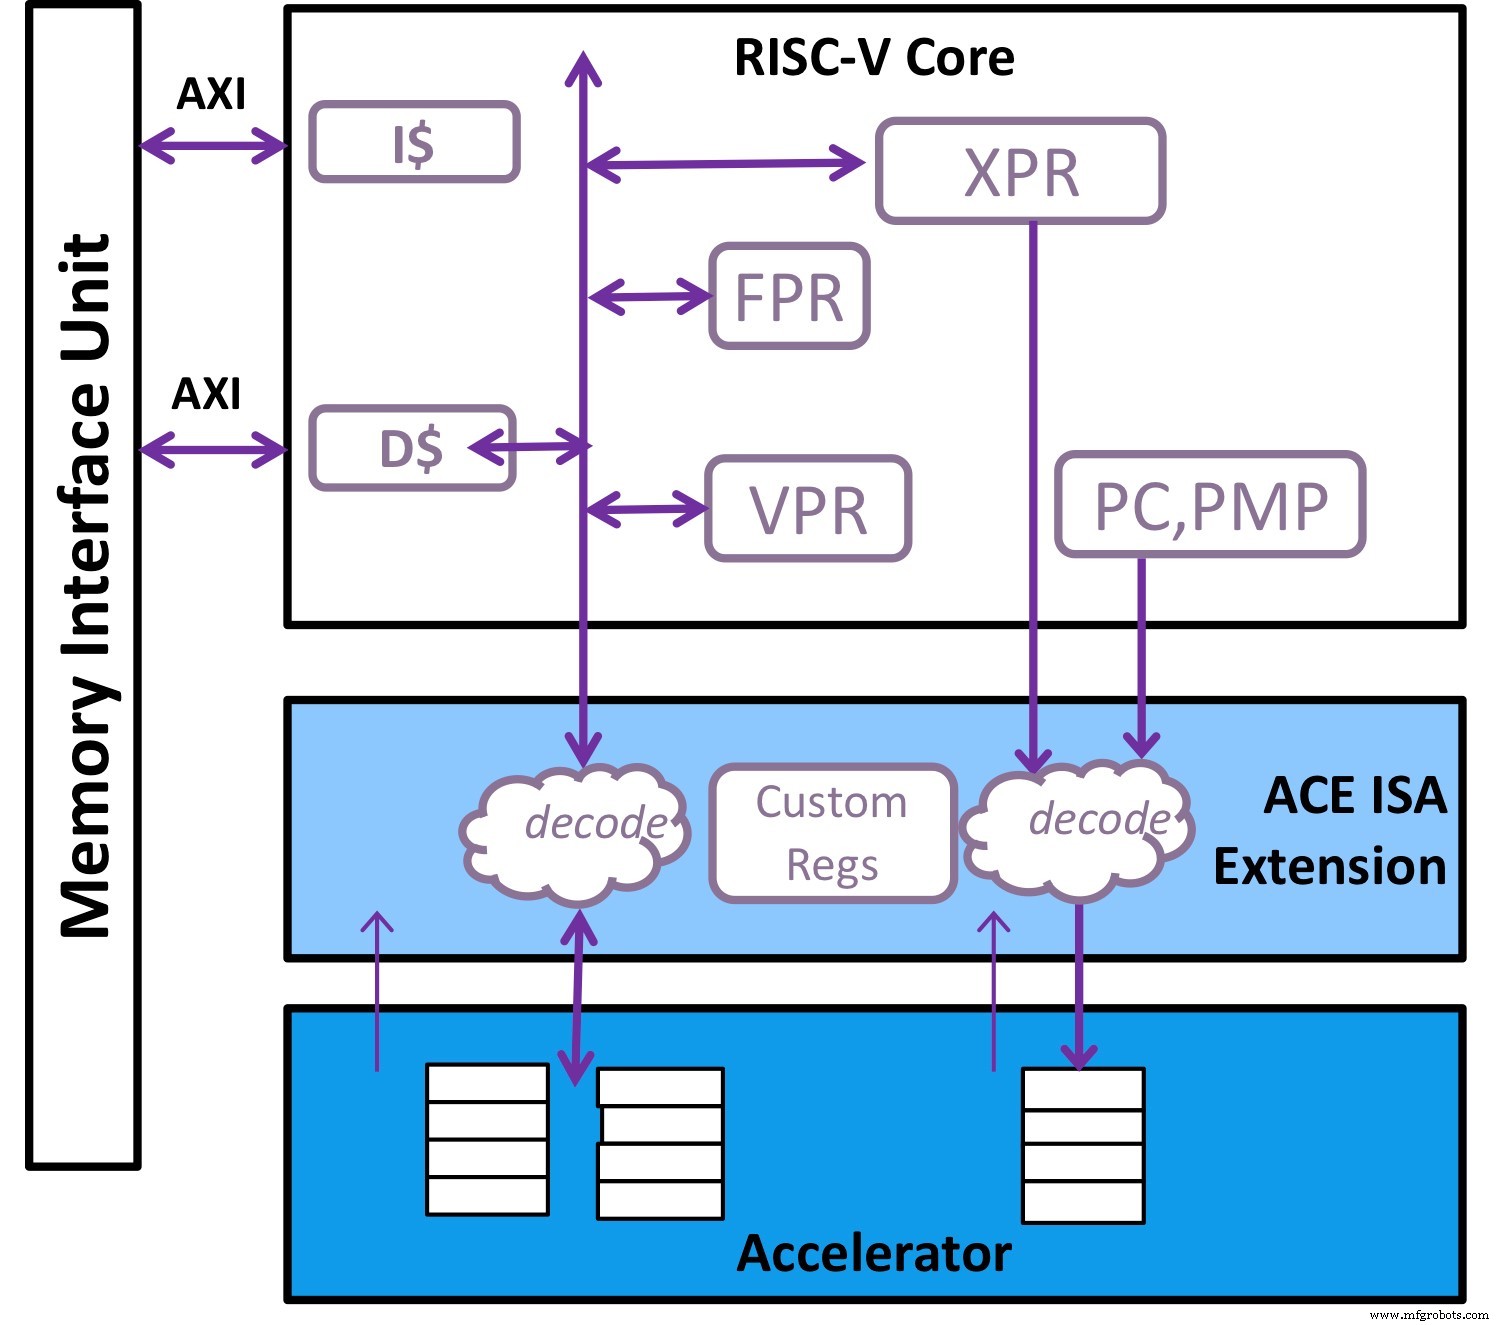
Die optimale Lösung vereint die Flexibilität einer General-Purpose CPU mit einem Task-spezifischen Beschleuniger, wie oben illustriert. In RISC-V dient die reifende Standard Vektor-Erweiterung – augmentiert mit maßgeschneiderten Custom Instructions – als perfekter Partner. Diese Synergie hat sich in den letzten 18 Monaten herauskristallisiert, als Domain-Specific Acceleration (DSA) Lösungen auf RISC-V Plattformen konvergierten.
Um diese Vision zu ermöglichen, muss der Beschleuniger sein eigenes Command Set mit seinen dedizierten Ressourcen, inklusive Memory, ausführen. Der RISC-V Core sollte Microcode flachlegen und alle nötigen Control-Informationen in ein einzelnes Command packen. Dieses Command Set muss der Prozessor's Scalar- und Vektor-Register sowie die Control-Register und Memory des Beschleunigers bewusst sein.
Wenn der Beschleuniger Unterstützung bei spezialisiertem Data Reordering oder Manipulation benötigt, setzt Andes' Architektur eine Vector Processing Unit (VPU) ein, um komplexe Permutationen – Shifting, Gathering, Compressing, Expanding – zu handhaben. Zwischen Layern involvieren Kernels oft intricate Data Patterns; die VPU liefert die nötige Flexibilität. Mit sowohl Beschleuniger als auch VPU, die massiv parallele Computations ausführen, hat Andes Hardware eingeführt, um Memory Subsystem Bandbreite zu erhöhen – Prefetching, Non-Blocking Transactions, Out-of-Order Returns – um computationale Demand zu befriedigen.
Andes Technology's erster RISC-V Vektor-Prozessor, der NX27V, implementiert die neueste V-Extension 0.8 Spezifikation. Er unterstützt 8-, 16- und 32-Bit Integer Operationen, 16- und 32-Bit Floating-Point Berechnungen, Bfloat16 und Int4 Formate zur Reduktion von Storage und Transfer Bandbreite für Machine-Learning Weights. Die Flexibilität der Vektor-Spec lässt Designer Schlüsselparameter konfigurieren – Vektorlänge, Bits per Register, SIMD Width, und Anzahl Bits pro Cycle.
Der NX27V bietet eine 512-Bit Vektorlänge, die auf 4096 Bits durch Chaining von bis zu acht Vektor-Registern erweitert werden kann. Multiple Functional Units operieren in parallelen Pipelines, sustaining den Durchsatz, den diverse Workloads fordern. In 512-Bit Konfiguration erreicht der Chip 1 GHz in 7nm Prozess unter Worst-Case-Bedingungen, belegt nur 0,3 mm². Für Software-Entwicklung liefert Andes Compiler, Debugger, Vektor-Libraries, Cycle Simulator und das Clarity Visualization Tool zur Analyse und Optimierung kritischer Loops. Die Lösung ist bereits über ein Early-Access-Programm verfügbar.
Über die letzten 15 Monate ist die Nachfrage nach High-Performance Computing – kombinierend mächtige RISC-V Vektor-Erweiterung, High-Bandwidth Memory Subsystem und Beschleuniger nah an der CPU – gesurged. Dieser Trend wird breitere Adoption von RISC-V und Vektor-Processing across the Industry treiben.
>> Dieser Artikel wurde ursprünglich auf unserer Schwesterseite EE Times veröffentlicht.
Eingebettet
- IIC und OpenFog vereinen sich, um verteiltes Computing für Industrial IoT zu führen
- Industrial Internet Reference Architecture v1.8 veröffentlicht: Layered Databus Pattern eingeführt
- IoT für frühe Waldbranderkennung und -prävention nutzen
- Die entlegene Welt verbinden: Wie Satelliten-IoT die globale Abdeckung erweitert
- Anwendungen beschleunigen mit maßgeschneiderten RISC‑V Custom Instructions
- Inhouse-Produktion: Der Fuse 1 baut seine eigenen Teile
- Daten im Internet of Reliability nutzen: Strategien für effektives Management
- Edge Computing: Die Architektur, die morgen intelligente Netzwerke antreibt
- Ihr IoT-Ökosystem sichern: Expertenstrategien gegen Ransomware und Cyber-Bedrohungen
- IoT revolutioniert Field Service: Predictive Maintenance & höherer ROI