



AImotive startet aiWare3P Neural Network Accelerator für High-Performance Automotive Vision
Ungarn-basiertes AImotive, ein Leader in Automotive KI-Lösungen, hat begonnen, seine aiWare3P Neural Network (NN) Inference Engine Intellectual Property (IP) an Schlüsselkunden auszuliefern. Der aiWare3P Kern, letztes Jahr angekündigt, liefert einen zweckgebundenen Beschleuniger für hochauflösende Automotive Vision und ist vollständig konform mit ISO26262 ASIL A, B und höher Zertifizierungsanforderungen.
Das IP ist als vollständig synthetisierbarer RTL Block verfügbar, der in ein System-on-Chip (SoC) integriert oder als Standalone-Beschleuniger deployed werden kann. Seine Low-Level-Mikroarchitektur verbraucht weit weniger Host-CPU und Shared-Memory-Ressourcen als konkurrierende GPU-basierte oder SoC-Lösungen, was niedrigere Latenz und höhere Determinismus für reale Automotive-Workloads ermöglicht.
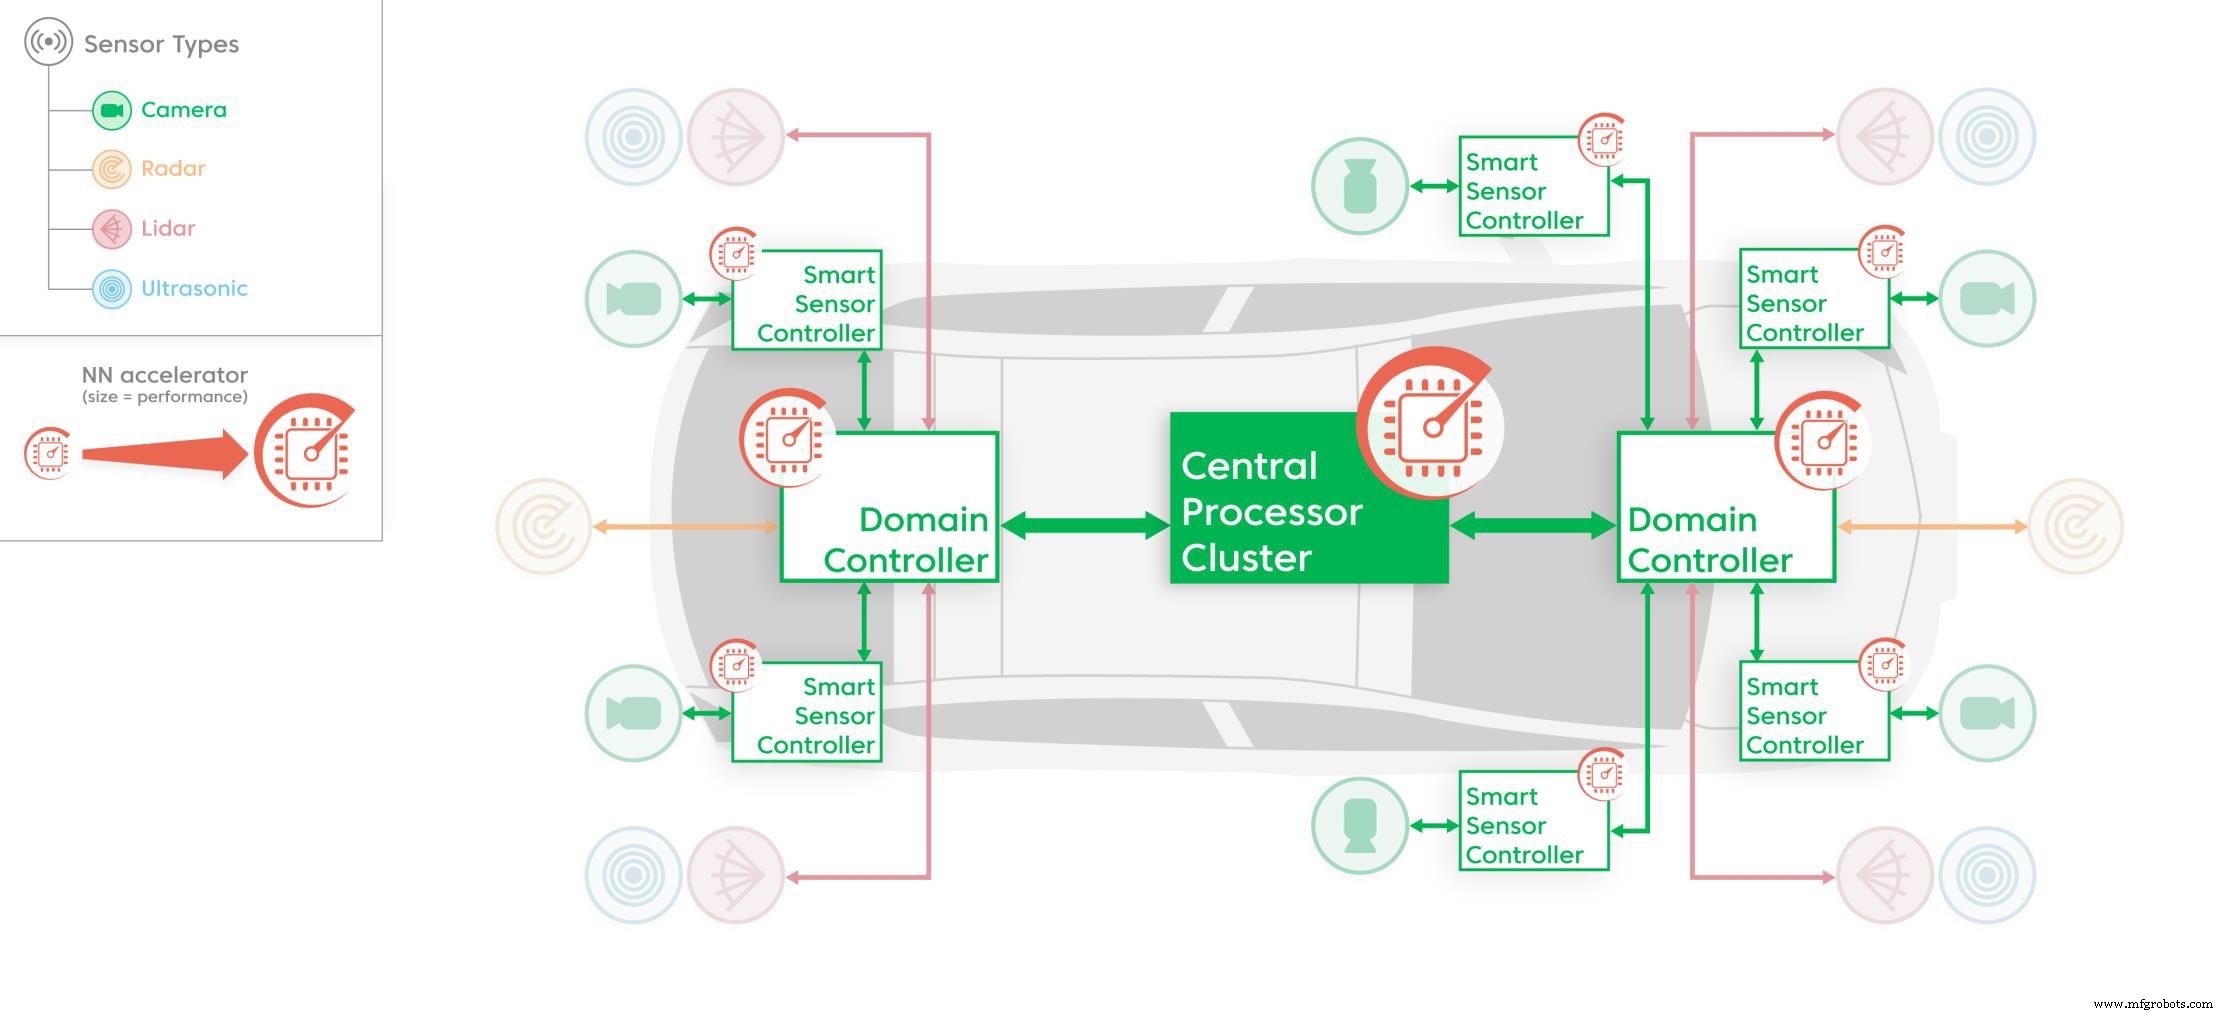 Dedizierte NN-Beschleuniger wie aiWare3P IP in verschiedenen Teilen der Fahrzeug-Elektronik-Plattform (Quelle: AImotive)
„Die meisten Chip-Vendor diskutieren Beschleuniger in akademischen Begriffen, die nicht in Produktion übersetzen“, erklärt Tony-King Smith, AImotives Executive Advisor. „Unser Design eliminiert DSPs und Network-on-Chip (NoC) Komplexität, fokussiert sich ausschließlich auf Automotive Inference. Das gibt uns ultra-niedrige Latenz von Input zu Output und befreit die Host CPU für andere Tasks.“
Der aiWare3P Kern liefert bis zu 16 TMAC/s (>32 TOPS) pro Kern bei 2 GHz, mit Multi-Core und Multi-Chip Konfigurationen, die 50+ TMAC/s (>100 INT8 TOPS) erreichen. Diese Zahlen unterstützen Multi-Kamera und heterogene Sensor-Plattformen, üblich in L2, L2+ und L3 autonomem Fahren.
Entwickelt nach AEC-Q100 Extended-Temperature Spezifikationen, beinhaltet der Kern Features, die ASIL-B und höhere Zertifizierung erleichtern. Sein patentiertes Ground-Up Design liefert hochdeterministisches Datenfluss-Management und bis zu 100× mehr On-Chip-Memory-Bandbreite als andere Beschleuniger, erreicht 95% nachhaltige Effizienz auf komplexen Deep Neural Networks (DNNs) mit großen HD Inputs.
Das aiWare SDK unterstützt Khronos NNEF und ONNX Formate, kompiliert Binaries direkt ohne Low-Level DSP oder MCU Programmierung. Es bietet automatisiertes FP32-zu-INT8 Quantisierung mit minimalem Genauigkeitsverlust und eine Suite von DNN Performance-Analyse-Tools, die Ingenieuren ermöglichen, lab-getrainte Modelle nahtlos auf Produktions-Automotive-Hardware zu übertragen.
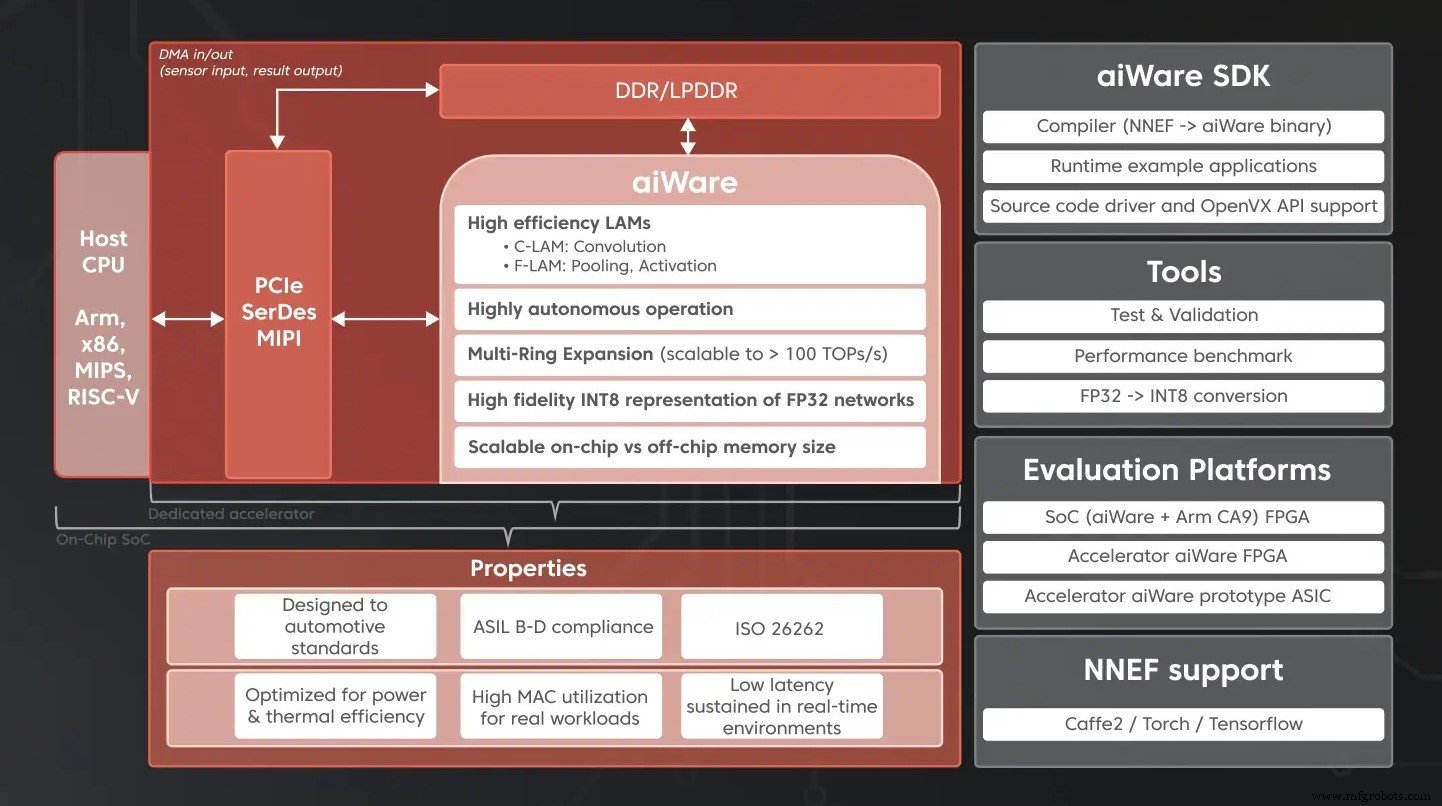 Die Bausteine eines Automotive KI-Beschleunigers, einschließlich aiWare Hardware IP (Quelle: AImotive)
Senior VP Hardware Engineering Marton Feher erklärt: „aiWare3P vereint alles, was wir über Beschleunigung neuronaler Netze für vision-basierte Automotive KI gelernt haben. Es ist jetzt eine der effizientesten Lösungen der Industrie für Massenproduktion von L2/L2+/L3 KI.“
Kunden deployen aiWare3P bereits in Produktions L2/L2+ Plattformen und erforschen fortgeschrittene heterogene Sensor Fusion. Nennenswerte Partner sind Nextchip, das den Kern in seinen Apache5 Imaging Edge Processor integriert, und ON Semiconductor, die an einer gemeinsamen Demonstration von Sensor Fusion Fähigkeiten arbeiten.
AImotive wird aktualisierte Benchmark-Ergebnisse in Q1 2020 veröffentlichen, mit Betonung auf realistischen hochauflösenden Kamera-Inputs statt synthetischer 224×224 Tests, was das Engagement für transparente, anwendungszentrische Performance-Daten unterstreicht.
Keine Host-CPU Intervention erforderlich
Neue Features unterstützen ein breiteres Portfolio vor-optimierter eingebetteter Aktivierungs- und Pooling-Funktionen, die 100% der meisten NNs ermöglichen, vollständig innerhalb des aiWare3P Kerns zu laufen. Echtzeit-Datenkompression reduziert externe Memory Bandwidth Needs, und Cross-Coupling zwischen C-LAM Convolution Engines und F-LAM Function Engines verbessert überlappende und interleaved Ausführungs-Effizienz.
Die Tile-basierte Mikroarchitektur vereinfacht physische Implementierung auf jedem Process Node durch Erleichterung von Timing-Constraints. Logisches Tile-basiertes Datenmanagement skaliert Workloads bis zum Kern-Maximum von 16 TMAC/s ohne Caches, NoCs oder andere stromhungrige Multi-Core-Ansätze, die typischerweise Determinismus und Silizium-Areal behindern.
Das RTL für aiWare3P wird ab Januar 2020 für alle Kunden verfügbar sein, begleitet von einem upgegradeten SDK mit verbesserten Compilern und Echtzeit feingranularen Hardware-Analyse-Tools.
Eingebettet
- Infineon stellt TLE985x Embedded Power Series für Automotive Motor Control vor
- Blaize stellt Graph Streaming Processor (GSP) für KI-Workloads vor
- Wie Hardware-Beschleuniger moderne KI-Systeme antreiben
- Melexis bringt ASIL-bereiten Hall-Effekt-Sensor für sicherheitskritische Automobilsysteme
- Arbe stellt ersten automobilen 30-fps 4D-Imaging-Radar-Prozessor vor
- EKF SRS-1201-BLUBRICK: Robuste Wandmontage-Box für CompactPCI Serial CPUs in Bahn, Auto und Industrie
- Portwell bringt 19″ RS4U-MTRX-1101 System für High-Performance Video Wall Applications
- Automobil-Design revolutionieren mit Kohlenstofffaser-Technologie
- Edgetek Getoughter PPA: Hitzestabile, niedrig-feuchte Compounds für Automobil-Haltbarkeit
- SGL Carbon zeigt Advanced Composites für Auto & Luftfahrt auf JEC World 2020