



Deep Learning mit FPGAs beschleunigen: Geschwindigkeit, Flexibilität und Energieeffizienz
Deep Learning mit FPGAs beschleunigen: Geschwindigkeit, Flexibilität und Energieeffizienz
Ich besuchte kürzlich das 2018 Xilinx Development Forum im Silicon Valley, wo ich Mipsology entdeckte, ein Startup, das behauptet, die KI-bezogenen Herausforderungen des Deployments von Neural Networks auf Field-Programmable Gate Arrays (FPGAs) gelöst zu haben. Gegründet mit einer mutigen Vision, demonstriert Mipsology, wie FPGAs jedes Neural Network auf höchstmögliche Performance beschleunigen können, unbehindert von traditionellen Deployment Constraints.
Mit Xilinx' neuen Alveo Boards erreichte Mipsology mehr als 20.000 Bilder pro Sekunde über eine Suite populärer Networks, einschließlich ResNet-50, Inception-V3 und VGG-19.
Was sind Neural Networks und Deep Learning?
Neural Networks, inspiriert vom Netzwerk der Neuronen im menschlichen Gehirn, bilden das Rückgrat von Deep Learning (DL). DL ist ein mathematisches Framework, das lernt, Tasks autonom auszuführen, indem es das Network großen Datenvolumen exponiert. Der Prozess des Trainierens eines Neural Networks – Präsentieren von Millionen gelabelter Samples – wird gefolgt von Inference, wo das trainierte Modell Outcomes für neue Daten vorhersagt.
Beispielsweise könnte ein Speech-Recognition Network auf Tausenden von Voice Recordings trainiert werden und dann deployed werden, um gesprochene Worte in Echtzeit zu transkribieren.
Warum Inference extreme Performance fordert
Inference erfordert Milliarden oder Billionen von Additionen und Multiplikationen pro Sekunde – weit mehr als Training, das nur einmal erfolgt. Folglich ist Inference der primäre Treiber computatonaler Nachfrage in Production AI Systemen.
Vier Hardware Optionen für Deep-Learning Inference
Engineers haben traditionell auf vier Kategorien von Prozessoren vertraut, gerankt von Most zu Least Power-Hungry und Least Flexible: CPUs → GPUs → FPGAs → ASICs. Die Tabelle unten fasst Schlüsselunterschiede zusammen.
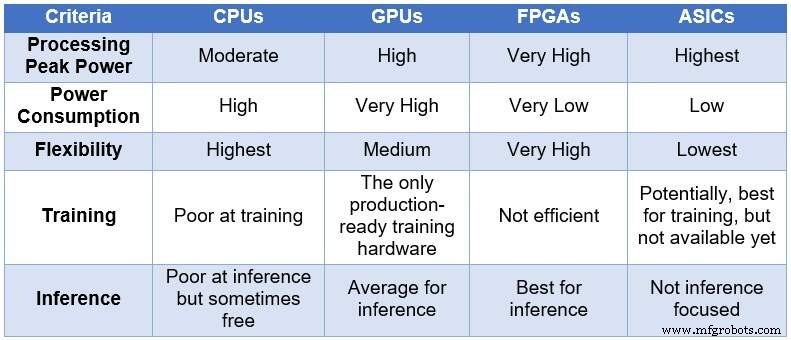
Vergleich von CPUs, GPUs, FPGAs und ASICs für DL Computing (Quelle: Lauro Rizzatti)
- CPUs bieten maximale Flexibilität, leiden aber unter hoher Latenz und niedrigem Throughput für DL Workloads.
- GPUs liefern massive Parallelität, konsumieren aber signifikante Power und benötigen robustes Cooling.
- ASICs können extrem effizient für eine enge Task sein, doch ihr langer Development Cycle und feste Architektur machen sie ill-suited für rasch evolvierende Modelle.
- FPGAs kombinieren High Throughput, Low Power Consumption und Rekonfigurierbarkeit, was sie ideal für dynamische Inference Workloads macht.
Warum FPGAs bei Inference Excelieren
Moderne FPGAs enthalten Millionen Logic Elements, Tausende DSP Blocks und Embedded Memory und ARM Cores – alle operierend in Parallel. Ein einzelner Clock Cycle kann Millionen Concurrent Operations triggern, was Trillionen Berechnungen pro Sekunde ermöglicht, die natürlich auf DL Workloads mappen.
Schlüsselvorteile von FPGAs über CPUs und GPUs umfassen:
- Support für arbiträre Data Precision, erlaubend Low-Precision Arithmetic, die Throughput boostet.
- Power Envelopes fünf bis zehn Mal niedriger als vergleichbare CPU oder GPU Lösungen für identische Workloads.
- Rekonfigurierbarkeit: Das gleiche Device kann geupdated werden, um neue Modelle zu unterstützen, ohne neues Silicon zu fabricieren.
- Device Skalierbarkeit: Von High-End Data-Center Cards bis zu kompakten Edge Modulen, FPGAs passen ein breites Range von Deployment Szenarien.
Herausforderungen und Trade-Offs
Trotz ihrer Stärken präsentieren FPGAs eine steile Lernkurve. Developing High-Performance Designs erfordert spezialisierte Hardware Description Languages und tiefes Verständnis von Parallelismus, was eine Barriere für Teams sein kann, die an Software-zentrische Workflows gewöhnt sind.
Dennoch, für Organisationen, die die Kombination aus Geschwindigkeit, Flexibilität und Energieeffizienz fordern, repräsentieren FPGAs heute die überzeugendste Plattform für Deep-Learning Inference.
Internet der Dinge-Technologie
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Neuromorphe Chips: Die nächste Frontier für AI Performance
- ICP Mustang-F100: FPGA Beschleuniger für Echtzeit Deep Learning Inferenz
- Outsourcing von KI und Deep Learning im Gesundheitswesen: Schutz der Datenschutz
- KIs Rolle bei Exponentiellem Wachstum im High-Tech-Sektor
- KI, Maschinelles Lernen und Deep Learning erklärt: Unterschiede und Funktionsweise
- Apple & IBM Watson bündeln Kräfte für Enterprise Mobile Machine Learning
- Deep Learning: Branchen durch intelligente Automation transformieren
- Unübertroffene Stabilität beim Tieflochbohren erreichen
- Deep Learning revolutioniert Inspektionsautomatisierung in Life Sciences