



Data Lake vs. Big Data: Den richtigen Ansatz für industrielle Anwendungen wählen
Data Lake und Big Data sind zwei moderne Begriffe, die oft missverstanden und falsch verwendet werden. Aufgrund der implizierten großen Datenmengen werden diese Begriffe manchmal synonym verwendet. Doch Data Lake und Big Data sind unterschiedlich, auch wenn ihre aktuellen Definitionen noch nicht vollständig etabliert sind.
Abbildung 1. Moderne Daten können aus vielen Quellen stammen und unterschiedliche Typen haben. Bild mit freundlicher Genehmigung von Analytics Vidhya
Schauen wir uns zunächst einen kurzen historischen Kontext an. Ende der 2000er Jahre, mit dem explosiven Wachstum sozialer Medien wie Facebook und Twitter, erkannten viele Data Scientists das Potenzial solcher Plattformen für die Generierung großer Mengen wertvoller persönlicher Daten. Folglich wurden neue Softwareanwendungen entwickelt, um Datenverarbeitung und -analyse zu erleichtern. Ein prominentes Beispiel ist Apache Hadoop, im Wesentlichen ein Toolkit aus Open-Source-Anwendungen, das Big-Data-Mengen verarbeiten kann.
Im nächsten Jahrzehnt trat das Internet der Dinge (IoT) auf den Plan. Dies öffnete die Türen für Millionen weiterer Datenquellen, die Einblicke in Präferenzen und Muster einer Person geben und gleichzeitig Informationen über das Produkt selbst senden können.
Gleichzeitig machte maschinelles Lernen wichtige Fortschritte und fand mehr praktische Anwendungen in der Industrielandschaft. Dies führte zu einem erhöhten Bedarf, große Datenmengen in der Industrie zu handhaben, insbesondere in automatisierten Prozessen.
Alle Prognosen deuten darauf hin, dass die Gesamtmenge der weltweit verfügbaren Daten in den kommenden Jahren weiter beschleunigt wachsen wird. Zum Referenz: 2016 überschritt die Welt die Marke von 1 Zettabyte jährlichem Internetverkehr. Ein Zettabyte entspricht 1 Billion Gigabyte.
Der jährliche Internetverkehr wird voraussichtlich 2021 3 Zettabyte überschreiten. Diese Prognosen, zusammen mit den erweiterten Fähigkeiten des Cloud Computing, deuten darauf hin, dass der Wert und die Nutzung von Big Data (und Data Lakes) vielleicht erst am Anfang stehen.
Was ist Big Data?
Betrachtet man es rein vom Volumen her, ist die Definition von Big Data ein bewegliches Ziel. Da die Datenmenge und der verfügbare Speicherplatz weiter wachsen, wächst auch der Maßstab für das, was als große Informationsmengen gilt.
Heute wird ein Datenspeicher von 100 Terabyte oder mehr allgemein als Big Data betrachtet. Große Datenspeicher wie die von sozialen Medien können im Bereich von mehreren Petabyte liegen.
Ein weiterer Referenzpunkt für die Definition von Big Data ist, wenn die Informationsmenge nicht mehr mit traditionellen Computerwerkzeugen wie SQL bewältigt werden kann. Beispielsweise erreichen Datenbanken heute nicht selten jährlich 1 Terabyte Größe. Da SQL-Anwendungen jedoch leistungsfähiger werden, kann diese Größenordnung noch verwaltet werden; daher werden sie typischerweise nicht als Big Data betrachtet.
Das 4V-Modell von Big Data
Bisher haben wir Big Data aus der Perspektive des Volumens betrachtet. Es gibt drei weitere wichtige Faktoren: Velocity (Geschwindigkeit), Variety (Vielfalt) und Veracity (Richtigkeit). Zusammen mit Volume bilden sie das 4V-Modell.
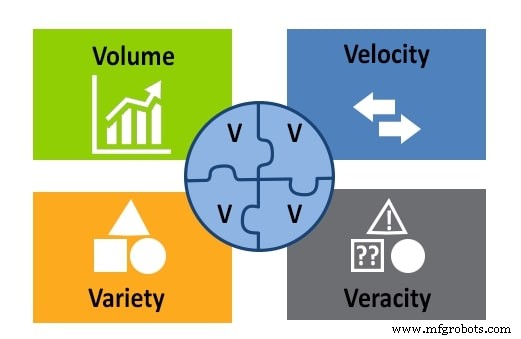
Abbildung 2. Das 4V-Modell von Big Data: Volume, Velocity, Variety, Veracity. Bild mit freundlicher Genehmigung von APSense
Variety bezieht sich auf all die verschiedenen Datentypen, die in einem Big-Data-Repository gespeichert sind: Text, Bilder, Ton, Video usw. Es bezieht sich auch darauf, dass Daten aus mehreren Quellen stammen können.
Velocity ist eine wichtige Überlegung bei Big Data, da die Informationen ständig strömen. Velocity betrifft die Geschwindigkeit, mit der Daten gesammelt, generiert und verteilt werden.
Veracity misst die Genauigkeit und Qualität der Daten, um zu bewerten, ob ein Data Scientist sie für Analysen und Schlussfolgerungen verwenden kann.
Nun, da wir Big Data verstehen, schauen wir uns Data Lakes an, bevor wir in deren Nutzung in Steuerungssysteme eintauchen.
Was ist ein Data Lake?
Data Lakes sind zentrale Repositorien für große Mengen an Rohdaten – also Informationen, die in Zukunft wertvoll sein könnten oder auch nicht, und deren Zweck noch nicht zu 100 % bekannt ist. Data Lakes können relationale und nicht-relationale Datenbanken zusammen mit anderen Dateitypen und Entitäten speichern.
Obwohl die Informationen in einem Data Lake nicht verarbeitet oder organisiert sind, sind sie so strukturiert, dass alle Ein- und Ausgänge berücksichtigt werden, um eine gute Architektur zu schaffen.
Data Lake vs. Big Data
Ein Data Lake ist eine Instanz einer Big-Data-Anwendung. Sie folgen den im 4V-Modell beschriebenen Kriterien mit einigen Besonderheiten. In Bezug auf das Volumen liegen Data Lakes im Durchschnitt am unteren Ende dessen, was als Big Data gilt.
Informationen in Data Lakes haben Vielfalt, aber mit der Bedingung, dass es sich nur um unverarbeitete Rohdaten handelt. Eingabe- und Ausgabegeschwindigkeiten sind genauso relevant wie bei jedem modernen System, und Datenqualitätsbewertungen werden in einem gut konzipierten Data Lake durchgeführt.
Industrielle Anwendungen für Daten
Fortschrittliche Automatisierung treibt einen rapiden Anstieg der Informationsmenge an, die auf dem Shopfloor verarbeitet wird. Dadurch betreten Fertigungs- und andere industrielle Prozesse nun den Bereich von Big Data, wobei mehrere Geschäftsaktivitäten Tools wie Data Lakes einsetzen.
Ein prominentes Beispiel ist Predictive Maintenance. Die Fähigkeit, einen mechanischen oder elektrischen Ausfall vorherzusagen, ist sehr wertvoll und kann erhebliche Einsparungen bei Reparaturkosten bringen. Data Lakes sind nützliche Werkzeuge, die Informationen aus Logdateien, mehreren Sensoren und Eingabegeräten zusammenstellen, um Trends zu verstehen und Probleme vorherzusagen.
Maschinelles Lernen ist ein Konzept, bei dem Roboter mit Informationen versorgt werden, die ihnen helfen, sich an wechselnde externe Bedingungen anzupassen. Die Datenerfassung ähnelt der Predictive Maintenance, mit dem zusätzlichen Schritt, dass Bewertungen und Prozessänderungen automatisch an den Systemcontroller übergeben werden. Machine-Learning-Daten können in einem strukturierten Data Lake gespeichert werden.
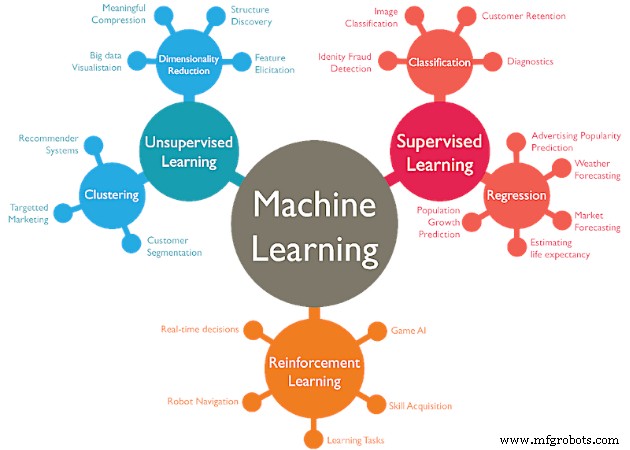
Abbildung 3. Maschinelles Lernen hat mehrere Strategien, die jeweils große Datenmengen erfordern. Bild mit freundlicher Genehmigung von WordStream
Zusammenfassend: Ein Data Lake ist eine Instanz einer Big-Data-Anwendung. Diese beiden Arten, Daten zu betrachten, können zusammenarbeiten. Durch die Nutzung sowohl von Big Data als auch von Data Lake kann ein Steuerungstechniker Ausfälle vorhersagen, Wartungsroutinen erstellen, die digitale Transformation der Anlage vorantreiben und vieles mehr.
Wofür nutzen Sie Big Data und Data Lakes in Ihrem Job?
Internet der Dinge-Technologie
- Wie vernetzte Sensoren und smarte Prozessoren Industry 4.0 antreiben
- Cervoz Guide: Selektion Reliable Flash Storage für Industrial Applications
- GE startet Predix Cloud: Dedizierte Plattform für Industriedaten & Analytik
- Zukunftsausblick: Industrial IoT für Production Excellence vorantreiben
- Top 4 Herausforderungen für das Industrial Internet of Things (IIoT)
- Sechs Schlüsselprinzipien für High-Impact Sensor-getriebene IoT-Applikationen
- RTUs für Big-Data-Einblicke in industriellen Operationen nutzen
- Fundamente für Industrial Data Science Success legen
- Industrial IoT: Von Datenerfassung zu Echtzeit-Entscheidungen
- Kann Big Data Gesundheitsbudgets revolutionieren? Lux Research Insights