



Anlagenverfügbarkeit & -zuverlässigkeit steigern mit FMEA & P-F-Kurven
Für Organisationen, die unter ungeplanten Ausfällen und Stillständen leiden, hilft die Fehlermöglichkeits- und Einflussanalyse (FMEA), hohe Anlagenverfügbarkeit und -zuverlässigkeit zu erreichen.
Zuverlässigkeit und Verfügbarkeit im Griff – und Sie sind weit auf dem Weg zur Rentabilität.
Doch Überraschung: Viele Organisationen und Hersteller gehen diesen Weg nie – und dümpeln (solange brauchbare Produkte pünktlich beim Kunden ankommen) in einer Abwärtsspirale.
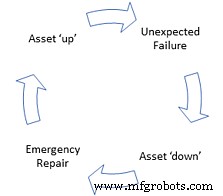
"Aber der Weg, den Sie meinen, ist RCM!" rufen sie. "Viel zu teuer für uns!"
Dieselben Hersteller haben scheinbar immer Zeit (und Geld) für Ausschuss, neue Lager, Ölbeseitigung, Maschinenreparaturen, OEM-Rufe, Überstunden. Und einmal jährlich – mit viel Pomp – ehren sie reaktive Wartungs-"Helden" mit Awards.
Hmm. Sie denken: "Leute kommen ins Firmennewsletter, Handschlag vom VP für den Erhalt des reaktiven Wartungsbetriebs?" Ja, tun sie. Aber gehen wir weiter.
Gute Anlagenverfügbarkeit und -zuverlässigkeit brauchen keine vollständige RCM-Studie. Aber sie erfordern eine gute FMEA (Failure Mode & Effect Analysis) mit guten Ergebnissen und die Anwendung von P-F-Kurven (Potential Failure to Functional Failure), um Condition-Monitoring-Techniken auf die richtigen Ausfallmodi mit der richtigen Prüfhäufigkeit zu fokussieren.
Fehlermöglichkeits- und Einflussanalyse (FMEA): An den Kern der Dinge
FMEA ist ein gängiges Analysetool, das Designern, Technikern und Ingenieuren hilft zu verstehen: Wie kann ein kritisches Asset/Component ausfallen? Welche Auswirkung auf das Gesamtsystem? Was kann die Auswirkungen mildern?
Kern der FMEA: Ausfallmodi verstehen, Eintrittswahrscheinlichkeit bewerten, mit spezifischen Wartungsmaßnahmen, Redesigns oder "Nichts tun" (bei niedrigem Risiko) adressieren.
Zwei Grundtypen:
- Bottom-Up (Hardware-Ansatz): Startet mit Auflistung aller Komponenten eines Assets und aller möglichen Ausfallarten. Aufwändiger, aber in hohen Sicherheits-/Umwelt-Risikosektoren (Luftfahrt, Nuklear) Standard. Unerwartete Ausfälle sind dort inakzeptabel.
- Top-Down (Funktionaler Ansatz): Häufiger. Betrachtet zuerst die Funktionen des Assets. Frage: "Wie kann es funktional versagen?" → führt zu Ausfallmodi → Suche nach Auswirkungen und Gegenmaßnahmen. Fokussiert direkt auf die wichtigsten Problemtreiber, nicht auf jede Einzelkomponente.
FMECA (C für Criticality) fügt einen numerischen Risikofaktor hinzu.
Beispiel: Scheibenwischer am Auto. Annahme: Keine Prüfungen, wir lassen sie versagen während der Fahrt.
| Funktion | Funktionaler Ausfall | Ausfallmodus | Potenzieller Impact | Schwere (S) | Potenzielle Ursachen | Auftreten (O) | Detektionsart | Entdeckung (D) | RPN (S×O×D) |
|---|---|---|---|---|---|---|---|---|---|
| Frontscheibe von Regen/Nebel freihalten (auf Abruf) | Startet nicht | Sicherung durchgebrannt | Auto kann Scheibe bei Starkregen nicht räumen | 10 | Fremdkörper blockiert Wischer (Überstrom → Sicherung) | 2 | Erkennung bei Ausfall (während Fahrt) | 7 | 140 |
| Empfohlene Maßnahmen | Verantwortung | Zieldatum | Durchgeführte Aktion | SEV | OCC | DET | Neuer RPN |
|---|---|---|---|---|---|---|---|
| 1. Wischer vor jeder Fahrt auf Blockaden prüfen. 2. Ersatzsicherung mitführen. |
Fahrzeughalter | Sofort | Checkliste im Auto, Ersatzsicherungen griffbereit | 10 | 2 | 2 | 40 |
Nach Maßnahmenimplementierung sinkt die Risk Priority Number (RPN).
Führen Sie FMEA/FMECA an Ihrer Anlage durch → Sie haben eine Wartungsstrategie.
Wartungsstrategie: Erhalt der inhärenten Zuverlässigkeit
Kernoutput der FMEA: Wartungsstrategie, primär WAS zu tun ist. Zeitbasierte Austausche, Condition Monitoring, Redesigns, Fehlersuchaufgaben, Inspektionen, Überholungen etc.
Zur Verfeinerung und Umsetzung: Wer macht wann was? Welche Ersatzteile?
Wichtig: Richtige Wartung zum richtigen Zeitpunkt erhält die inhärente Zuverlässigkeit des Assets auf hohem Niveau. Korrekte Wartung allein kann die inhärente Zuverlässigkeit nie über die initiale Fähigkeit hinaus verbessern – sie ist eine eingebaute Eigenschaft. Aber gute Strategie hält sie dort, wo sie hingehört: auf hohem Niveau.
Condition Monitoring & Condition-Based Maintenance: Verfügbarkeit ist König
Fokus auf Condition Monitoring (auch Predictive Maintenance): Sensoren, Daten, Information ermöglichen Verständnis der Anlagengesundheit. Treiber hinter IIoT und Industry 4.0.
Verstehen wir Anlagengesundheit zu jedem Zeitpunkt, können wir die kosteneffizienteste Wartung fahren: Condition-Based Maintenance (CBM).
Merksatz: CBM verbessert nicht die Anlagen-Zuverlässigkeit (inhärent oder sonst). Was es liefert – und genauso wichtig für Unternehmensziele ist – ist Anlagenverfügbarkeit. Allein durch Reduktion ungeplanter Stillstände steigt Verfügbarkeit.
CBM: Reparatur/Austausch basierend ausschließlich auf gemessener Anlagengesundheit. Frühwarnsignal für potenziellen/drohenden Ausfall.
Aber: Wie oft messen bei Condition Monitoring?
P-F-Kurve und Intervalle
Was ist die P-F-Kurve? Sie zeigt, wie sich Anlagengesundheit über Zeit verschlechtert, sobald ein Ausfallmodus in Gang gesetzt ist.
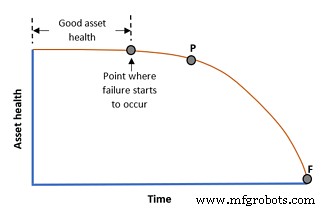
Der horizontale Abschnitt: Gute Anlagengesundheit. Verlängerbar durch Maintenance Best Practices in:
- Asset-Installation
- Fundamente & Tragstrukturen
- Asset-Schmierung
- Asset-Ausrichtung & Wuchten
- Richtiger Betrieb innerhalb Asset-Kapazität
Dann tritt ein Ausfallmodus auf: Startpunkt, noch unsichtbar bei Datenerfassung.
Zeit (oder Belastungszyklen) schreitet fort zu Punkt P = Potential Failure. Hier beginnen Condition-Monitoring-Techniken, potenziellen Ausfall zu detektieren. Anlagengesundheit degradiert (graduell oder rapide) bis Punkt F = Functional Failure. Spiel aus – reaktive "Helden" ran.
Zeitdifferenz P zu F = P-F-Intervall. Sekunden bis Jahrzehnte – abhängig von Ausfallmodus und Asset.
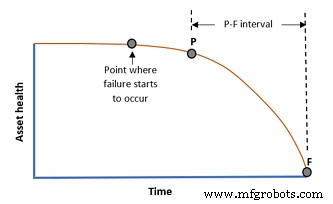
Wichtig: P-F-Intervall für einen spezifischen Ausfallmodus ist immer ein Durchschnittswert – statistische Streuung existiert immer.
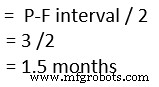
Haben Sie eine gute Schätzung (aus Vergangenheitsausfällen, RCAs, OEM-Daten), setzen Sie das Prüfintervall. Faustregel: Mindestens halb so lang wie das erwartete P-F-Intervall.
Beispiel: Kritisches Pumpen-Lager vibriert bei 8 mm/s → ca. 3 Monate Restlebensdauer bis Festfressen. Wie oft Vibration messen?
Prüfintervall ≤ 3 Monate / 2 = 1,5 Monate. (Konservative Empfehlung oft: 1 Monat – wegen statistischer Streuung.)
Verschiedene Condition-Monitoring-Techniken geben unterschiedliche Frühwarnstufen im P-F-Intervall. Keine Einzeltechnik deckt alle Ausfallmodi ab.
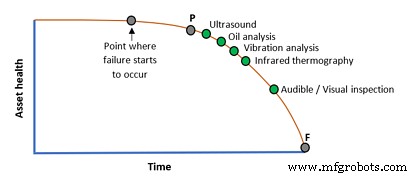
Beste Strategien kombinieren mehrere Condition-Monitoring-Technologien.
Der Weg zur präskriptiven Wartung
Abschließender Blick auf IIoT/Industry-4.0-Fortschritt: Der Weg zur Präskriptiven Wartung (Prescriptive Maintenance, RxM).
|
Präskriptive Wartung (Rx) unterscheidet sich von Predictive Maintenance (PdM): Statt nur drohenden Ausfall vorherzusagen, liefert sie ergebnisorientierte Empfehlungen für Betrieb und Wartung aus Rx-Analytics. RxM steckt noch in Kinderschuhen, aber viele Vordenker sehen Potenzial für die nächste Stufe von Reliability- und Maintenance-Best-Practice.
|
"Was ist das?" fragen Sie. Nächste Frontier nach Predictive Maintenance: Prescriptive Maintenance.
Können Sie sich vorstellen? Sensoren, Netze, Algorithmen, Machine Learning, KI sagen Ihrem Wartungsteam WAS sie tun müssen und WANN – für Zuverlässigkeit und Verfügbarkeit. Oder sogar: Wie Asset managen (Drehzahlen, Lasten) um Restnutzungsdauer zu verlängern, sobald potenzieller Ausfall detektiert ist.
Zukünftige Wartungsstrategien werden flüssig, anpassbar, intelligent informiert durch Technologie und menschlich erstellte FMEAs, P-F-Intervalle, OEM-Troubleshooting-Guides.
Wir sind noch nicht da. Aber es kommt...
Weiterlesen: Umfassender Leitfaden zu IIoT in der Instandhaltung
Internet der Dinge-Technologie
- Aktuelles Datum und Uhrzeit in Python abrufen: Praktischer Leitfaden
- In Wartung investieren: Eine bewährte ROI-Strategie für Zuverlässigkeit und Kapazitätswachstum
- Wie Beschilderung & Kennzeichnung Zuverlässigkeit fördern: Praktische Strategien für Wartung & Sicherheit
- Zuverlässigkeit steigern, Downtime senken: Machine Learning transformiert Maintenance
- Wie IoT Kinder mit Autismus-Spektrum-Störung beim Lernen, Spielen und Gedeihen unterstützt
- IoT mit IBM & Tech Data zum Leben erwecken – Teil 2
- IoT in die Realität umsetzen: Tech Data & IBM Insights – Teil 1
- Internationalen Versand meistern: Praktischer Leitfaden für Händler & Hersteller
- Wesentliche Maschinenausfall-Ursachen identifizieren und Strategien zur Vermeidung von Stillstand
- Maschinenverfügbarkeit meistern: Berechnung und Strategien zur Steigerung