



Optimierte Dokumentenverarbeitung: Regelbasierte & modellbasierte Techniken für präzise Automatisierung kombinieren
Information ist Macht. Für die meisten Unternehmen ist wertvolle Geschäftsinformation in Dokumenten gefangen. Angesichts der Vielfalt an Dokumenttypen, -größen und -formaten, die Unternehmen oft verwalten, kann die effiziente Verarbeitung von Dokumenten zur Gewinnung von Erkenntnissen herausfordernd sein.
Hier bei UiPath verstehen wir diese Herausforderung. Dank unseres neuesten Document-Understanding-Frameworks können unsere Kunden Datenextraktion und -verarbeitung für eine breite Palette von Dokumenten einfach automatisieren – unabhängig von Typ, Format oder Volumen. Dies hilft Ihnen, Dokumentenverarbeitung flexibel anzugehen, indem Sie den Prozess nutzen, der für Ihre individuellen Bedürfnisse am besten funktioniert.
Für einen übergeordneten Blick auf die Vorteile von Document Understanding lesen Sie unser Whitepaper Betriebseffizienz steigern und Risiken mit Document Understanding mindern.
In diesem Artikel werden wir:
Gängige Dokumenttypen und -klassifikationen überprüfen
Regelbasierte und modellbasierte Datenextraktionsmethoden untersuchen
Die häufigen Herausforderungen betrachten, denen Unternehmen bei der Anwendung dieser Standardansätze begegnen
Die Vorteile prüfen, die Unternehmen erzielen, wenn beide Dokumentenverarbeitungsansätze als Multi-Ansatz-Datenextraktionsmethode kombiniert werden
Lassen Sie uns beginnen.
Dokumentenlandschaft
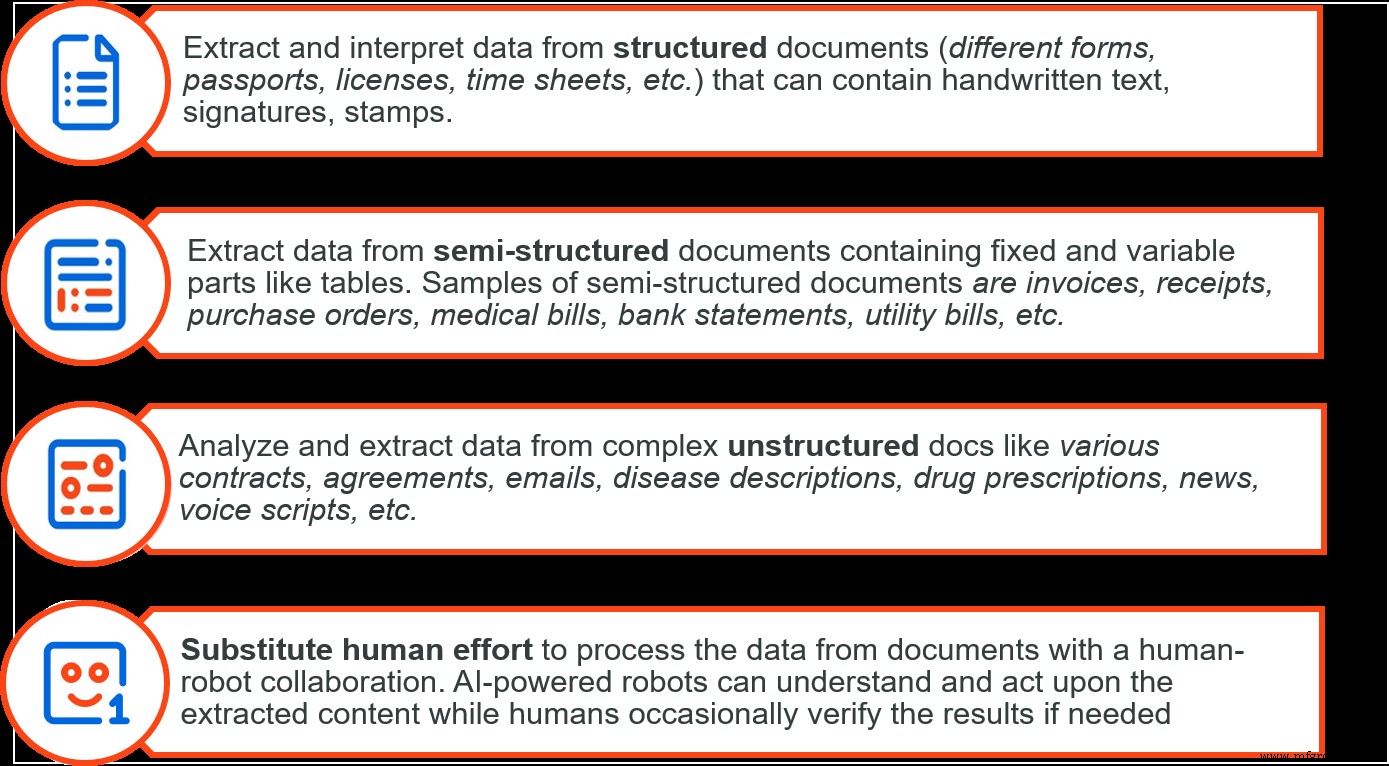
Abhängig von ihrer Struktur und ihrem Format können Dokumente in drei Typen klassifiziert werden.
1. Viele Dokumente, wie Steuerformulare, bleiben im Format fix – diese werden strukturierte Dokumente genannt.
2. Andere, wie Verträge, haben keine Standardstruktur – diese werden als unstrukturierte Dokumente bezeichnet.
3. Schließlich Dokumente, die unterschiedliche Eigenschaften haben, wie variierende Layouts oder Designs, aber ähnliche Arten von Informationen enthalten, werden halbstrukturierte Dokumente genannt. Quittungen, Rechnungen und Bestellungen sind gängige Beispiele für Dokumente in dieser Kategorie.
Basierend auf der Klassifikation von Dokumenten gibt es zwei gängige Arten von Datenextraktionsmethodologien. Regelbasierte Datenextraktion zielt auf strukturierte Dokumente ab, während modellbasierte Datenextraktion zur Verarbeitung halbstrukturierter und unstrukturierter Dokumente verwendet wird.
Vorteile und Grenzen regelbasierter Datenextraktionsmethoden
Regelbasierte Datenextraktion basiert auf einem Regelwerk, um Daten aus einem Dokument zu extrahieren. Beispielsweise können Sie Dokumentvorlagen erstellen und Regeln basierend auf spezifischen Datenpositionen anwenden. Alternativ, ohne Vorlagen erstellen zu müssen, können Sie einfach Regeln basierend auf der Häufigkeit anwenden, mit der bestimmte Datensätze in einem Dokument verwendet werden (Vorkommensmuster) oder wie diese Datenvariablen normalerweise in einer Zeichenfolge aussehen (reguläre Ausdrücke oder Regex).
Ersteres ist hilfreich beim Umgang mit Formularen, die vorlagisiert werden können, und Letzteres wird verwendet, wenn es möglich und einfach ist, solche Regeln zu erstellen. Wir stellen fest, dass regelbasierte Methoden einfach einzurichten und zu verstehen sind und in der Dokumentenverarbeitung sehr effizient arbeiten. Sie sind jedoch auf strukturierte Dokumente und nur in wenigen einfachen Fällen auf halbstrukturierte Dokumente beschränkt.
So vorteilhaft regelbasierte Datenextraktionstechniken in vielen Kontexten sind, sie haben offensichtliche Anwendungsgrenzen. Da template-basierte Extraktion eng an ein festes Dokumentlayout gebunden ist, können Layoutänderungen die Regeln brechen und eine Neukonfiguration erfordern.
Ebenso können regex-basierte Techniken schwierig zu implementieren, zu troubleshooten und umständlich werden, wenn Situationen komplexer werden. Es gibt jedoch einen alternativen Ansatz zu regelbasierten Extraktionslösungen – einen modellbasierten Ansatz.
Vorteile und Grenzen modellbasierter Datenextraktionsmethoden
Modellbasierte Datenextraktionsmethodologien basieren auf Machine Learning (ML). Diese Methoden sind mächtig aufgrund ihrer Fähigkeit, aus einer vielfältigen Menge von Dokumenten zu lernen. Wir nutzen diese Methoden durch den Einsatz anspruchsvoller Techniken wie Natural Language Processing (NLP) und statistischem Lernen.
Die UiPath Validation Station rüstet Benutzer mit Human-in-the-Loop-Fähigkeiten aus, sodass Modelle on-the-fly lernen und sich an Datenänderungen anpassen können. KI-gestützte Technologie wird typischerweise für Datenextraktion aus halbstrukturierten und unstrukturierten Dokumenten verwendet. Wir haben beispielsweise ML-Modelle für unser Document-Understanding-Framework erstellt, um Szenarien wie Quittungs- und Rechnungsverarbeitung zu adressieren.
Weiterlesen: KI zur Automatisierung von Rechnungs- und Quittungsverarbeitung nutzen
Die Herausforderung bei der Nutzung modellbasierter Extraktionsmethoden ist die Zeit und Expertise, die sie für die Erstellung und Implementierung von ML-Modellen erfordern können. In vielen Szenarien sind modellbasierte Techniken jedoch in ihrer Fähigkeit überlegen, sich an unterschiedliche Dokumentstrukturen und -inhalte anzupassen und zu lernen.
Multi-Ansatz-Datenextraktion annehmen
Es gibt keine Silver Bullet, um alle Dokumentenverarbeitungsbedürfnisse zu adressieren. Sowohl regelbasierte als auch modellbasierte Ansätze für Datenextraktion sind potente Werkzeuge, aber in ihrer Fähigkeit begrenzt, die Bandbreite der Dokumente, die Unternehmen verwalten, optimal zu verarbeiten.
Einige strukturierte Dokumente benötigen möglicherweise weit mehr als nur regelbasierte Methodologien, da manche Daten nicht mit Regeln oder Vorlagen extrahiert werden können. Ebenso funktionieren rein modellbasierte Methoden nicht für alle unstrukturierten und halbstrukturierten Dokumente.
Wir möchten, dass Benutzer verschiedene Ansätze einfach kombinieren können, um Informationen aus einem einzelnen Dokument zu extrahieren. Deshalb haben wir unser Document-Understanding-Framework so gestaltet, dass es Ihnen die Macht gibt, Einschränkungen jedes einzelnen Ansatzes zu überwinden. Wir empfehlen dringend, Multi-Ansatz-Datenextraktion zu nutzen, wenn Sie es mit komplexen Dokumenten zu tun haben und höchste Genauigkeitsstufen bei der Datenextraktion erreichen möchten.
Schnelle und präzise Multi-Ansatz-Datenextraktion
Mit unserem flexiblen Framework können Sie Dokumentenverarbeitungsansätze mischen und anpassen, indem Sie einfach mehrere Datenextraktionstechniken direkt in Ihren Workflow in UiPath Studio ziehen.
Sie können Extraktoren für die Datenverarbeitung einfach konfigurieren, eine Präferenzreihenfolge für die Extraktionsausführung festlegen und einen Schwellenwert für bestimmte Extraktionsergebnisse definieren, die als gültig akzeptiert werden. So stellen weder variable Dokumentstrukturen noch komplizierte Regeln für Datenextraktion mehr eine Herausforderung dar. Gleichzeitig erhalten Sie innerhalb der End-to-End-Automatisierung schnellere und deutlich präzisere Dokumentenverarbeitung mit neuester KI-Technologie.
Interessiert?
Effiziente und präzise Dokumentenextraktions- und -verarbeitungsfähigkeiten sind entscheidend. Durch unseren Fokus auf Multi-Ansatz-Datenextraktion möchten wir Dokumentenverarbeitung und -analyse für UiPath-Kunden so einfach wie möglich machen.
Derzeit sind erweiterte Document-Understanding-Funktionen als Software-as-a-Service (SaaS) in einer Beta-Version für Nutzer verfügbar, die an früheren Piloten beteiligt waren. Sie können erwarten, dass diese Funktionen und andere fortschrittliche Document-Understanding-Tools bald verfügbar sein werden. In der Zwischenzeit ermutigen wir Sie, sich für die UiPath Enterprise-Testversion anzumelden, um Zugriff auf die UiPath Document Understanding Lösung zu erhalten.
Automatisierungssteuerung System
- U.S. Army treibt Condition-Based Maintenance mit innovativen Sensoren und Predictive Analytics voran
- Hygienic Design für Lebensmittel- & Verarbeitungsindustrie: Von Reinigbarkeit zu Kosteneinsparungen
- Wie IIoT & Data Analytics EHS transformieren: Sicherheit, Effizienz und Einsparungen steigern
- Wie Sensordaten & Betriebsdaten die Profitabilität eines führenden Lkw-Herstellers steigern
- Edge AI: Warum die Verarbeitung auf die Geräteebene verlagert wird
- Fog Computing erklärt: IoT-Datenfluss transformieren & Cloud-Last reduzieren
- Flottenmanagement revolutionieren: KI & IoT-Integration für intelligentere Operationen
- ABB enthüllt hochmoderne Cloud-Automatisierung für Rechenzentren
- Ambarella, Lumentum und ON Semiconductor präsentieren KI-gesteuerte 3D-Sensing-Lösungen für KIoT-Geräte der nächsten Generation
- Industrial IoT & Predictive Analytics: Fertigungseffizienz beschleunigen