



FRACAS: Anlagenausfälle in Geschäftserfolge verwandeln
In der Wartung wird Ausfall typischerweise als negatives Ergebnis gesehen, und Teams spüren oft den Druck von Ausfallzeit-Kennzahlen. Doch diese Denkweise kann kontraproduktiv und ungerecht sein. Viele Faktoren – wie Anlagenalter, Designlimitierungen oder Bedienfehler – liegen außerhalb der unmittelbaren Kontrolle. Strategisch betrachtet wird Ausfall zu einer wertvollen Erkenntnisquelle.
„Man braucht Ausfall, um sich zu verbessern“, sagt Thibaut Drevet, Solutions Engineer bei Fiix und ehemaliger Industrie- und Wartungsingenieur. „Ausfall hilft Ihnen, die Systeme zu verstehen, die Sie warten, wie sie operieren und wie Sie sie warten können.“
Dieser Artikel erklärt, wie ein FRACAS – Failure Reporting, Analysis, and Corrective Action System – jeden Ausfall in eine Lernchance verwandelt, die Geschäftsergebnisse antreibt.
Was ist FRACAS?
FRACAS ist ein Closed-Loop-Reporting-Framework, das Anlagenausfälle durch drei Kernphasen erfasst, interpretiert und eliminiert:
- Ausfallmeldung – Identifikation der exakten Anlage und des Ausfallereignisses.
- Ausfallanalyse – Lektionen aus dem Vorfall extrahieren.
- Ausfallkorrektur – Änderungen implementieren, die Wiederholung verhindern.
Durch die Aggregation von Performancedaten über Zeit identifiziert FRACAS wiederkehrende Fehlermuster und informiert die gesamte Zuverlässigkeitsstrategie – vom Design bis zur Wartungsplanung.
FRACAS aufbauen: Der kontinuierliche Loop
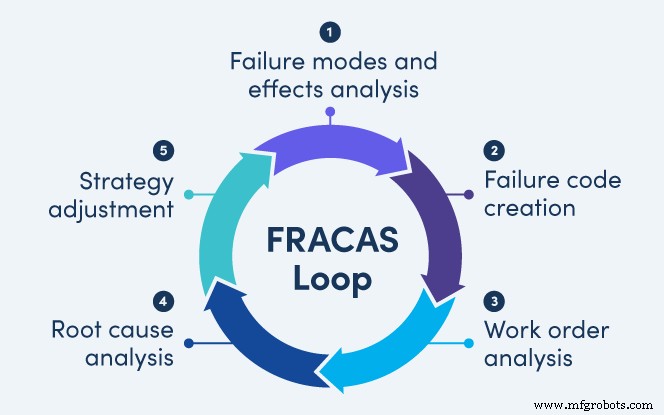
Der FRACAS-Loop ist eine wiederholbare Reihe von Aktivitäten, die Sie kontinuierlich lernen und verbessern lässt:
- Fehlermöglichkeits- und Einflussanalyse (FMEA)
- Fehlercode-Erstellung
- Arbeitsauftragsanalyse
- Ursachenanalyse (RCA)
- Strategieanpassung
Fehlermöglichkeits- und Einflussanalyse (FMEA)
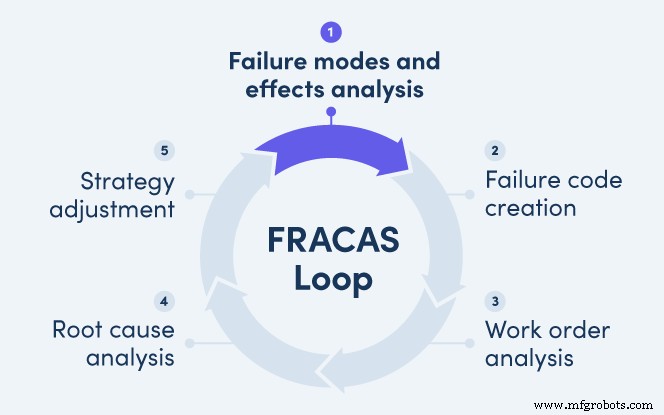
FMEA ist ein präventives Tool, das jeden erdenklichen Ausfallmodus, seine Auswirkung und Minderungsschritte auflistet. Eine typische FMEA enthält zehn Schlüsselelemente:
- Anlagenkomponente
- Potenzielle Ausfallmodi
- Potenzielle Ausfalleffekte
- Ausfallschweregrad
- Potenzielle Ursachen
- Erwartete Ausfallhäufigkeit
- Aktuelle Erkennungs- und Präventionsprozesse
- Erkennbarkeit
- Gesamtrisiko
- Empfohlene Maßnahme
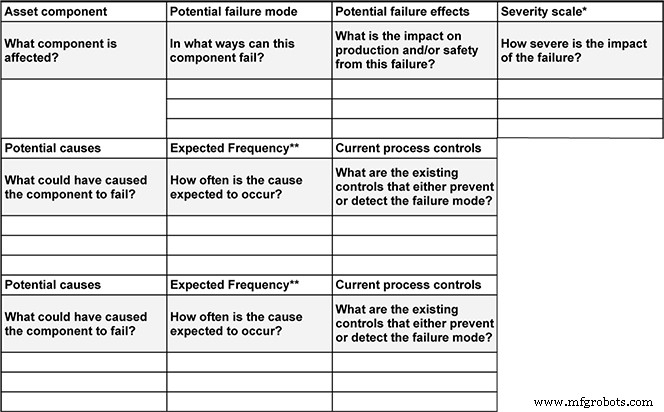
Laden Sie Ihre eigene FMEA-Vorlage hier herunter
FMEA ist das Fundament von FRACAS. Es priorisiert Maßnahmen basierend auf Anlagenkritikalität, Auswirkung und verfügbaren Ressourcen und entwickelt sich weiter, sobald neue Daten entstehen.
Fehlercode-Erstellung
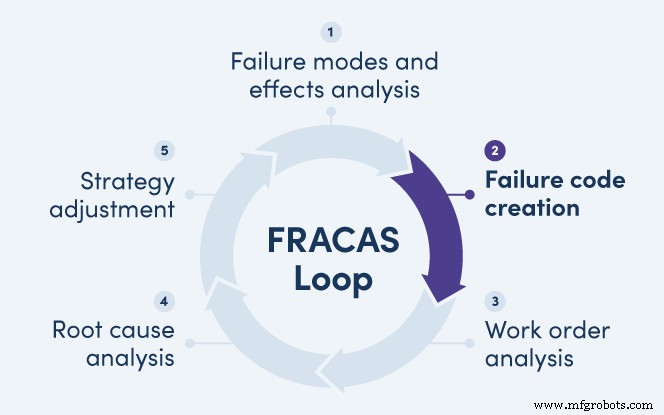
Fehlercodes destillieren komplexe Vorfälle in prägnante Identifikatoren – z. B. „Lager, Verschleiß, Schmierungsmangel“.
- Klare Benennungskonvention für jedes Teil nutzen, um Verwirrung zu vermeiden.
- Defekte nach Zustand (Verschleiß, Überhitzung etc.) gruppieren für Klarheit.
- Vorgefertigte Codes auf die häufigsten beschränken – über zehn können den Fokus verwässern.
- Codeliste mit Technikern validieren, um Relevanz zu sichern.
Das Tracking von Codes deckt Trends auf und ermöglicht es, die kostspieligsten Ausfälle zuerst anzugehen.
Arbeitsauftragsanalyse
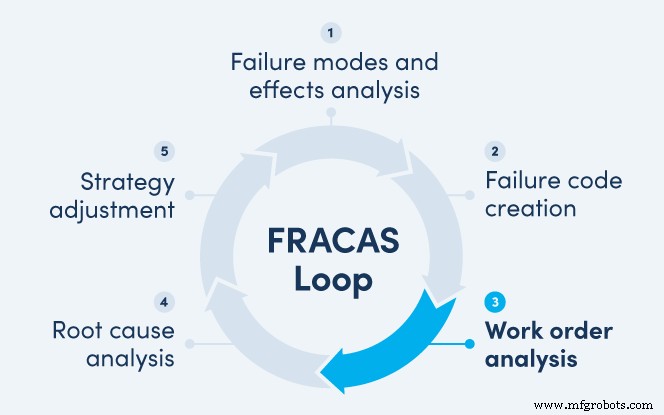
Einzelne Vorfälle sind Ärgernis; wiederholte Muster deuten auf systemische Probleme hin. Durch die Prüfung von Fehlercodes und Abschlussnotizen können Sie hochfrequente Probleme identifizieren.
Beispiel: Vier Maschinen verzeichneten 12 Ausfälle in sechs Monaten, 10 davon auf Lagerfestfressen durch Fehlausrichtung zurückzuführen. Die Reduzierung auf zwei in den nächsten sechs Monaten signalisiert, dass Korrekturmaßnahmen wirken.
Zusätzliche Analysemethoden finden Sie in unserem Leitfaden zu Arbeitsauftragsdaten.
Ursachenanalyse (RCA)
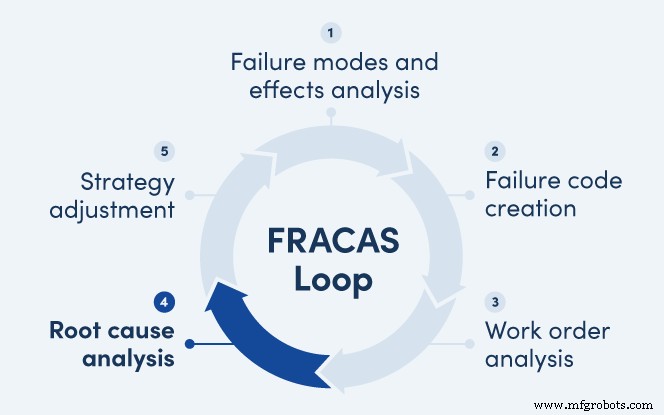
RCA extrahiert langfristigen Wert aus Fehlerbehebung. Ein einfacher Fix, der sich wiederholt, verschwendet Zeit, Geld und Teile.
Am Beispiel des fehlausgerichteten Lagers könnte eine 5-Warum-RCA offenbaren:
- Warum? Das Lager war fehlausgerichtet, weil die Welle fehlausgerichtet war.
- Warum? Die Maschine wurde falsch montiert.
- Warum? Der Techniker hetzte bei der Montage.
- Warum? Dem Techniker fehlte ausreichend Zeit.
- Warum? Das Wartungsfenster vor Produktion war zu eng.
Thibaut rät, diverse Teams für RCA zusammenzustellen, um voreilige Schlüsse zu vermeiden.
Strategieanpassung
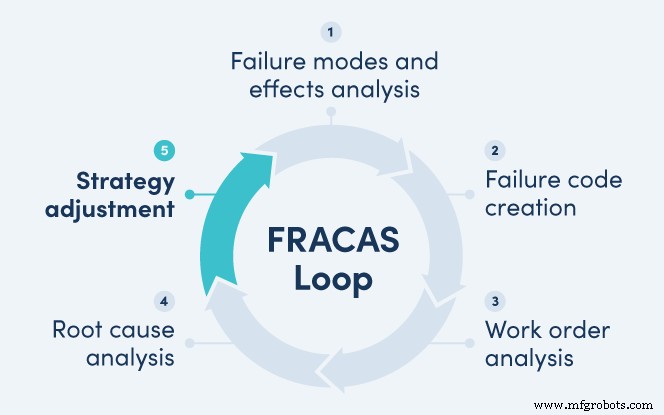
Erkenntnisse müssen in Aktion übersetzt werden. Anpassungen können geringfügig sein – Schmieranweisungen hinzufügen – oder umfangreich, wie die Einstellung von Spezialisten für Aufgaben jenseits der Team-Expertise.
- Techniker einbeziehen: Rationale und erwartete Vorteile teilen. Siege feiern, wie einen 40-%-Rückgang nachtschichtiger Anrufe.
- Ergebnisse überwachen: Unbeabsichtigte Nebeneffekte früh erkennen und iterieren bis zum Erfolg.
- Schrittweise skalieren: Änderungen an einer Maschine testen, bevor Rollout im gesamten Werk.
Den Loop schließen
Nach der Implementierung von Änderungen den FRACAS-Zyklus erneut durchlaufen:
- FMEA mit neuen Ausfällen und Minderungen aktualisieren.
- Fehlercodes auditieren – hinzufügen, entfernen oder verfeinern nach Bedarf.
- Wirkungsberichte generieren: Reduktion der Ausfallhäufigkeit, Kosteneinsparungen und Planungsverbesserungen tracken.
Hochwertige Daten für FRACAS sicherstellen
Verlässliche Daten sind das Lebenselixier von FRACAS. So sichern Sie sie.
Eine Wartungs-Wert-Kultur schaffen
Datenungenauigkeiten resultieren oft aus hetzenden Technikern. Eine Kultur, die Wartung als Produktions-Enabler anerkennt, fördert sorgfältige Dateneingabe.
„Wartung ist nicht der Feind der Produktion“, sagt Thibaut. „Wenn alle ihren Wert sehen, nehmen sich Techniker die Zeit, präzise Informationen zu loggen.“
Klare, einfache Arbeitsaufträge gestalten
Mehrdeutige oder dichte Arbeitsaufträge züchten Fehler. Vereinfachen Sie durch:
- Bilder und Diagramme für Komponentenidentifikation.
- Klare Benennungskonventionen.
- Einen prägnanten Reporting-Workflow.
Starter-Ressourcen:
- Grundlagen meistern: Wartungsarbeitsaufträge
- Arbeitsaufträge gestalten, die Ihre Ziele erreichen
- Wartungsarbeitsauftrag-Vorlage
- Anlagenwartungslog-Vorlage
- Präventivwartungs-Checkliste
Automatisieren und integrieren
Condition-Monitoring-Software ersetzt manuelle Zählerablesungen durch Echtzeitdaten und eliminiert das Risiko, verschobene Werte aufzuzeichnen.
Die Integration dieser Daten in Ihre Wartungsplattform ermöglicht sofortige Alerts und konsolidierte Analyse.
Regelmäßige Daten-Audits
Monatliche Spot-Checks und Techniker-Interviews decken systemische Datenlücken auf. Fragen Sie:
- Ist eine Inspektionsaufgabe unnötig? Falls ja, entfernen oder begründen Sie sie.
- Wissen Techniker, was sie loggen sollen und warum?
- Ist der Dateneingabeprozess benutzerfreundlich?
Fünf FRACAS-Berichte, die Ergebnisse liefern
Nutzen Sie diese Berichte, um Ausfälle zu identifizieren, die Produktion und Profitabilität behindern.
- Ausfälle nach Anlauf – Probleme identifizieren, die Produktion stoppen, bevor sie beginnt.
- Wartungskosten nach Fehlercode – Arbeits- und Teilkosten summieren, um hochwirksame Ausfälle zu priorisieren.
- Wartungsstunden nach Fehlercode – Zeitintensive wiederkehrende Reparaturen identifizieren.
- Ausfälle in geplanter vs. ungeplanter Wartung – Treiber reaktiver Wartung hervorheben.
- Ausfälle nach Schicht oder Standort – Prozess- oder Trainingslücken erkennen, die anderswo replizierbar sind.
FRACAS-Erfolgsgeschichten aus der Praxis
FRACAS kann über ein Dokument hinaus zu einem Kulturwandel werden. Beispiele:
- Identifikation häufiger Ausfälle durch alte Teile deckte versteckte Kosten auf und ermöglichte ein stärkeres Inventarbudget.
- Entdeckung eines neuen Ausfallmusters nach Linienänderung führte zu einem überarbeiteten Kommunikationsprozess, der Ausfallzeiten über mehrere Standorte senkte.
- Priorisierung eines einzelnen hochwirksamen Ausfalls im Quartal sicherte Finanzierung zur Teamerweiterung, was weitere Probleme bereinigte.
Fazit
FRACAS aufzubauen erfordert Daten, Zeit und nachhaltiges Commitment. Klein anfangen, frühe Siege feiern und dranbleiben. Der langfristige ROI – reduzierte Ausfallzeiten, niedrigere Wartungskosten, resilientere Operationen – rechtfertigt den Aufwand.
Gerätewartung und Reparatur
- Implementierung von Total Productive Maintenance (TPM): Ein bewährter 12-Schritte-Plan für Null Ausfälle
- EZ Maintenance Web führt Echtzeit-Alarme auf Pager, PDAs und Handys ein
- Ehemaliger Intel-Ingenieur teilt bewährte Root-Cause-Analyse-Techniken
- Maschinelles Lernen für Predictive Maintenance: Revolution der Asset-Zuverlässigkeit
- Informationsmanagement meistern, um Instandhaltungsleistung zu steigern
- Ersatzteildatenbank pflegen und bereinigen: Best Practices und Kostenschätzungen
- Maßgeschneiderter Grabensicherheitsplan für Ihre Baustelle erstellen
- Lkw-Flottenkosten senken: Bewährte Strategien für mehr Profitabilität
- Women in Reliability: Die Zukunft bei Xcelerate 2026 gestalten – Teil 1
- Experten-Reparaturen für Mitsubishi Industrieelektronik: Legacy & moderne Systeme