



Gewichts-Updates und Backpropagation in Multilayer Perzeptrons meistern
In diesem Artikel präsentieren wir die präzisen Gleichungen für Gewichts-Update-Berechnungen und erklären, wie Backpropagation einen Multilayer Perzeptron (MLP) befähigt, aus Daten zu lernen.
Willkommen zu AAC's umfassender Machine-Learning-Serie.
Holen Sie den bisherigen Serienstand hier nach:
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
Wir haben den Kern der Neuronalnetz-Theorie erreicht: die computergestützten Schritte, die die Gewichte eines MLP so feinjustieren, dass es Input-Samples akkurat klassifizieren kann. Dieser Prozess ist das Fundament des Backpropagation-Algorithmus, ein Eckpfeiler modernen Deep Learning.
Gewichte aktualisieren
MLP-Training ist mathematisch dicht, und Terminologie variiert across Quellen. Die untenstehenden Gleichungen stammen aus Dr. Dustin Stansburys klaren Herleitungen, was sie zu exzellenter Referenz für Einsteiger und Praktiker macht.
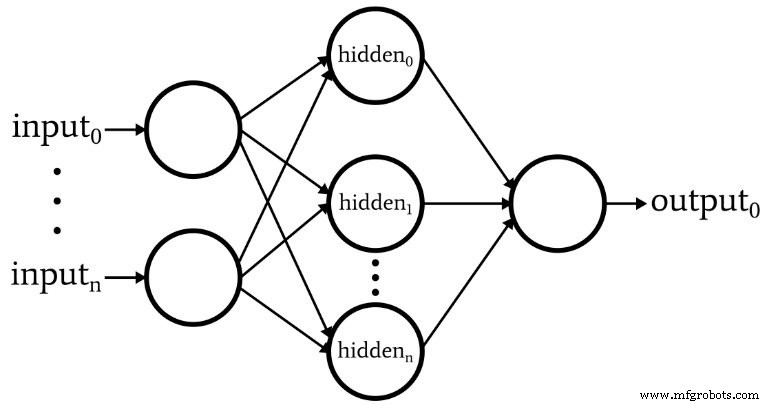
Das Diagramm zeigt die Architektur, die wir in Code implementieren, und die folgenden Gleichungen mappen direkt auf diese Struktur.
Terminologie
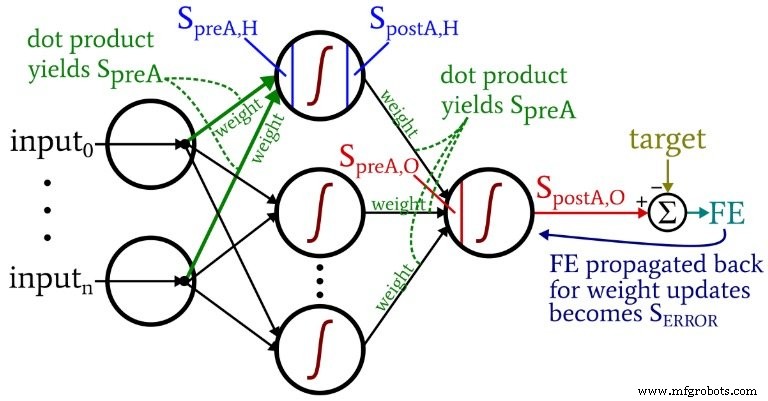
- Pre-Aktivierung (SpreA): Der gewichtete Summen-Eingang zur Aktivierungsfunktion eines Neurons, berechnet als Dot Product eingehender Gewichte und Aktivierungen.
- Post-Aktivierung (SpostA): Der Output des Neurons nach Anwendung der Aktivierungsfunktion fA(·). Wir nutzen die logistische (Sigmoid) Funktion in unseren Beispielen.
- Gewichtsmatrizen: Im Code benennen wir sie ItoH (Input-to-Hidden) und HtoO (Hidden-to-Output) zur Vermeidung von Ambiguität.
- Target (T): Der korrekte Output für ein Trainingsample.
- Lernrate (LR): Die Schrittweite für Gewichtsupdates.
- Finaler Fehler (FE): SpostA,O – T.
- Fehlersignal (SERROR): FE multipliziert mit der Ableitung der Output-Neuron-Aktivierungsfunktion.
- Gradient: Der Beitrag eines spezifischen Gewichts zum Fehlersignal; wir subtrahieren LR × Gradient vom aktuellen Gewicht.
Das begleitende Diagramm illustriert diese Konzepte im Kontext.
Gewichts-Update-Gleichungen resultieren aus der partiellen Ableitung des Sum-of-Squared-Error nach jedem Gewicht. Für Hidden-to-Output Gewichte:
SERROR = FE × fA'(SpreA,O)
gradientHtoO = SERROR × SpostA,H
weightHtoO ← weightHtoO – (LR × gradientHtoO)
Für Input-to-Hidden Gewichte muss der Fehler eine zusätzliche Layer durchlaufen:
gradientItoH = SERROR × weightHtoO × fA'(SpreA,H) × input
weightItoH ← weightItoH – (LR × gradientItoH)
Backpropagation
Backpropagation löst das Hidden-Node-Dilemma: Obwohl Input-to-Hidden Gewichte den finalen Output nur indirekt beeinflussen, können wir ihren Effekt berechnen, indem wir das Fehlersignal rückwärts durch das Netzwerk propagieren und mit ausgehenden Gewichten und Aktivierungsableitungen skalieren. Diese Technik ist fundamental für Deep Model Training.
Fazit
Wir haben die Schlüssengleichungen für Gewichtsupdates und die Mechanik von Backpropagation in MLPs aufgepackt. Diese Konzepte untermauern jede moderne Neuronalnetz-Anwendung, und ihre Beherrschung öffnet die Tür zu fortgeschrittenem Modeling. Bleiben Sie dran für die nächsten Folgen, wo wir Architekturdesign, Python-Implementation und Validierungstechniken vertiefen.
Industrieroboter
- Cisco 1G Bidirektionale Transceiver: Service Provider und IoT Netzwerk-Effizienz steigern
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Smart Core Network Slicing für IoT und MVNOs: 5G-Potenzial in 3G/4G-Netzen freisetzen
- 5Gs Top 5 Herausforderungen: Spektrum, Kosten, Abdeckung, Geräte, Sicherheit navigieren
- Deploying und Managing Wireless Sensor Networks im Enterprise
- Lean & Six Sigma: Ein praxisnaher Leitfaden für Fertigungsexzellenz
- BECKER Vakuumpumpen-Schulung: Expertenwissen für CNC-Profis
- Senet & SimplyCity erweitern LoRaWAN IoT für Smart Farms, Industrie und urbane Nachhaltigkeit
- Hybrid-Fertigung: Wesentliche Vorteile, Herausforderungen und Branchenauswirkungen
- Schlagzähe Werkzeugstähle: Stempel- und Matrizenleistung meistern