



Multilayer Perzeptron trainieren: Bewährte Strategien für optimale Performance
Wir können die Performance eines Perzeptrons durch Hinzufügen eines Hidden-Layers erheblich steigern, aber diese Hidden Nodes machen das Training etwas komplizierter.
Bisher in der AAC Serie zu Neuronalen Netzen haben Sie über Datenklassifikation mit Neuronalen Netzen gelernt, besonders der Perzeptron-Variante.
Holzen Sie die Serie unten nach oder tauchen Sie in diesen neuen Eintrag ein, der die Grundlagen des Multilayer Perzeptrons (MLP) erklärt.
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
Was ist ein Multilayer Perzeptron Neuronales Netz?
Der vorherige Artikel zeigte, dass ein Single-Layer Perzeptron schlicht nicht die Performance liefern kann, die wir von moderner Neuronalnetz-Architektur erwarten. Ein System, das auf linear trennbare Funktionen beschränkt ist, kann die komplexen Input-Output-Beziehungen realer Signalverarbeitungsszenarien nicht approximieren. Die Lösung ist ein Multilayer Perzeptron (MLP), wie dieses:
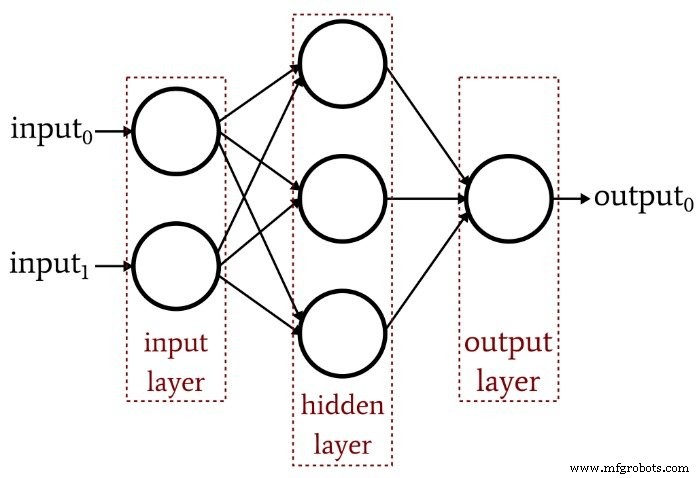
Durch Hinzufügen jenes Hidden Layers wandeln wir das Netz in einen „Universal Approximator“ um, der extrem anspruchsvolle Klassifikation erreichen kann. Aber wir müssen immer im Hinterkopf behalten, dass der Wert eines Neuronalen Netzes vollständig von der Qualität seines Trainings abhängt. Ohne reichhaltige, diverse Trainingsdaten und ein effektives Trainingsverfahren wird das Netz nie „lernen“, Input-Samples zu klassifizieren.
Warum kompliziert der Hidden Layer das Training?
Schauen wir uns die Lernregel an, die wir zum Trainieren eines Single-Layer Perzeptrons in einem früheren Artikel nutzten:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Beachten Sie die implizite Annahme: Wir aktualisieren Gewichte basierend auf beobachtetem Output, damit dies funktioniert, müssen die Gewichte im Single-Layer Perzeptron den Output-Wert direkt beeinflussen. Es ist wie die Wassertemperatur eines Hahns durch Drehen der Heiß- und Kaltwasserhähne einzustellen. Die Beziehung zwischen Gesamttemperatur und Hahnaktion ist geradlinig, und sogar Leute, die Mathe nicht mögen, finden die gewünschte Temperatur durch etwas Herumprobieren.
Stellen Sie sich nun vor, der Wasserfluss durch Heiß- und Kaltwasserrohre hängt auf komplexe, hochgradig nichtlineare Weise von Hahnposition ab. Sie drehen den Heißwasserhahn stetig und langsam, aber die resultierende Flussrate variiert erratisch. Sie probieren den Kaltwasserhahn und er macht dasselbe. Die ideale Wassertemperatur unter diesen Bedingungen einzustellen – besonders da der „Output“ durch Kombination zweier verwirrender Steuerbeziehungen erreicht werden muss – wäre viel schwieriger.
So verstehe ich das Dilemma des Hidden Layers. Die Gewichte, die Input-Nodes mit Hidden-Nodes verbinden, sind konzeptionell analog zu jenen mechanisch erratischen Hähnen – weil Input-to-Hidden Gewichte keinen direkten Pfad zum Output-Layer haben, ist die Beziehung zwischen diesen Gewichten und dem Netzwerk-Output so komplex, dass die oben gezeigte einfache Lernregel nicht effektiv sein wird.
Ein neues Trainingsparadigma
Da die ursprüngliche Perzeptron-Lernregel nicht auf Multilayer-Netze anwendbar ist, müssen wir unsere Trainingsstrategie neu denken. Wir werden Gradient Descent und Minimierung einer Fehlerfunktion einbeziehen.
Eine Sache im Hinterkopf: Dieses Trainingsverfahren ist nicht spezifisch für Multilayer Neuronale Netze. Gradient Descent stammt aus allgemeiner Optimierungstheorie, und das Trainingsverfahren, das wir für MLPs einsetzen, ist auch auf Single-Layer Netze anwendbar. Allerdings ist MLP-Style Gradient Descent (zumindest theoretisch) für einen Single-Layer Perzeptron unnötig, da die einfachere Regel oben den Job irgendwann erledigt.
Die Ableitung der tatsächlichen Gewichts-Update-Gleichungen für ein MLP involviert einschüchternde Mathematik, die ich an dieser Stelle nicht intelligent erklären werde. Mein Ziel für den Rest dieses Artikels ist eine konzeptuelle Einführung in zwei Schlüsselaspekte des MLP-Trainings – Gradient Descent und Fehlerfunktion – und dann fahren wir im nächsten Artikel fort, indem wir eine neue Aktivierungsfunktion einbeziehen.
Gradient Descent
Wie der Name impliziert, ist Gradient Descent ein Mittel, zum Minimum einer Fehlerfunktion basierend auf Steigung abzusteigen. Das Diagramm unten vermittelt, wie ein Gradient uns Information gibt, wie wir Gewichte modifizieren müssen – die Steigung eines Punkts auf der Fehlerfunktion sagt uns, in welche Richtung wir gehen müssen und wie weit wir vom Minimum entfernt sind.
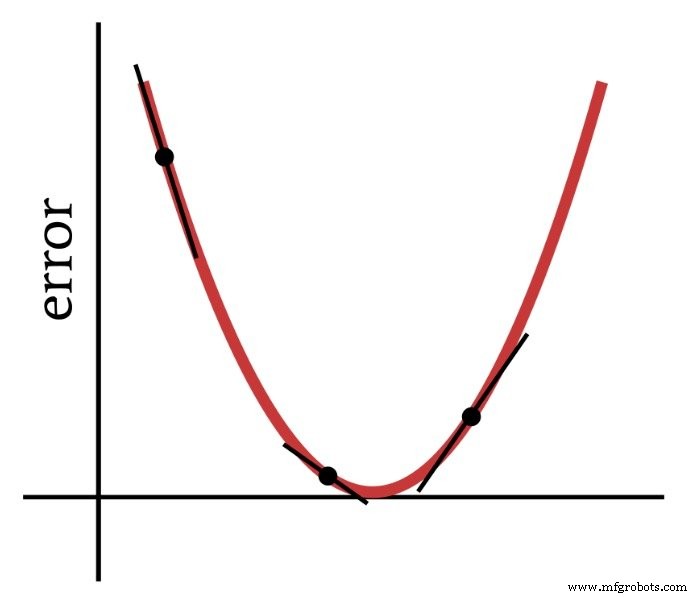
Daher ist die Ableitung der Fehlerfunktion ein wichtiges Element der Berechnungen, die wir zum Trainieren eines Multilayer Perzeptrons nutzen. Tatsächlich brauchen wir hier partielle Ableitungen. Wenn wir Gradient Descent implementieren, machen wir jede Gewichtsmodifikation proportional zur Steigung der Fehlerfunktion bezüglich des zu modifizierenden Gewichts.
Die Fehlerfunktion (AKA Loss Function)
Eine gängige Methode, Neuronalnetz-Fehler zu quantifizieren, ist das Quadrieren der Differenz zwischen erwartetem (oder „Target“) Wert und berechnetem Wert für jeden Output-Node, und anschließendes Summieren all dieser quadrierten Differenzen. Man kann dies „Sum of Squared Differences“ oder „Summed Squared Error“ nennen oder diverse andere Dinge, und man sieht auch die Abkürzung LMS für Least-Mean-Square, weil das Trainingsziel die Minimierung des mittleren quadratischen Fehlers ist. Diese Fehlerfunktion (bezeichnet mit E) kann mathematisch wie folgt ausgedrückt werden:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
wobei k den Bereich der Output-Nodes angibt, t der Target-Output-Wert ist und o der berechnete Output-Wert.
Fazit
Wir haben das Fundament für erfolgreiches Training eines Multilayer Perzeptrons gelegt und werden dieses interessante Thema im nächsten Artikel weiter erforschen.
Industrieroboter
- Netzwerktopologien verstehen: Von Punkt-zu-Punkt bis Ring und Stern
- Automobil-Elektriker werden: Ausbildung, Aufgaben und Karriereaussichten
- Industrielle IoT-Geräte härten gegen Cyber-Angriffe
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Wie vernetzte Netzwerke die moderne Landwirtschaft revolutionieren
- Wie intelligente Netzwerke Geschäftseffizienz und Wachstum antreiben
- Netzwerksicherheitsschlüssel finden & schützen: Einfache Schritte für Ihr WLAN
- Künstliche Neuronale Netze steigern Wireless-Kommunikationsleistung
- Sicherheit Ihres Shopfloor-Netzwerks: Sind Sie vorbereitet?
- Belegschaft von morgen auf Industrie 4.0 vorbereiten: Trainingsstrategien für die digitale Fabrik