



MLCommons veröffentlicht MLPerf Inference Benchmark 2024: Edge, Data Center, Mobile, Notebook Ergebnisse
MLCommons, die unabhängige Organisation die die MLPerf Benchmark Suite kuratiert, hat die neueste Runde MLPerf Inference Scores angekündigt. Die neuen Ergebnisse sind sauber in vier Device-Klassen aufgeteilt – Data Center, Edge, Mobile und Notebook – was es Käufern, Vendors und Forschern erleichtert, Performance über real-world Workloads zu vergleichen.
Device-Class Segmentation
Die Trennung der Scores nach Device Class reflektiert die distincten Formfaktoren und Performance-Profile die jeden Markt charakterisieren. Wie David Kanter, Executive Director von MLCommons EE Times sagte: „Wenn Sie über Notebook sprechen, läuft es wahrscheinlich Windows; wenn Sie über Smartphone sprechen, laufen Sie wahrscheinlich iOS oder Android.“ Durch Isolierung von Mobile und Notebook Ergebnissen liefert der Benchmark klarere Insights in Capabilities der relevantesten Acceleratoren für jeden Use Case.
State-of-the-Art Models
Im Gegensatz zur vorherigen Runde, die primär auf Vision Tasks fokussierte, incorporiert der aktuelle Benchmark fünf moderne, production-grade Models:
- DLRM – Large-Scale Recommendation Engine
- 3D-UNet – Medical Imaging Model für Tumor-Detection in MRT-Scans
- RNN-T – Speech-to-Text Engine
- BERT – Natural-Language-Processing Transformer
- MobileNetEdge, SSD-MobileNetv2, Deeplabv3, Mobile BERT – mobile-optimierte Varianten der oben genannten
Diese Wahl wurde von einem Advisory Board getrieben, das Industry-Experten aus Recommendation, Medical Imaging und Speech Domains umfasst, sicherstellend dass Benchmarks die anspruchsvollsten Workloads in Production heute reflektieren.
Data Center Performance
Wie erwartet dominieren Nvidias GPUs die Data-Center-Klasse. Tatsächlich waren 85 % der totalen Submissions von Nvidia Hardware powered, und das Unternehmen sweepte jede Kategorie die es entered. Der Benchmark zeigt sich vergrößernden Performance-Gap: Auf basic Computer-Vision Model liefert Nvidia A100 roughly 30× Throughput eines Intel Cooper Lake CPU, und 237× schneller als vergleichbare CPU auf Recommendation-System Workloads. Paresh Kharya, Nvidias Senior Director Product Management, hebt hervor dass einzelnes DGX-A100 Performance eines 1.000-Node CPU Clusters für Recommendation Tasks matchen kann, bietet tremendous Value für Scale.
Der einzige Non-CPU, Non-GPU Entrant in dieser Klasse war Mipsologys Zebra Accelerator, laufend auf Xilinx Alveo U250 FPGA. Zebra erreichte 4.096 ResNet Queries per Second in Server Mode versus 5.563 für Nvidia T4, und 5.011 Samples per Second Offline verglichen mit 6.112 für T4.
In Research-Development Kategorie performte Taiwanese Company Neuchips' RecAccel – FPGA-basierter Accelerator für DLRM – auf Par mit oder unter Intels Cooper Lake CPUs und fiel kurz von Nvidias Ergebnissen. Diese Early-Stage Prototypen demonstrieren Breadth emerging AI Hardware, auch wenn noch nicht kommerziell verfügbar.
Edge-Tier Outcomes
Edge-Systeme waren largely powered by Nvidias A100, T4, AGX Xavier und Xavier NX Chips. Centaur Technologys Reference Design, featuring proprietary x86 Processor und separaten AI Coprocessor, beat Nvidias Tesla T4 in Single-Stream ResNet Latency aber lag bei Throughput hinterher. Britische Consultancy dividiti präsentierte breite Range an Scores – von Raspberry Pi bis Nvidia AGX Xavier – highlightend wie OS-Wahl und On-Chip-Accelerator-Nutzung Ergebnisse beeinflussen können.
New Entrants aus Research-Development Pool inkludierten Russian Company IVA Technologies und Korean Startup Mobilint. Während keines breakthrough Performance erreichte, zeigt ihre Inklusion dass Prototype Accelerators Software-Reifelevel erreichen, das Benchmarking gegen kommerzielle Lösungen rechtfertigt.
Mobile und Notebook Benchmarks
Mobile Klasse sah drei vergleichbare Submissions: MediaTeks Dimensity 820 (in Xiaomi Redmi 10X 5G), Qualcomms Snapdragon 865+ (getestet auf Asus ROG Phone 3), und Samsungs Exynos 990 (verwendet in Galaxy Note 20 Ultra). Samsung led in Image Classification und NLP, MediaTek excelled in Object Detection, und Samsung outperformed wieder in Image Segmentation. Ergebnisse illustrieren dass kein einzelnes SoC across all Tasks dominiert, underscoring Wichtigkeit von Workload-spezifischer Optimierung.
Notebook Kategorie enthielt einzelnes Intel Reference Design featuring forthcoming Xe-LP GPU. Obwohl limitierter Datensatz detaillierten Vergleich erschwert, erreichte Xe-LP 2,5× höheren Throughput als bestes Mobile SoC auf Image-Segmentation (DeeplabV3) und 1,15× besser auf Object Detection (SSD-MobileNetv2).
Ausblick
Kanri betont MLCommons' Commitment zu Diversity im Benchmark-Ökosystem. Organisation ermutigt Non-Nvidia, Non-Intel und Small-Company Participation, mit Open Division die any Network oder Model zum Testen erlaubt. „Wir arbeiten auch an Hinzufügen einer Power-Measurement Dimension für nächste Runde“, sagt Kanter, einladend Community bei Development necessary Tooling zu helfen.
Für vollständige, detaillierte Liste der MLPerf Inference Ergebnisse, klicken Sie hier.
Quelle: EE Times
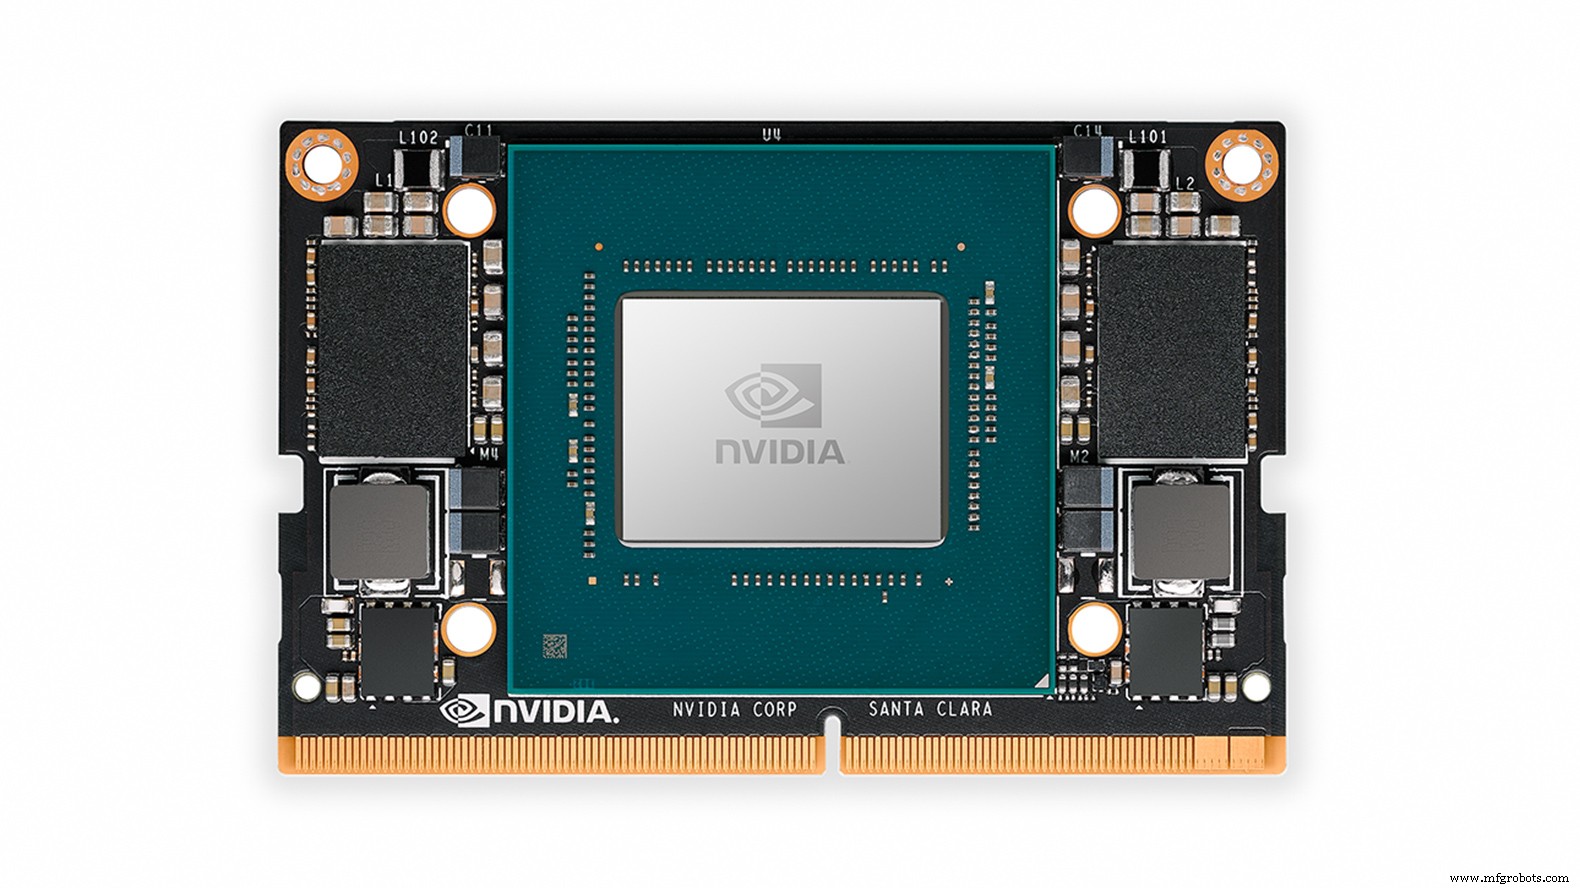
Edge Results dominiert von Nvidia GPUs, inklusive Jetson Xavier NX
Eingebettet
- STMicroelectronics LSM6DSOX: Machine-Learning-fähiger Inertial Sensor für präzises, energieeffizientes Activity Tracking
- ADLINK & Charles Industries enthüllen erste komplette Micro-Edge AI/ML Lösung für 5G Polmontierte Deployments
- NXP beschleunigt Edge AI mit eIQ Toolkit
- Edge AI: Warum die Verarbeitung auf die Geräteebene verlagert wird
- Produktivität steigern: 7 Schlüsselfunktionen von Vertikalen Bearbeitungszentren (VMC)
- Edge-Computing-Effizienz mit robustem Wi-Fi-Netzwerk steigern
- Machine Learning beschleunigt Pipeline-Sicherheit: Echtzeit-Fehlererkennung spart 10 Mio. $
- Edge Computing: Der neue Herzschlag des Cloud-Zeitalters
- Johnford ST-80 CH: Präzisions-CNC-Drehzentrum für Schwerindustrie
- Präzisions-Vier-Achsen-VTC 100-4: Hochleistungs-Wellendrehmaschine