



Quadrics hybrider Data-Flow- & Von-Neumann-Chip beschleunigt KI- und Vision-Workloads
Eine neuartige hybride Data-Flow- und Von-Neumann-Architektur kann Workloads einschließlich neuronaler Netze, maschinellem Lernen, Computer Vision, DSP und grundlegenden linearen Algebra-Unterprogrammen beschleunigen.
Quadric, ein Silicon-Valley-Startup, hat einen Beschleuniger entwickelt, der sowohl KI-Inferenz als auch traditionelle Computer-Vision-Algorithmen auf Edge-Geräten wie Robotern, Fabrikautomation und medizinischer Bildgebung ankurbelt. Das Hardwares einzigartiges hybrides Design vereint Data-Flow- und Von-Neumann-Prinzipien und ermöglicht effiziente Ausführung von neuronalen Netzen, maschinellem Lernen, DSP und Linear-Algebra-Routinen.
„Von Anfang an erkannten wir, dass Edge-Geräte mehr als nur KI benötigen“, sagte CEO Veerbhan Kheterpal gegenüber EE Times. „Entwickler brauchen ein einzelnes System, das klassische High-Performance-Computing-Algorithmen neben KI ausführen kann.“
Kheterpal betonte, dass die Architektur keine Sammlung diskreter Beschleuniger ist, sondern ein einzelner, datenparalleler Befehlssatz, der diverse Workloads einschließlich KI-Inferenz beschleunigen kann.
„Jüngste Arbeiten zeigen, dass das Ersetzen ganzer Layer durch schnelle Fourier-Transformationen (FFT) Transformer dramatisch beschleunigen kann“, sagte Chief Product Officer Daniel Firu. Quadric ist bereit, solche Workloads zu beschleunigen, und zitiert ein Google-Paper, bei dem ein Transformer-Encoder-Self-Attention-Sub-Layer durch eine FFT ersetzt wurde, was 92 % Genauigkeit auf dem BERT-Benchmark erreichte und auf GPUs bis zu siebenmal schneller oder auf TPUs doppelt so schnell trainierte.
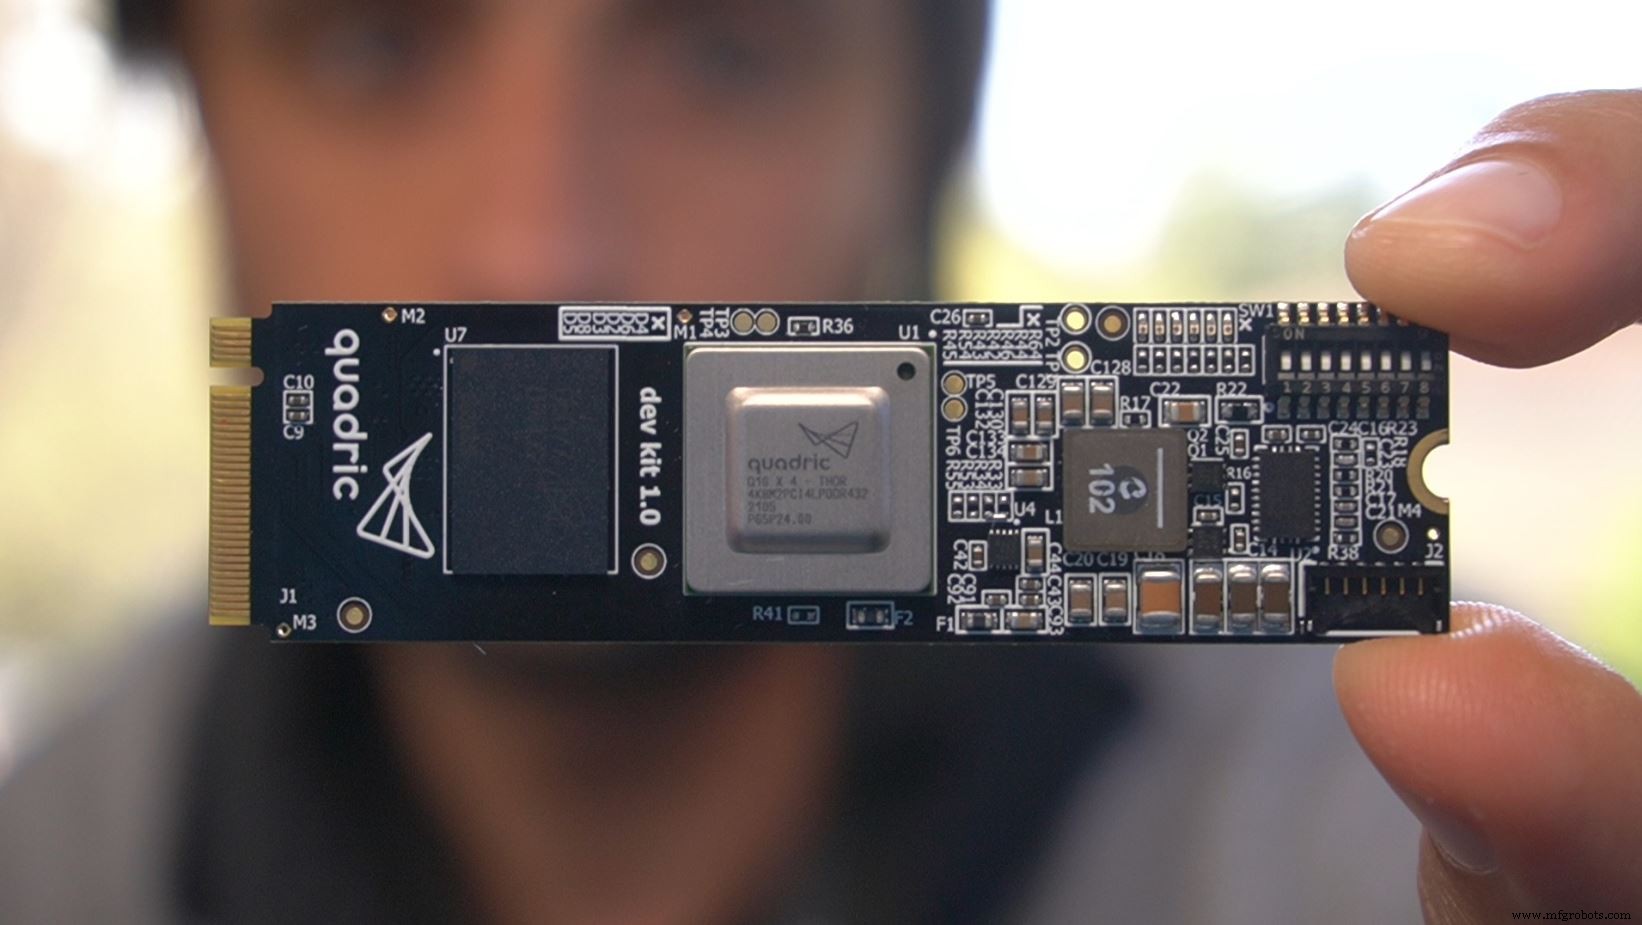
Quadrics Entwicklerkit, eine M.2-Karte mit dem Q16-Prozessor und 4 GB externem Speicher (Quelle: Quadric)
Weinberg-Roboter
Die Gründer – Veerbhan Kheterpal, Daniel Firu und Nigel Drego – gründeten zuvor 21, ein Bitcoin-Mining-Unternehmen, das von Coinbase übernommen wurde. Quadrics früher Fokus lag auf landwirtschaftlichen Robotern, die Napa-Valley-Weinberge durchquerten, Bewässerungslecks und Schädlinge detektierten. Die hohen Kosten drohnenbasierter Lösungen drängten das Team jedoch zur Entwicklung eines eigenen Beschleunigers.
Veerbhan Kheterpal (Quelle: Quadric)
„Wir erkannten, dass ein drohnenbasiertes System 5–10 k$ kosten würde, aber eine traktorbasierte Plattform mit großen GPUs und zahlreichen Kameras über 50 k$ kosten würde. Dieser Einblick führte uns zum Design des Beschleunigerchips, den wir brauchten“, erklärte Kheterpal.
Nach einer Seed-Runde 2017 und einer 13-Millionen-Dollar-Series-A unter Führung des automobilen Tier-One Denso hat Quadric bisher 18 Millionen Dollar eingesammelt.
Turing-vollständiges Design
Quadrics instruktionsgesteuerte Architektur verbindet Data-Flow- und Von-Neumann-Konzepte, um heterogene Edge-Systeme durch eine einzelne, flexible Lösung zu ersetzen. Die Turing-vollständigen Vortex-Kerne liefern Beschleunigung bei Beibehaltung der Programmierbarkeit. Skalierbare Arrays und Kompatibilität mit 7- oder 5-nm-Prozessen machen das Design für Edge-Geräte mit Leistungsbudgets von Hunderten Milliwatts bis 20 W geeignet.
Der Q16-Chip beherbergt ein 16 × 16 Array von Vortex-Kernen. Jeder Kern kann Matrixmultiplikation und KI-Operationen durchführen und umfasst eine multifunktionale ALU für Logik, Reduktion, Shift und mehr. Die Software macht ein breites algorithmisches Spektrum zugänglich – von LSTM-Aktivierungsfunktionen bis zu benutzerdefiniertem Kontrollfluss – mittels if-then-else-Anweisungen über das Array, um feinkörnige Sparsity auszunutzen.
Jeder Kern genießt Single-Cycle-Zugriff auf seine Nachbarn und einen 4 Kb In-Core-Speicher, während der On-Chip-Speicher latenzarme, deterministische Datenzugriffe bietet.
Die Kerne führen im „Single Instruction, Multiple Decode“-Modus aus: Derselbe Befehl wird jeden Zyklus gebroadcastet, aber dynamische Laufzeitdaten lassen einzelne Kerne ihn unterschiedlich interpretieren, was heterogene Funktionen innerhalb eines homogenen Arrays ermöglicht.
Ein dedizierter Broadcast-Bus streamt Konstanten – wie neuronale Netzwerkgewichte – effizient simultan in alle Kerne. Statische, softwarekontrollierte Load-Store-Einheiten ermöglichen deterministische Kernel-Laufzeiten, mit simultanen Dual-Edge-Loads und Triple-Edge-Stores, die die Ausführungszeit reduzieren.
Daniel Firu (Quelle: Quadric)
„Laden von einer Seite und Speichern auf der anderen ermöglicht es uns, Daten-Remappings und Bildrotation auf Hardwareebene durchzuführen“, sagte Firu.
On-Chip statische Speicher, keine Caches, bieten ausreichend Platz für große Datenstrukturen. Der Q16’s 8 GB Speicher können mehrere HD-Frame-Buffer oder einen gesamten neuronalen Netzwerk-Gewichtsatz halten.
Software-Stack
Quadric baute seinen Software-Stack vor dem Silizium auf, sodass Entwickler auf einem Simulator oder FPGA prototypen können. Der Stack abstrahiert die Architektur über einen LLVM-basierten Compiler und eine C++ API. Source Mode unterstützt datenparallele Algorithmen mit C++-Kontrolle über architektonische Features und kann benutzerdefinierte Operationen als KI-Modelle ausdrücken, während diese komplexer werden.
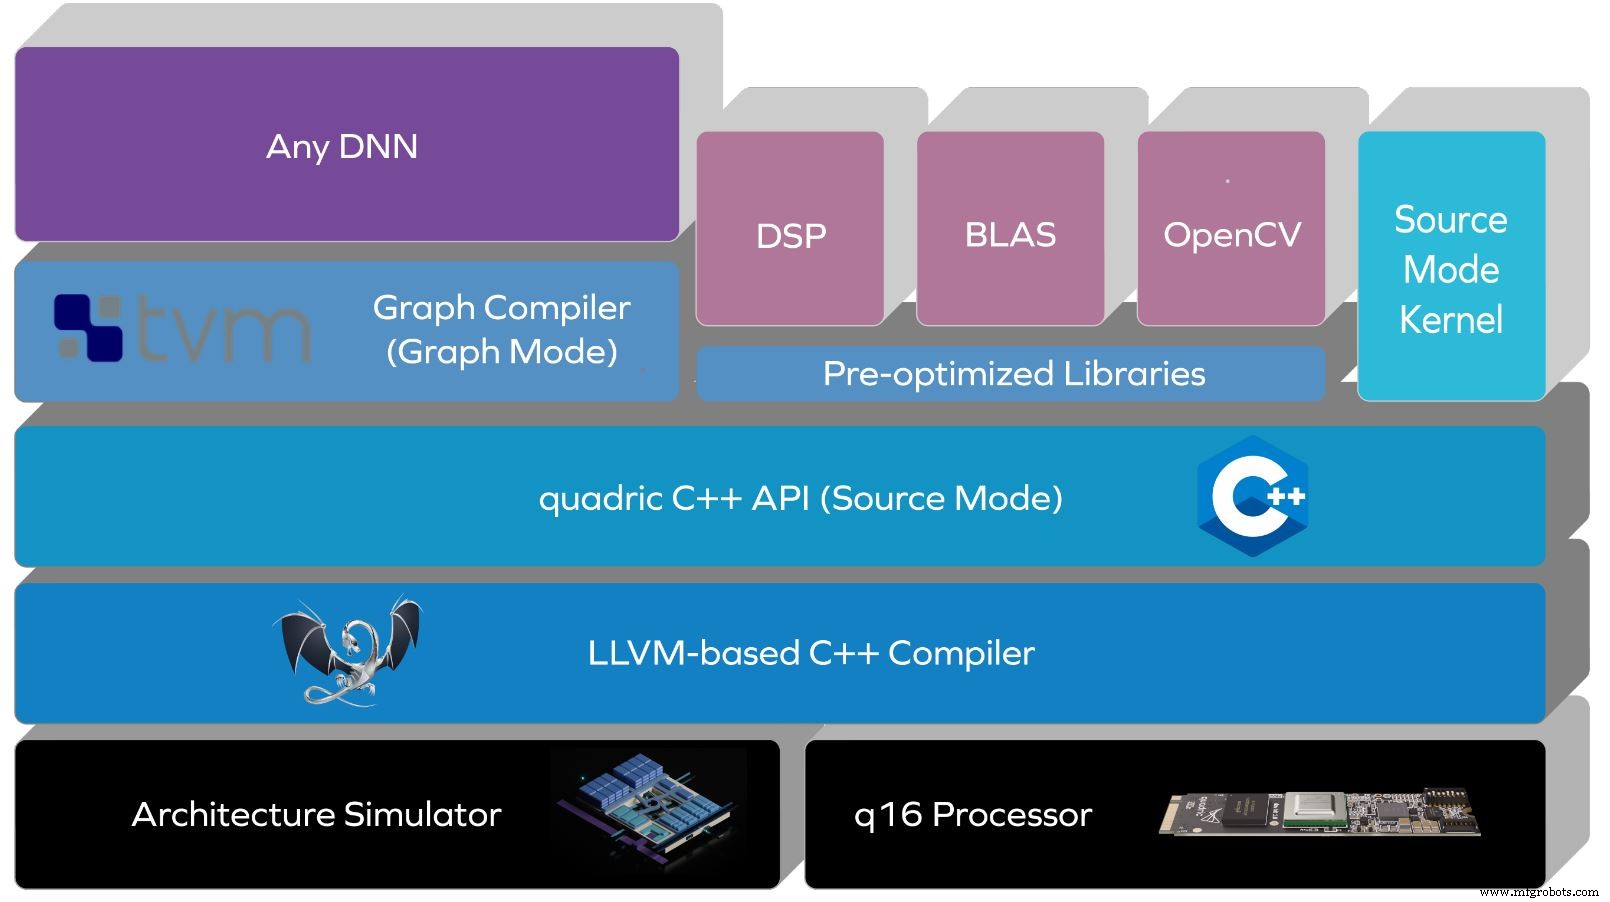
Quadrics Software-Stack (Quelle: Quadric)
Ein kommender Graph Mode wird eine No-Code-Schnittstelle für TensorFlow- oder ONNX-Modelle bieten, unterstützt durch einen TVM-basierten DNN-Compiler, der Code auto-generiert.
„Die meisten Plattformen beschränken Sie auf ihren eigenen KI-Compiler, aber wir bieten vollständige Turing-vollständige Kerne, die jede Operation ausführen können“, erklärte Kheterpal. „Diese Flexibilität lässt Entwickler benutzerdefinierte Algorithmen oder nicht unterstützte Operatoren ohne Restriktion einsetzen.“
Chip-Roadmap
Der Q16 liefert 256 Vortex-Kerne in einem 16 × 16 Array, gefertigt in 16-nm-Silizium, und erreicht 4 INT8 DNN TOPS. Er läuft ResNet-50 bei 200 Inferenzen pro Sekunde auf 224 × 224 Bildern, wobei er durchschnittlich 2 W verbraucht.
Quadrics Roadmap umfasst eine zweite Generation der Architektur und einen Q32-Chip – ein Array von 1.000 Kernen – gezielt für 7-nm-Fertigung. Der Q32 könnte auch ARM- oder RISC-V-Kerne integrieren, um als Host-Prozessor zu dienen.
Ein M.2-Entwicklerkit mit dem Q16-Prozessor und 4 GB externem Speicher ist heute verfügbar.
>> Dieser Artikel wurde ursprünglich auf unserer Schwesterseite EE Times veröffentlicht.
Verwandte Inhalte:
- Hardware-Beschleuniger bedienen KI-Anwendungen
- Wenn ein DSP einen Hardware-Beschleuniger schlägt
- Leitfaden zur Beschleunigung von Anwendungen mit just-right RISC-V Custom Instructions
- Inferenz-Chip-Performance baut auf optimiertem Memory-Subsystem-Design auf
- Neue KI-Beschleunigungsmodule verbessern Edge-Performance
- Edge KI fordert Speichertechnologie heraus
Für weitere Embedded-Inhalte abonnieren Sie den wöchentlichen E-Mail-Newsletter von Embedded.
Eingebettet
- Hybrid Cloud Environments: Applikationen, Workloads und Strategien für optimale Performance auswählen
- Blaize stellt Graph Streaming Processor (GSP) für KI-Workloads vor
- STM32WB50: Dual-Core Wireless MCU für sichere IoT-Anwendungen
- Edge AI Beschleunigung: Führende spezialisierte Prozessoren für 2024
- Lattice & Etron präsentieren kompakten, Low-Power Memory Controller für Edge AI Workloads
- ECM3532: Eta Computes erstes integriertes Ultra-Low-Power KI Sensor Board beschleunigt Edge Development
- ADLINK launcht NEON‑1000‑MDX: Turnkey Edge AI Smart Camera für schnelles Industrial Vision Deployment
- IBM stellt hybride Blockchain-Architektur für sichere IoT-Netzwerkverwaltung vor
- Omron TM Series Cobot: Integrierte Vision, Plug-and-Play Programmierung für nahtlose Mensch-Roboter-Kollaboration
- Hyperspektrale Vision verstehen: Leistungsstarkes Werkzeug für Lebensmittelsicherheit