



Kontinuierliche Gesundheit Ihrer IIoT-Systeme sicherstellen
Warum kontinuierliches Monitoring wichtig ist
Wenn Ihr IIoT-Netzwerk läuft, kann es immer noch unter verborgenen Problemen leiden: Netzwerk-Latenz, Node-Failures oder unerwartete Änderungen durch Software-Upgrades und neue Deployments. Diese Probleme degradieren Applikationsperformance, aber ohne fortlaufende Beobachtung wird die Ursachenfindung schwierig.
Die drei Säulen des operativen Monitorings
Effektives Monitoring beruht auf drei Kernkomponenten:
- Eine zuverlässige Datenerfassungs-Engine
- Ein skalierbares Speichersystem für Time-Series-Daten
- Eine Visualisierungsplattform, die rohe Metriken in actionable Insights verwandelt
InfluxData's TICK Stack: Das Time-Series Rückgrat
Wir wählten den TICK Stack von InfluxData, um unsere Monitoring-Pipeline zu powern:
- Telegraf – ein plugin-getriebener Agent, der Metriken sammelt. Er shipped mit über 100 built-in Plugins und kann mit Custom Plugins erweitert werden.
- InfluxDB – die Kern Time-Series Datenbank. Key Features: SQL-ähnliche Queries, eingebaute Time-Series Funktionen, automatisierte Retention Policies, schema-less Modell, Continuous Queries für Downsampling, High-Availability Clustering (nur Commercial Edition).
- Chronograf – ein Web-Interface, das Daten visualisiert.
- Kapacitor – eine Rule-Engine, die Alerts basierend auf user-definierten Bedingungen triggert.

InfluxData's TICK Stack liefert eine End-to-End-Lösung für Sammeln, Speichern und Visualisieren von Monitoring-Daten.
Robuste Monitoring-Architektur designen
Unsere Architektur ist in zwei Layer gesplittet:
- Management Services Layer – Software, die auf jedem Node läuft, um Health Metriken zu sammeln. In unserem Proof-of-Concept waren die User Applikationen OpenFMB Simulationen, aber der Layer ist agnostisch zu jeder DDS Applikation.
- Administration Layer – Software, die die gesammelten Time-Series Daten ingestet, speichert und Visualisierung und Alerting bereitstellt.

Erfasste Schlüsselmetriken
- Node Metriken – CPU, Memory und Network Utilization auf Host-Level.
- Container Metriken – derselbe Statistik-Satz für einzelne Container.
- DDS Metriken – Discovery Statistics, Protocol Usage und Events wie Liveliness Loss, Sample Lost, Sample Rejected.
Telegrafs existierende Plugins extrahierten Node- und Container-Daten vom OS und Container Engine. DDS Metriken wurden mittels RTIs Monitoring Library geharvestet.
Von lokaler Sammlung zu Remote-Analyse
Eine intelligente Bridge transformiert lokal gesammelte Daten in ein für den Monitoring Bus geeignetes Format. Sie kann Noise filtern, Bandbreite reduzieren und Payloads anreichern (z. B. Hostname als Tag hinzufügen). Auf der Administration Seite nutzten wir eine Telegraf Instanz, ausgestattet mit einem DDS Plugin, um den Bus zu abonnieren. Um dies zu ermöglichen, entwickelten wir ein Go Binding für RTI Connector, verfügbar auf GitHub.
Visualisierung & Alerting mit Grafana
Grafana bietet flexible Dashboards und Alert Rules, tailored zu Ihrem System. Mit den gesammelten Daten können Sie Echtzeit-Visualisierungen erstellen und Schwellenwerte setzen, die Notifications triggern.
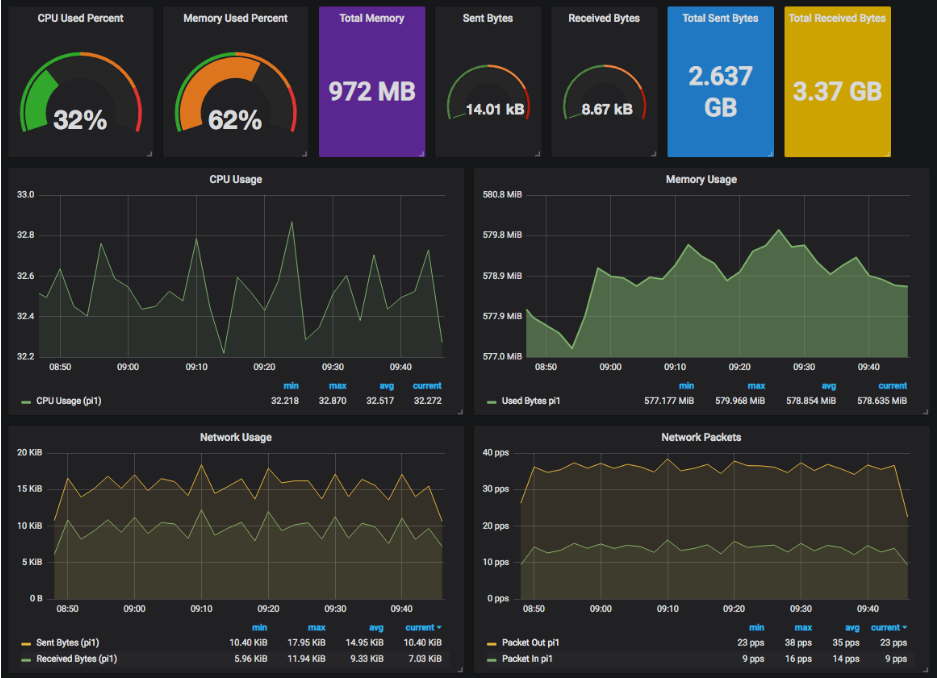
Grafana empowert Sie, system-spezifische Dashboards zu designen, die die Metriken surface, die am kritischsten für Ihre Operationen sind.
Selbst ausprobieren
Wir demonstrierten diese End-to-End Monitoring Lösung mittels unserer Energy-System Simulationen. Der vollständige Case Study und Source Code sind auf unserer Case + Code Seite verfügbar. Melden Sie sich, wenn Sie mit der Architektur experimentieren oder Feedback teilen möchten.
Nächste Schritte
In unserem kommenden Post tauchen wir tiefer in InfluxDB Integration ein, teilen Sample Code und führen Sie durch das Setup Ihres eigenen Monitoring Stacks.
Internet der Dinge-Technologie
- Warum IIoT in Ihrer Fabrik adoptieren: 4 Kernvorteile
- IoT-Daten freisetzen: Wie Business Rules Management Enterprise Value treibt
- Zukunftsausblick: Industrial IoT für Production Excellence vorantreiben
- Remote Telemetry: Das Fundament erfolgreicher IIoT-Deployments
- AWS stellt Snowmobile vor: Petabytes per sicherem Sattelzug in die Cloud
- Daten: Das neue Öl – Wie Raffinerien rohe Information in Business Value verwandeln
- IoT-ROI maximieren mit Advanced Performance Monitoring
- Proaktive Zustandsüberwachung für Maschinen: Ausfallzeiten verhindern & Zuverlässigkeit steigern
- Wie IIoT Asset-Monitoring-Systeme verbessert: Zuverlässigkeit & Effizienz steigern
- Industrielle Fernsteuerung: Der entscheidende Treiber für Smart Manufacturing Erfolg