



Warum Daten das Fundament der Zuverlässigkeitsengineering sind
 In der heutigen technologiegetriebenen Welt sind Daten der Dreh- und Angelpunkt strategischer Entscheidungen. Die Disziplin, die dieses Potenzial nutzt – Data Science – ermöglicht Unternehmen, Informationen zu sammeln, zu prüfen und für intelligentere, evidenzbasierte Entscheidungen anzuwenden.
Aktuelle Prognosen sagen ein globales Datenvolumen von 163 Zettabyte bis 2025 voraus – eine Menge, die einer Billion Gigabyte pro Zettabyte entspricht. Dieses gewaltige Wachstum zwingt Organisationen, kritische Herausforderungen in Speicherung, Qualität und Governance anzugehen.
Dieser Artikel untersucht, warum verlässliche Daten rigorose Zuverlässigkeitsstudien untermauern. Zuverlässigkeit ist im Kern die Wahrscheinlichkeit, dass Ausrüstung, Systeme oder Anlagen über ein spezifiziertes Intervall unter definierten Betriebsbedingungen ohne Ausfall funktionieren. Folglich sind präzise historische Ausfalldaten und ihre korrekte Analyse unverzichtbar für jede glaubwürdige Zuverlässigkeitsbewertung.
Datenanalyse erschließt das Potenzial riesiger Datensätze und extrahiert umsetzbare Erkenntnisse, die bessere Entscheidungen lenken. Dies ist nur erreichbar, wenn die Datenintegrität unangefochten ist; fehlerhafte Daten führen unweigerlich zu fehlerhaften Schlussfolgerungen.
Vorteile der Datenanalyse
Zuverlässigkeitsanalyse befähigt Manager und Ingenieure zu informierten technischen und finanziellen Entscheidungen. Durch Datenanalyse können sie Projektdesigns verfeinern, Kosten senken, Komponentenlebensdauern vorhersagen, Ausfälle untersuchen, angemessene Garantiezeiträume festlegen, effektive Inspektionen planen und Key Performance Indicators (KPIs) identifizieren. Genaue Daten sind das Fundament einer umfassenden Zuverlässigkeitsstudie.
Datenerhebung und -filterung sind Kernaufgaben jedes Zuverlässigkeitsingenieurs. Es geht um systematisches Sammeln und Auswerten von Informationen zu Interessensvariablen, um spezifische Forschungsfragen zu beantworten, Hypothesen zu testen und umsetzbare Ergebnisse zu unterstützen.
Akkurate, ehrliche Datenerhebung ist der gemeinsame Nenner, der alle Forschungsbemühungen vereint und sicherstellt, dass jede Studie auf einem verlässlichen Fundament beginnt.
Eine Vielzahl von Tools und Techniken kann Daten verarbeiten, um ihre Genauigkeit und Zuverlässigkeit zu erhöhen – wie Outlier-Entfernung, die verzerrte Ergebnisse in Zuverlässigkeitsberechnungen verhindert.
Robuste Daten etablieren
In jedem Betriebsstandort bilden verlässliche Daten – Wartungslogs, Ausfallaufzeichnungen, Betriebsfenster und mehr – die Basis für Zuverlässigkeitsengineering-Studien. Leider fehlen vielen Unternehmen die Systeme, Prozesse oder die Kultur für effektive Datenerhebung und -management.
Eine robuste Datenbank muss alle bedeutungsvollen Datenpunkte erfassen und speichern. Eine Datenbank, die nur einen Teil essenzieller Daten sammelt, kann ein unvollständiges, potenziell irreführendes Bild von Betrieb und Anlagenzustand liefern.
Der Einsatz validierter Tools – Methoden, die zuverlässige Datenerhebung garantieren – kann Praktiken verbessern. Ein finnisches Unternehmen berichtete, dass etwa jeder sechste geschlossene Wartungsbericht (17,2 %) einen Ausfallmodus ausließ und keiner Ersatzteildetails aufzeichnete. Solche Lücken deuten auf eine schmale Datenbank hin, die kritische Ausfallorte und -auswirkungen nicht erfasst.
Zeitnahe Datenerfassung ist ebenfalls entscheidend. Wartungsabteilungen, die wöchentlich oder monatlich berichten, verlieren eher kritische Informationen als solche mit dynamischen Systemen, die Daten in Echtzeit konsolidieren.
Eine Best Practice ist, hochwertige Datenkriterien im Erhebungs- und Speichersystem zu definieren und so weit wie möglich zu automatisieren, um Konsistenz und Suchbarkeit zu gewährleisten. Offene Textfelder machen Analytik zur manuellen Aufgabe; sie sollten für ergänzende Details reserviert sein, nicht für Primärdatenpunkte.
Stattdessen sollte das System dedizierte Zellen für jede sinnvolle Variable vorsehen, wo immer möglich Dropdown-Menüs einsetzen, um Beschreibungen und Berichterstattung zu standardisieren. Konsistenz über die Datenbank hinweg ist essenziell für großangelegte Zuverlässigkeitsstudien.
Die Festlegung der benötigten Berichte und Analysen diktiert zuerst, welche Datenfelder einzuschließen sind. Für Zuverlässigkeitsstudien sollte die Datenbank Wartungsdetails zu Ersatzteilen, Ausfallmodi, Mannstunden, Hauptergebnissen, beschädigten Komponenten und Routineaktivitäten erfassen. Strukturierte Dropdowns in diesen Feldern ermöglichen Software, MTBF, Verfügbarkeit und andere Zuverlässigkeits-KPIs automatisch zu berechnen.
Datenqualitätsfaktoren
Tools und Technologie
Ein breites Spektrum an Tools unterstützt Datenqualitätsziele – von Deduplizierung und Datenintegration bis Migration und Analytik. Diese Tools helfen, Trends und Muster aufzudecken, indem sie Rohdaten kombinieren und kategorisieren.
Viele moderne Lösungen sind mobilfähig und reduzieren menschliche und Systemfehler bei der Datenerfassung. Die Einführung solcher Technologien kann die Datenqualität deutlich verbessern.
Menschen und Prozesse
Jeder Mitarbeiter – von Wartungsteams über Ingenieure bis zu Führungskräften – muss die Rolle von Daten in der Organisation verstehen. Dazu gehört Klarheit darüber, welche Daten gesammelt werden, wie oft und zu welchen Zwecken. Schulung und klare Prozesse sind essenziell, um zuverlässige und konsistente Datenerhebung und -speicherung zu gewährleisten.
Organisationskultur
Managementunterstützung und eine datengetriebene Kultur sind entscheidend für Qualität. KPIs, die Datenintegrität überwachen, sollten der Führung berichtet werden. Beim Start neuer Projekte oder Initiativen müssen Organisationen oft Prozesse, Rollen, Strukturen und Technologie anpassen, um relevante Daten zu erfassen.
Kontinuierliche Verbesserung treibt Erfolg an; Quantität und Qualität der Daten befeuern diesen Motor. Laufende Schulungen stärken die Wichtigkeit von Daten und kultivieren eine Kultur, die genaue Informationen wertschätzt.
Datenauswirkung auf Zuverlässigkeit
Betrachten Sie eine Fallstudie, in der eine Anlage die Ölproduktion durch Installation eines neuen Gas-Öl-Trennpakets (GOSP) mit Rohölstabilisierungseinheiten steigern wollte. Das GOSP umfasste Abscheidefallen, Nassrohöl-Handhabung, Wasser-Öl-Separator, Gasverdichtung, Fackelsystem, Transferpumpen und Stabilisierungseinheiten.
Eine RAM-Studie (Reliability, Availability, Maintainability) sagte die Produktionsverfügbarkeit der neuen Anlage voraus und benchmarkte sie gegen Ziele. Die Studie identifizierte Durchsatzengpässe, empfahl Verbesserungen, verifizierte Betriebsphilosophien und skizzierte Abhilfemaßnahmen oder Designänderungen.
Die rohen Wartungsdaten – erhoben durch Interviews mit bestehenden Crews – wiesen mehrere Probleme auf. So wurde beispielsweise suggeriert, dass alle 10 Monate ein Kompressor 30 Tage aufgrund mechanischer Dichtungsausfälle außer Betrieb wäre, was 10 % Ausfallzeit durch Dichtungen impliziert. Diese Annahme ist ungenau für eine Anlage, die neuere Technologie und Lessons Learned aus älteren Werken einsetzt.
Ebenso implizierten die Daten ein 30-tägiges Wartungsintervall alle vier Jahre wegen Wellengrübchen. Aufgewertete Materialien im neuen Design eliminieren dieses Problem.
Zusätzlich wurde die mittlere Reparaturzeit (MTTR) für Vibration mit 60 Tagen angegeben, während neue Kompressoren – dank verbesserter Ersatzteilverwaltung – eine MTTR von nur vier Tagen erreichen.
Diese fehlausgerichteten Annahmen demonstrieren, wie Daten von alternden Assets Entscheidungen für moderne Installationen fehlleiten können.
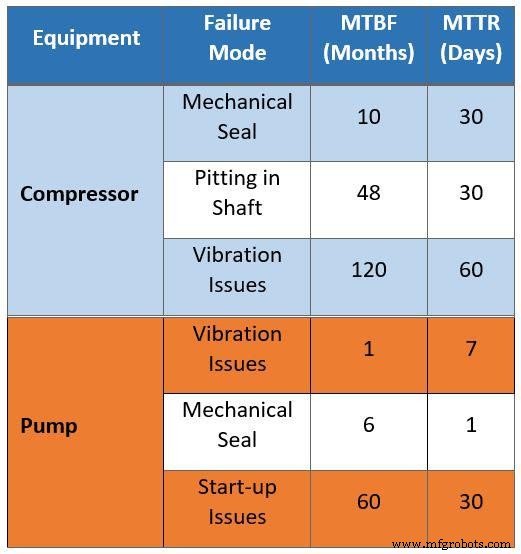 Tabelle 1. Rohe Felddaten für die RAM-Studie
Tabelle 2 präsentiert denselben Datensatz nach Filterung durch Zuverlässigkeitsingenieure. Sie entfernten Wartungsprobleme, die durch Instrumentierung automatisch korrigierbar wären, und kategorisierten die Daten nach Wartungs- und Betriebsstrategien, um designbedingte Probleme wie Engpässe und Kapazitätsbeschränkungen zu isolieren.
Die korrigierten Daten können auf die neue Anlage angewendet werden, um Designoptimierung zu leiten. Beispielsweise zeigen Gasverdichter-Ausfallmodi nun eine MTBF von acht Jahren (Trockenlaufdichtungen) und eine MTTR von drei Tagen. Korrosionsannahmen für Wellenverdichter wurden durch upgegradete Materialien eliminiert.
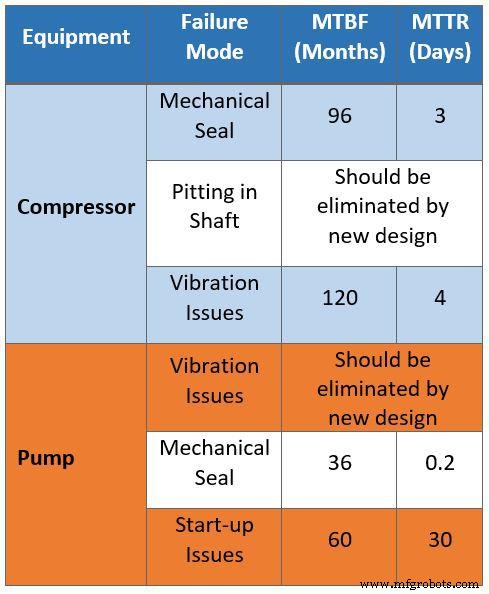 Tabelle 2. Gefilterte Daten für die RAM-Studie
Abbildung 1 vergleicht Verfügbarkeit und Kapazität beider Modelle basierend auf Original- und korrigierten Datensätzen. Die fehlerhaften Daten ergaben eine Verfügbarkeit von 77,34 % für die neue Anlage, während die korrigierten Daten 99 % projizieren – ein drastischer Unterschied, der die Realität widerspiegelt.
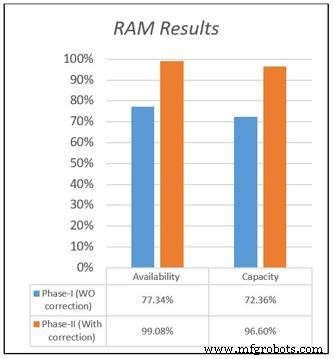 Abbildung 1. Verfügbarkeits- und Kapazitätsergebnisse der RAM-Studie
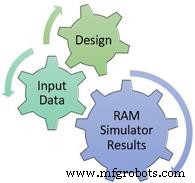 Abbildung 2. Beziehung zwischen Eingabedaten, Design und Simulationsergebnissen
Die Qualität der Eingabedaten bestimmt die Genauigkeit jedes Zuverlässigkeitsmodells – „Garbage in, garbage out.“ Ein RAM-Modell, das auf sauberen, gut strukturierten Daten basiert, ermöglicht Optimierung und präzise KPI-Berechnung.
In fokussierten Zuverlässigkeitsstudien analysieren Ingenieure Betriebsdaten, um „Bad Actor“-Elemente zu identifizieren – Komponenten mit hohen Wartungskosten und Ausfallraten. Empfehlungen, die auf unvollständigen oder verzerrten Daten basieren, riskieren, die echten Probleme zu übersehen und Ressourcen auf falsche Prioritäten zu verschwenden.
Daher sind effiziente Datenerfassungssysteme, die erforderliche Datentypen und -mengen klar definieren, essenziell für informierte Entscheidungsfindung in Wartungsplanung, Ersatzteilmanagement, Budgetierung und technischer Problemlösung.
Drei Schlüsselschritte zur Verbesserung der Datenqualität
1. Die richtige Datenbankplattform einsetzen
Die gewählte Lösung sollte die obligatorische Vervollständigung aller erforderlichen Felder erzwingen, bevor eine Wartungsmeldung oder ein Arbeitsauftrag geschlossen wird. Dies eliminiert Abkürzungen, die Datenkonsistenz gefährden.
2. Bestehende Funktionen in eine einheitliche Lösung integrieren
Eine einzige Plattform, die Zuverlässigkeitsfunktionen konsolidiert, reduziert die Anzahl disparater Systeme. Beispielsweise sichert die Integration von Ersatzteilverfolgung mit Wartungsmeldungen, dass jede Ersatzteilbewegung an einen spezifischen Arbeitsauftrag gebunden ist.
3. Ein Data Quality Assurance Programm implementieren
Regelmäßige Audits der Datenqualität über die Organisation hinweg sind essenziell. Ein praktischer Ansatz ist, zufällig 5 % der Wartungsmeldungen und Arbeitsaufträge an jedem Standort zu stichproben, Datenintegrität zu bewerten und Ergebnisse zur Verfeinerung von Prozessen und Systemnutzung zu nutzen.
Daten sind das Fundament
Umfassende Asset-Wartungs- und Reparaturhistorie muss erfasst, gespeichert und präzise analysiert werden. Frontline-Mitarbeiter – Wartungsteams und Betriebspersonal – müssen ihre kritische Rolle für Datenqualität erkennen.
Daten sind die Grundlage informierter Entscheidungsfindung, und Datenqualität sitzt im Herzen jeder Zuverlässigkeitsstudie. Hochwertige Daten befähigen zu vertrauensvoller Interessenvertretung, rigoroser Forschung, strategischer Planung und transparentem Managementreporting.
Über die Autoren
Khalid A. Al‑Jabr ist Zuverlässigkeitsengineering-Spezialist bei Saudi Aramco mit über 18 Jahren Industrieerfahrung im Bereich Anlagenzuverlässigkeit. Er hält einen Ph.D., ist Chartered Engineer und zertifiziert in Engineering Management und Data Analysis.
Qadeer Ahmed ist beratender Zuverlässigkeitsingenieur bei Saudi Aramco mit 18 Jahren Erfahrung. Chartered Engineer, Ph.D., Certified Maintenance & Reliability Professional (CMRP) und Six Sigma Black Belt.
Dahham Al‑Anazi ist Zuverlässigkeitsengineering-Leiter in Saudi Aramcos Consulting Services. Er hat mehr als 25 Jahre technische Erfahrung und hält einen Doktor in Maschinenbau.
Internet der Dinge-Technologie
- Warum Cloud-Datensicherheit programmierbar wird
- Daten im Internet of Reliability nutzen: Strategien für effektives Management
- Verlässlichkeitsexzellenz: Der Schlüssel zu sichereren, profitableren Betriebsabläufen
- Zukunftsausblick: Industrial IoT für Production Excellence vorantreiben
- Die Kraft visueller Daten im IoT-Ökosystem entfesseln
- Wie Künstliche Intelligenz die Power des Internet of Things verstärkt
- Fundamente für Industrial Data Science Success legen
- Edge AI: Warum die Verarbeitung auf die Geräteebene verlagert wird
- Automatisierung: Der einzige Weg nach vorne für die US-Fertigung
- DataOps: Healthcare-Automatisierung revolutionieren für Kosteneffizienz und Umsatzwachstum