



Data Lakes vs. Data Warehouses: Ein modernes Data Estate aufbauen
27. Juli 2021
Quelle: MCA Connect | Manufacturing Tomorrow
Daten kommen schnell und in vielen Formen. Diese Formen können strukturiert, semi-strukturiert und unstrukturiert sein – viele realisieren nicht, dass Data Warehouse und Data Lake Daten unterschiedlich handhaben.
Ein modernes Data Estate sollte multiple Methoden zum Ingestieren und Speichern der verschiedenen Daten bieten, die Businesses generieren. Daten kommen schnell und in vielen Formen. Diese Formen umfassen strukturierte, semi-strukturierte und unstrukturierte Daten – viele wissen nicht, dass Data Warehouse und Data Lake Daten unterschiedlich behandeln. Schauen wir genauer auf diese Datentypen:
- Strukturiert – traditionelle Datenbanken wie die transaktionale Datenbank für Ihr ERP oder CRM mit formalen Spalten- und Tabellendefinitionen
- Semi-strukturiert – Dateien wie XML oder JSON, die selbstbeschreibend sind mit Tags für Elemente und Hierarchien
- Unstrukturiert – Bilder, Video, Audio und andere Binärdaten
Das Data Warehouse
Wie oben zu sehen, können Datenquellen sehr divers sein und unterschiedliche Repräsentationen haben, was zu divergenten Informationen führt. Zusätzlich macht die große Vielfalt an Schemas und Strukturen in Datenquellen es schwierig, konsolidierte Informationen zu erhalten, wenn ein vollständiger Snapshot aller Business-Subsysteme erforderlich ist. Generell ist das der Hauptgrund für das Entstehen von Data-Warehouse-Lösungen.
Ein Data Warehouse ist ein formales Design, häufig basierend auf Design Guidelines, das einen formalen ETL-Prozess (Extract-Transform-Load) implementiert, um rohe, strukturierte Datensets zu konsumieren und in ein für Reporting designtes Modell zu laden. Data Warehouses bauen auf relationalen Datenbanken wie Azure Synapse (ehemals Microsoft SQL Server) auf. Azure Synapse ist designed, strukturierte Daten in Tabellen mit traditionellen Rows und Columns zu speichern, hat aber die Kapazität, semi-strukturierte Daten wie XML und JSON zu speichern.
Der Data Lake
Ein Data Lake kehrt das ETL-Konzept um und implementiert einen ELT-Prozess (Extract-Load-Transform). Daten in den Data Lake zu ingestieren, bedeutet im Wesentlichen, alles, was man irgendwann für wertvoll hält, in einen großen Storage-Bereich zu werfen – unabhängig von Datentyp oder Struktur. Data Lakes können strukturierte, semi-strukturierte und unstrukturierte Daten speichern. In Microsoft Azure gelieferte Data Lakes bauen auf Storage Accounts mit Data Lake Storage Gen2 auf, aktiviert beim Erstellen des Storage Accounts.
Der Gedanke hinter einem Data Lake: Man will alle Daten konsumieren und später durchsortieren, während das Data Warehouse erfordert, den Wert upfront zu identifizieren mit signifikantem Investment in die Ingestion-Entwicklung. Aufgrund des hohen upfront Investments für Data Warehouse Entwicklung besteht, falls später festgestellt wird, dass Daten fehlten, die nicht initial ingested wurden, das Risiko, dass Quelldaten nicht mehr verfügbar sind und potenziell für immer verloren.
Zweck: unbestimmt vs. in-use
Der Zweck einzelner Datenstücke in einem Data Lake ist nicht fix. Raw Data fließt in einen Data Lake – manchmal mit spezifischem zukünftigem Use Case im Sinn, manchmal nur zum Vorrat. Das bedeutet: Data Lakes haben weniger Organisation und Filtration als ihr Gegenstück.
Processed Data ist Raw Data, die für einen spezifischen Zweck genutzt wurde. Da Data Warehouses nur processed Data beherbergen, wurden alle Daten in einem Data Warehouse für einen spezifischen Zweck in der Organisation genutzt. Das bedeutet: Speicherplatz wird nicht für Daten verschwendet, die nie genutzt werden.
Zugänglichkeit
Zugänglichkeit und Ease of Use bezieht sich auf das Data Repository als Ganzes, nicht die Daten darin. Data Lake Architecture hat keine Struktur und ist daher einfach zuzugreifen und zu ändern. Änderungen an Daten können schnell gemacht werden, da Data Lakes sehr wenige Limitierungen haben.
Data Warehouses sind by Design strukturierter. Ein Hauptvorteil: Die Verarbeitung und Struktur macht die Daten selbst leichter entschlüsselbar, aber die Struktur-Limitationen machen Data Warehouses schwierig und kostspielig zu manipulieren.
Die Vorteile beider
Data Lakes sind kosteneffektiv für die Speicherung großer Datenmengen aus vielen Quellen. Das Zulassen beliebiger Strukturen reduziert Kosten, da Daten flexibler und skalierbarer sind – sie müssen kein spezifisches Pattern erfüllen. Strukturierte Daten sind jedoch leichter zu analysieren, da sie sauberer sind und ein uniformes Schema zum Queries haben. Durch Restriktion auf ein Schema sind Data Warehouses sehr effizient für die Analyse historischer Daten für spezifische Datendecisions. Sowohl ein proper Data Warehouse als auch ein Data Lake sind kritisch für den zukünftigen Erfolg Ihrer Organisation und gehören in Ihr modernes Data Estate.
Was ist ein Data Estate?
Ein modernes Data Estate aufzubauen, ist ein fundamentaler Schritt Richtung Digital Transformation. Ein modernes Data Estate ermöglicht zeitnahe Insights und Entscheidungsfindung über alle Ihre Daten und setzt das Fundament für KI. Ein Data Estate ist alle Daten, die eine Organisation besitzt. Wenn Sie diese Daten in die Cloud migrieren oder Ihre On-Premises-Umgebung modernisieren, gewinnen Sie wichtige Insights für Innovation.
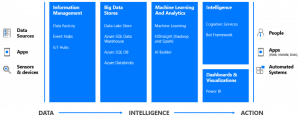
Microsoft Dynamics 365 Pre-Built Data Warehouse, DataCONNECT
Ein Data Warehouse zu bauen, kann sehr teuer und zeitaufwendig sein – Source Systems reviewen, Data Model designen, notwendige ETL erstellen. MCA Connect entwickelte die DataCONNECT Data Warehouse Lösung für Microsoft Dynamics AX, Dynamics 365 Finance und Customer Engagement. Diese Lösung beschleunigt den Timeline für die Lieferung eines umfassenden Data Warehouse signifikant und reduziert Implementierungskosten. Es ist auch ein großartiger Weg, Ihr umfassendes Data Estate zu starten.
DataCONNECT kann Organisationen mit schnellen, akkuraten Informationen versorgen – Fähigkeit zu predict, adapt und shape Operations mit Präzision. Sie können validierte Daten schnell in Forecasting-Modelle ziehen, um Planungszyklen für Bereiche Ihres Business zu starten. Wenn Sie mehr darüber erfahren möchten, wie DataCONNECT Data Warehouse oder ein Data Lake Ihrem Unternehmen helfen kann, Big Data zu speichern, kontaktieren Sie uns. Einer unserer Experten wird Sie gerne in die richtige Richtung leiten.
Content & Meinungen in diesem Artikel sind die des Autors und repräsentieren nicht notwendigerweise die Views von Manufacturing Tomorrow.
Industrietechnik
- Die vierte industrielle Revolution: Wie Industry 4.0 die Fertigung neu formt
- Datenschutz-Compliance im Internet der Dinge sicherstellen
- Daten im Internet of Reliability nutzen: Strategien für effektives Management
- Von Elfenbein zu Bakelit: Die Entwicklung moderner Kunststoffe nachzeichnen
- Predictive Maintenance: Industry 4.0 für unterbrechungsfreie Produktion nutzen
- Demokratisierung des Internet der Dinge: Next-Gen Satelliten-IoT bringt universelle, bezahlbare Konnektivität
- Den Wert von IoT-Daten erschließen: Sichere, insight-gesteuerte Strategien
- Warum analoge Messungen die Anlagenleistung antreiben
- Strategische Datensourcen: Der Schlüssel zu resilienten Lieferketten
- Effizienz maximieren: Expertentipps für Ihr Lager-Scansystem