



FRACAS: Anlagenausfälle in Business-Gewinne verwandeln
In Wartungskreisen wird Versagen oft geächtet, ein Wort, das Kritik und strenge Ausfallzeit-Metriken triggert. Doch viele Ausfallereignisse resultieren aus Faktoren außerhalb direkter Kontrolle – Anlagenalter, Design-Entscheidungen, Operator-Fehler. Statt Versagen zu fürchten, können wir es als mächtiges Diagnose-Tool nutzen.
„Sie brauchen Versagen, um sich zu verbessern“, sagt Thibaut Drevet, Solutions Engineer bei Fiix und ehemaliger Industrieingenieur. „Versagen offenbart, wie Systeme sich verhalten und leitet uns, sie effektiver zu warten.“ Dieser Artikel erklärt, wie ein FRACAS – Failure Reporting, Analysis, and Corrective Action System – Pannen in strategische Vorteile transformiert.
Was ist FRACAS?
FRACAS ist ein Closed-Loop-Reporting-Framework, designed um wiederkehrende Anlagenausfälle zu eliminieren. Es besteht aus drei Kernschritten:
- Failure Reporting – systematisches Erfassen jedes Incidents.
- Failure Analysis – Lessons Learned und Root Causes ableiten.
- Failure Correction – Lösungen implementieren, um Wiederholung zu verhindern.
Durch Integration historischer Performancedaten identifiziert FRACAS Muster, informiert Wartungsstrategie und leitet zukünftige Design-Entscheidungen.
FRACAS Loop aufbauen
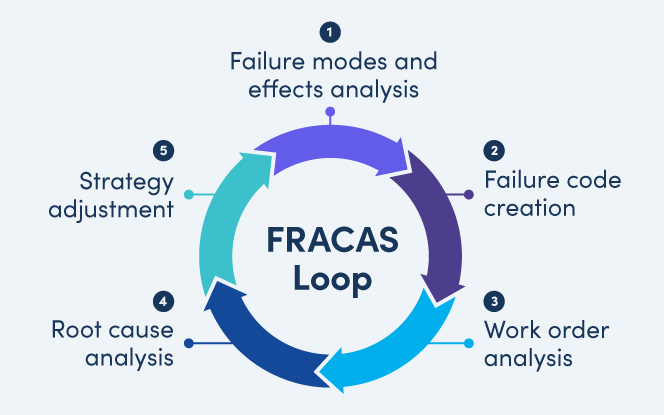
Der FRACAS Loop ist ein zyklischer Prozess, der kontinuierlich neue Insights zurück in das System speist. Er besteht aus fünf verknüpften Aktivitäten:
- Failure Modes and Effects Analysis (FMEA)
- Failure Code Erstellung
- Work Order Analyse
- Root Cause Analysis (RCA)
- Strategie-Anpassung
Failure Modes and Effects Analysis (FMEA)
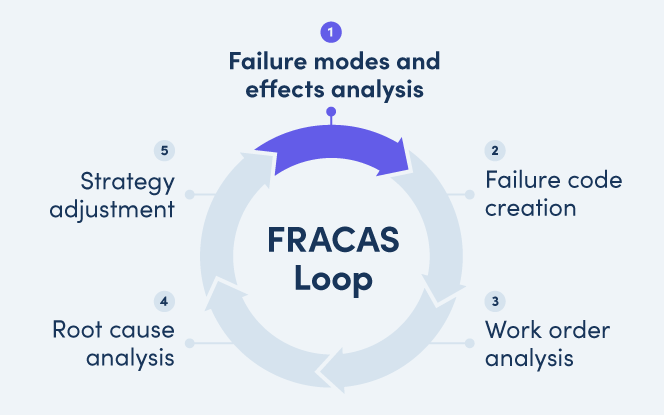
Eine FMEA antizipiert Worst-Case-Szenarien. Sie katalogisiert jeden möglichen Ausfall, dessen Impact und Korrekturmaßnahmen. Das Standard-FMEA-Framework umfasst zehn Elemente:
- Anlagenkomponente
- Potenzielle Ausfallmodi
- Potenzielle Ausfalleffekte
- Schwere des Ausfalls
- Potenzielle Ursachen
- Erwartete Ausfallhäufigkeit
- Aktuelle Detektions- und Präventionsprozesse
- Detektierbarkeit des Ausfalls
- Gesamtrisikobewertung
- Empfohlene Aktion
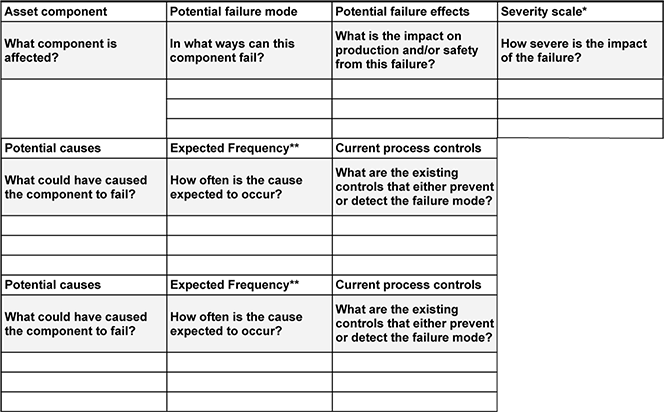
Eigenes FMEA Template hier herunterladen
Die FMEA dient als lebende Baseline, updated wann immer neue Daten oder Insights entstehen. Diese iterative Natur hält den FRACAS Loop relevant und responsiv.
Failure Code Erstellung
Failure Codes destillieren komplexe Incidents in prägnante Deskriptoren, die Teil, Defekt und Root Cause erfassen. Beispiel: Ein variabler Förderband könnte den Code generieren: Lager – Verschleiß – Schmierungsmangel.
Best Practices für Coding:
- Distinkte Naming Convention für jede Komponente adoptieren.
- Defekte in klare Kategorien gruppieren (z. B. Verschleiß, Überhitzung).
- Pre-loaded Codes auf die häufigsten zehn limitieren; Exzess Optionen verwässern Präzision.
- Code-Liste mit Frontline-Technikern validieren, bei Bedarf verfeinern.
Diese Codes zu tracken offenbart Trendmuster, erlaubt Teams, die kostspieligsten oder häufigsten Ausfälle zu targetieren.
Work Order Analyse
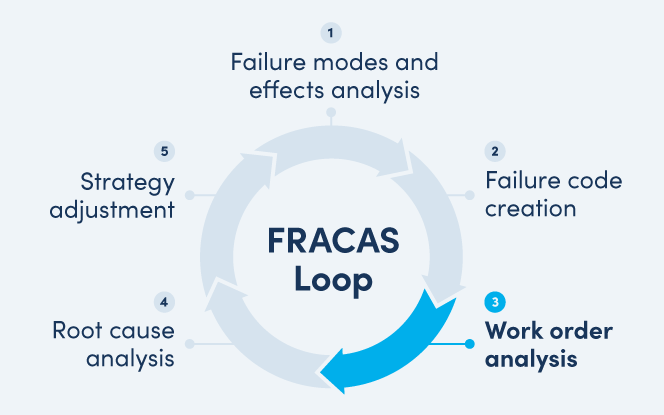
Isolierte Ausfälle sind Ärgernisse; wiederholte, ähnliche Incidents signalisieren systemische Issues. Durch Review von Failure Codes innerhalb von Work Orders können Sie High-Frequency-Probleme spotten. Beispiel: Vier Maschinen melden 12 Ausfälle über sechs Monate, 10 davon auf Lagerklemmung durch Fehlausrichtung – die Daten pinpointen, wo Ressourcen fokussiert werden müssen.
Über Failure Codes hinaus Metriken wie Reparaturzeit, Ausfallimpact und Teilkosten analysieren, um wahren Kosten wiederkehrender Incidents zu evaluieren.
Root Cause Analysis (RCA)
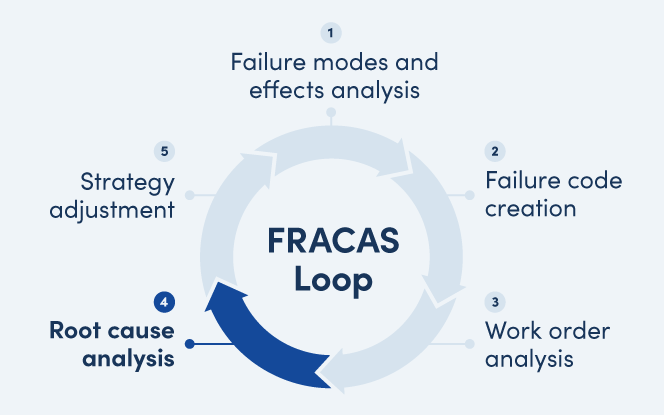
RCA ist die Brücke zwischen Troubleshooting und nachhaltiger Verbesserung. Ein Quick Fix – wie Neuausrichtung eines Lagers – mag Symptome temporär lösen, aber versagt, underlying Causes anzugehen. Eine RCA gräbt tiefer, oft mittels „5 Whys“-Technik:
- Warum war das Lager fehlausgerichtet? – Weil die Welle fehlausgerichtet war.
- Warum war die Welle fehlausgerichtet? – Unsachgemäße Montage.
- Warum war die Montage gehetzt? – Unzureichend geplante Wartungszeit.
- Warum war die Zeit unzureichend? – Produktions-Scheduling-Constraints.
- Warum ist das Scheduling eng? – Ineffizienter Planungsprozess.
RCA erfordert diverse Inputs, um Annahmen zu vermeiden; Techniker, Planer, Ingenieure einzubinden liefert ganzheitliche Sicht.
Strategie-Anpassung
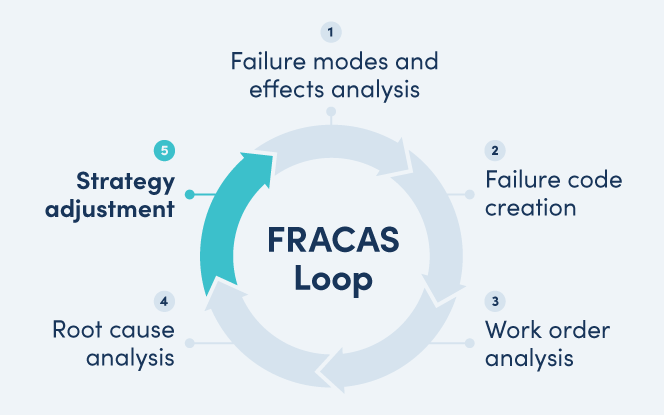
Insights allein treiben keinen Fortschritt; Action ist essenziell. Anpassungen reichen von Minor-Prozess-Tweaks – Schmier-Schritte hinzufügen – bis zu major organisationalen Shifts – Spezialisten einstellen. Effektive Strategien umfassen:
- Techniker früh einbinden; Rationale und Benefits erklären für Buy-in.
- Outcomes monitoren; Impact auf Ausfallzeiten, Kosten, Workforce-Moral tracken.
- Änderungen inkrementell implementieren; auf einem Asset piloten vor Skalierung.
Loop schließen
Nach Strategie-Änderungen FRACAS-Zyklus revisiten, um Verbesserungen zu bestätigen:
- FMEA mit neuen Ausfalldaten und revidierten Mitigation Steps updaten.
- Failure Codes auditieren, neue hinzufügen, obsolete retirieren.
- Impact Reports generieren – Ausfallfrequenz, Kosteneinsparungen, Schedule-Stabilität – um ROI zu validieren.
Hochwertige FRACAS-Daten sicherstellen
Zuverlässige Daten untermauern jeden FRACAS-Schritt. Um dies zu erreichen, Kultur pflegen, die Wartung wertschätzt, Work Orders straffen, Automatisierung nutzen, regelmäßig auditen.
Maintenance-Positive Culture aufbauen
Techniker hetzen oft, Jobs zu beenden, was Datenintegrität kompromittiert. Wenn Wartung als Verbündeter der Produktion gesehen wird – kostspielige Ausfallzeiten reduzierend – allozieren Techniker Zeit für präzises Logging.
Klare Work Orders designen
Unklare, cluttered Orders laden zu Fehlidentifikation und unvollständigen Daten ein. Starten Sie mit:
- Grundlagen meistern: Wartungs-Arbeitsaufträge
- Kurzer Guide zu Work Orders, die Goals crushen
- Maintenance Work Order Template
- Equipment Maintenance Log Template
- Präventive Wartungs-Checkliste
Automatisieren und Integrieren
Condition-Monitoring-Software eliminiert manuelle Meter-Readings, sichert Echtzeit, präzise Datenerfassung. Integration dieser Tools mit CMMS strafft Datenfluss und triggert proaktive Wartung.
Monatlich Daten auditen
Regelmäßige Spot-Checks und Techniker-Interviews decken Dateneingabe-Fallen auf. Fragen:
- Sind Tasks unnötig? Entfernen oder klären.
- Sind erforderliche Daten klar und wertvoll? Alle auf Key Metrics alignen.
- Ist Logging-Prozess user-friendly? Komplexe Code-Listen oder Messungen vereinfachen.
Fünf FRACAS-getriebene Reports für Results
- Failures After Start-Up – Identifiziert Incidents, die Produktion vor Start stoppen.
- Maintenance Costs by Failure Code – Aggregiert Arbeits- und Teilekosten, um High-Cost-Ausfälle zu priorisieren.
- Maintenance Hours by Failure Code – Hebt zeitfressende wiederkehrende Issues hervor.
- Scheduled vs. Unscheduled Failures – Enthüllt reaktive Wartungslast.
- Failures by Shift or Site – Detektiert Prozess- oder Trainings-Gaps across Locations.
Real-World FRACAS Success Stories
- Identifiziert, dass alternde Teile die meisten Ausfälle verursachten; Daten genutzt für höheres Inventarbudget und Ausfallzeitreduktion.
- Ausfall-Surge gebunden an neue Produktspec entdeckt; Kommunikationsprotokoll etabliert, das Incidents über mehrere Plants reduzierte.
- Drei Ausfalltypen priorisiert, den impactvollsten gewählt, Success Data genutzt, um Einstellung zusätzlicher Techniker für verbleibende Issues zu rechtfertigen.
Fazit
FRACAS zu meistern verlangt Daten, Zeit und unerschütterliches Commitment. Klein starten, Wins feiern, iterativ weitermachen. Der langfristige Payoff – höhere Zuverlässigkeit, niedrigere Kosten, proaktive Wartungskultur – überwiegt den initialen Aufwand bei Weitem.
Gerätewartung und Reparatur
- IoT-Daten freisetzen: Wie Business Rules Management Enterprise Value treibt
- Energiekosten senken: Bewährte Green-Strategien für Hersteller
- Schutz industrieller Elektronik vor Blitzschäden: Bewährte Schutzstrategien
- Kosten sparen durch rechtzeitige Industrieanlagen-Reparatur: 4 Vorteile
- Bewährte Strategien zur Wartung industrieller Fertigungsausrüstung
- Wassergekühlte Bremsen verstehen: Wie sie industrielle Anlagen sicher und effizient halten
- Effektives Instandhaltungsprogramm (Preventive Maintenance) für Anlagen aufbauen
- Büroorganisation in Fertigungsanlagen meistern: Bewährte Tipps für Effizienz & Stressreduktion
- Bewährte Techniken zur Korrosionsverhütung an Metallausrüstung
- Laufwerksdurchhang verhindern: Bewährte Wartungsstrategien für Schwergeräte