



Lokale Minima im neuronalen Netzwerk-Training: Mythos oder Realität?
Die Rolle lokaler Minima im Perzeptron- und Multilayer-Neuronalnetz-Training verstehen.
In der AAC Neuronalnetz-Serie haben wir viele Aspekte des Multilayer-Perzeptron-Designs und -Trainings untersucht. Bevor wir in lokale Minima eintauchen, reviewen Sie die vorangegangenen Posts:
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
- Wie viele Hidden Layers und Hidden Nodes braucht ein Neuronales Netz?
- Genauigkeit eines Hidden Layer Neuronalen Netzes erhöhen
- Bias Nodes in Ihr Neuronales Netzwerk einbinden
- Lokale Minima im Neuronalnetz-Training verstehen
Ein neuronales Netzwerk zu trainieren ist eine anspruchsvolle Optimierungsaufgabe. Während wir selten jeden mathematischen Nuance verstehen müssen, um effektive Modelle zu bauen, bleibt das Phänomen lokaler Minima eine kritische theoretische Überlegung.
Warum lokale Minima wichtig sind
Historisch wurden lokale Minima als großes Hindernis beim Training angesehen, besonders für komplexe Input-Output-Abbildungen. Aktuelle Forschung – wie Studien zur Loss-Surface-Geometrie (z. B. Choromanska et al., 2015; Dauphin et al., 2014) – deutet darauf hin, dass moderne Architekturen und Trainingsheuristiken die Schwere dieses Problems reduzieren. Dennoch hilft das Verständnis lokaler Minima zu begreifen, wie gradientenbasierte Optimierer hochdimensionale Loss-Landschaften navigieren und warum bestimmte Trainingsstrategien suboptimale Punkte verlassen können.
Lokales Minimum definieren
Betrachten wir eine einfache quadratische Fehleroberfläche: f(x, y) = x² + y². Jeder Punkt, der den niedrigstmöglichen Fehler liefert – das globale Minimum – ist das Trainingsziel. In einer perfekt konvexen Schüssel wird Gradient Descent immer zu diesem Punkt konvergieren, unabhängig von der Startposition.
In der Praxis sind Loss-Oberflächen weit von konvex entfernt. Sie können mehrere Täler und Plateaus enthalten, wie unten illustriert:
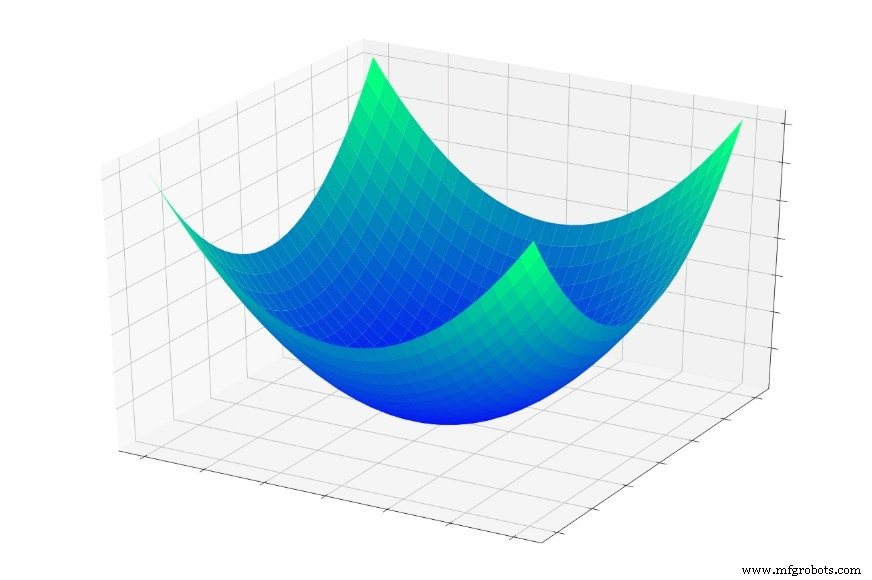
Wenn der Optimierer in ein flaches Becken tritt, kann er in einem lokalen Minimum verharren – dem tiefsten Punkt in dieser lokalen Region – aber nicht dem globalen. Ohne globales Wissen kann der Algorithmus nicht „hinaufklettern“, um tiefere Täler zu erkunden.
Brauchen wir wirklich das globale Minimum?
Während das Erreichen des globalen Minimums oft mit niedrigerem Trainingsfehler korreliert, ist es nicht immer synonym mit besserer Generalisierung. Hoch expressive Netze, die perfekten Fit auf Trainingsdaten erreichen, können überanpassen (overfit), was Leistung auf unbekannten Samples reduziert. In solchen Fällen kann ein gut platziertes lokales Minimum eine robustere Lösung bieten. Zusätzlich können Sattelpunkte – flache Regionen, wo Gradienten in manchen Richtungen verschwinden – eine größere Herausforderung darstellen als einfache lokale Minima (Goodfellow et al., 2015).
Praktische Implikationen
Moderne Trainingspraktiken mildern lokale-Minima-Effekte durch Techniken wie Stochastic Gradient Descent, Lernraten-Schedules, Momentum, Adam Optimizer und Gewichtsinitialisierungs-Schemata. Ensemble-Methoden und Regularisierung (Dropout, L2) helfen dem Modell auch, Überanpassung an das globale Minimum zu vermeiden.
Fazit
Lokale Minima bleiben ein faszinierender Aspekt des Neuronalnetz-Trainings. Ihr Verständnis informiert die Wahl von Architektur, Optimierer und Regularisierungsstrategie. Im nächsten Artikel werden wir konkrete Techniken erkunden – wie Lernraten-Annealing und adaptive Optimierer –, die Netze zu wünschenswerten Minima führen.
Industrieroboter
- Netzwerktopologien verstehen: Von Punkt-zu-Punkt bis Ring und Stern
- Netzwerkprotokolle verstehen: Von der Physikalischen Schicht bis zu fortgeschrittener Arbitration
- STMicroelectronics stellt STM32Cube.AI vor: Edge-Geräte mit eingebetteten Neural Networks befähigen
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Bias-Nodes zu einem Multilayer Perzeptron in Python hinzufügen
- Hidden Layer Größe optimieren für höhere Neuronale Netzwerk Genauigkeit
- Künstliche Neuronale Netze steigern Wireless-Kommunikationsleistung
- Training großer neuronaler Netze emittiert 284.000 kg CO₂ – entspricht 5 Autolebenszyklen
- Robotergestütztes Faserlaserschneiden vs. Plasmaschneiden: Unterschiede & richtige Wahl
- NISTs Neuronales Netzwerk detektiert winzige geometrische Formen in dichten Bildern mit 97% Genauigkeit