



Bias-Nodes zu einem Multilayer Perzeptron in Python hinzufügen
Dieser Artikel erklärt, wie man Bias-Nodes in einen Multilayer Perzeptron (MLP) mit Python integriert und deren Effekt auf Klassifikationsperformance evaluiert.
Willkommen zur All About Circuits Neuronalnetz-Serie, verfasst von Engineering Director Robert Keim. Falls Sie die anderen Lektionen noch nicht erkundet haben, finden Sie sie unten aufgelistet. Sie bieten ein solides Fundament für die hier diskutierten Konzepte.
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
- Wie viele Hidden Layers und Hidden Nodes braucht ein Neuronales Netz?
- Genauigkeit eines Hidden Layer Neuronalen Netzes erhöhen
- Bias Nodes in Ihr Neuronales Netzwerk einbinden
Bias-Nodes sind zusätzliche Eingänge, die einen konstanten Wert – typischerweise +1 – direkt an die Eingangs- oder Hidden-Layer eines Perzeptrons liefern. Sie erlauben dem Netzwerk, Entscheidungsgrenzen zu verschieben, ohne die Eingabedaten selbst zu verändern. Dieser Artikel stellt zwei praktische Methoden zum Hinzufügen von Bias-Nodes vor und zeigt, wie man deren Einfluss auf Modellgenauigkeit beurteilt.
Methode 1: Bias über Spreadsheet hinzufügen
Wenn Ihre Trainings- oder Validierungsdaten in einem Spreadsheet liegen, können Sie eine Bias-Spalte einfügen, ohne den Python-Code anzufassen.
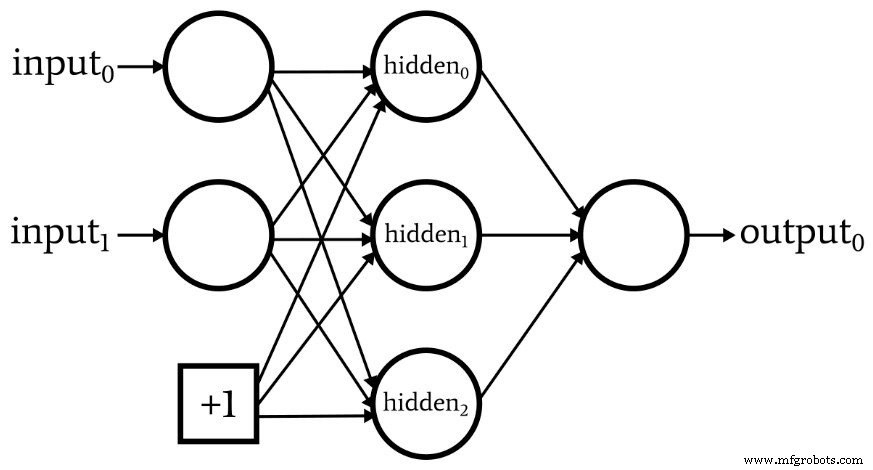
Schritte:
- Neue Spalte im Spreadsheet einfügen und mit dem gewünschten Bias-Wert (üblicherweise +1) füllen.
- Input-Layer-Dimensionalität im Code anpassen, um die neue Spalte zu berücksichtigen.
Dieser Ansatz ist schnell und erfordert keine Code-Änderungen, ideal für Prototyping.
Methode 2: Bias direkt in Python integrieren
Für mehr Flexibilität – wie Hinzufügen von Bias zu Hidden-Layern – modifizieren Sie die Netzwerkarchitektur im Code. Unten ein prägnantes Beispiel, das Bias-Nodes sowohl zu Input- als auch Hidden-Layern hinzufügt.
Input-Layer-Dimensionalität aktualisieren
# Trainingsdaten laden
training_data = np.array(...) # shape: (samples, features)
training_count = training_data.shape[0]
# Spalte aus +1 für Input-Bias anhängen
bias_column = np.ones((training_count, 1))
training_data = np.hstack((training_data, bias_column))
# Für Validierungsdaten wiederholen
validation_data = np.hstack((validation_data, np.ones((validation_count, 1))))
Hier erstellt np.ones eine Spalte aus Einsen, die den konstanten Bias-Eingang repräsentiert. np.hstack fügt diese Spalte an die bestehende Feature-Matrix an.
Hidden-Layer-Bias-Node hinzufügen
# Während Feedforward-Berechnung für jeden Hidden Node
for node in range(hidden_dim):
    # Gewichtete Summe für jeden Hidden Node berechnen
    z = np.dot(input_vector, weights_input_hidden[:, node])
    post_activation[node] = activation_function(z)
# Bias-Node-Wert (+1) in Hidden Layer einfügen
post_activation[hidden_dim] = 1.0 # Bias-Node am Ende
Wenn hidden_dim den Bias-Node einschließt, stoppt die Schleife vor dem letzten Node, und der Bias-Wert wird danach zugewiesen. Passen Sie den entsprechenden Validierungsloop analog an.
Andere Bias-Werte wählen
Obwohl +1 konventionell ist, können Sie mit anderen Konstanten experimentieren. Für Input-Bias multiplizieren Sie bias_column mit dem gewünschten Wert. Für Hidden-Bias modifizieren Sie die Zuweisung im Feedforward-Loop entsprechend.
Bias-Einfluss evaluieren
In Teil 16 der Serie kämpfte der MLP damit, den hochkomplexen Experiment-3-Datensatz zu klassifizieren. Um zu prüfen, ob Bias-Nodes helfen könnten, führten wir zehn unabhängige Trainingsläufe mit einer Hidden-Layer-Größe von sieben Units durch und verglichen vier Konfigurationen: kein Bias, nur Input-Bias, nur Hidden-Bias, beide Biases.
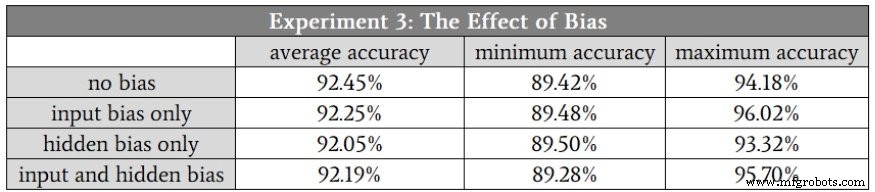
Die Ergebnisse zeigen minimale Unterschiede – Bias-Nodes verbesserten die Genauigkeit für diesen speziellen Datensatz nicht signifikant. Dieses Ergebnis stimmt mit anderen Studien überein, die nahelegen, dass Bias-Nodes in bestimmten Kontexten nützlich sein können, aber kein universeller Performance-Booster sind.
Fazit
Während Bias-Nodes die Klassifikationsgenauigkeit nicht in allen Szenarien transformieren, bleiben sie ein wertvolles architektonisches Werkzeug. Die Integration von Bias-Support in Ihre Codebase stellt sicher, dass Sie dessen Effektivität auf zukünftigen Datensätzen oder Modellvarianten schnell testen können. Indem Sie den oben skizzierten Methoden folgen, können Sie Bias-Nodes mit minimalem Aufwand hinzufügen und deren Einfluss systematisch evaluieren.
Industrieroboter
- Network Monitoring revampen: Ein strategischer Playbook für modernes Enterprise IT
- Industrielle IoT-Geräte härten gegen Cyber-Angriffe
- Günstiges drahtloses Sensornetzwerk für Zuhause selbst bauen
- Lokale Minima im neuronalen Netzwerk-Training: Mythos oder Realität?
- Hidden Layer Größe optimieren für höhere Neuronale Netzwerk Genauigkeit
- Ersatzteilmanagement in CMMS integrieren: Effizienz steigern & Kosten senken
- Die richtige IoT-Netzwerkwahl: Einblicke von Branchenexperten
- Robotik-Integration meistern: Erfolgsstrategien für Ihre Fertigung
- Supply-Chain-Störungen in strategische Chancen verwandeln
- Sicherheit Ihres Shopfloor-Netzwerks: Sind Sie vorbereitet?