



Variational Autoencoder mit TensorFlow bauen: Ein praktischer Leitfaden
Grundlagen von Autoencodern meistern, entdecken wie Variational Autoencoder sie verbessern, und durch eine schrittweise TensorFlow-Implementierung gehen.
Künstliche Intelligenz hat unzählige Sektoren umgestaltet, und Datenkompression bildet keine Ausnahme. Autoencoder – besonders ihre variationalen Varianten – bieten leistungsstarke, generative Kompressionsschemata, die sowohl effizient als auch expressiv sind. Dieser Leitfaden zerlegt die Kernkonzepte und führt Sie durch eine vollständige TensorFlow-Implementierung mit dem MNIST-Datensatz.
Autoencoder-Anwendungen
Autoencoder finden breite Anwendung in Bereichen von neuronaler maschineller Übersetzung bis Arzneimittelentdeckung, Bildentrauschen und Anomalieerkennung. Ihre Fähigkeit, komprimierte, informative Repräsentationen zu lernen, macht sie zum Standardwerkzeug moderner ML-Pipelines.
Kernkomponenten eines Autoencoders
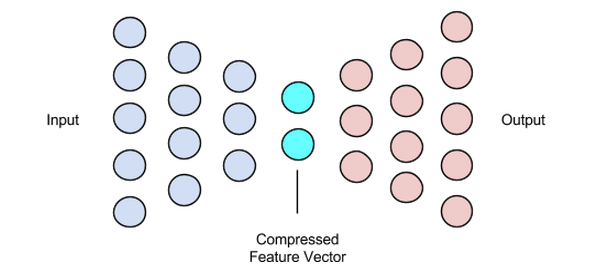
Im Gegensatz zu typischen neuronalen Netzen verfügen Autoencoder über einen Flaschenhals, der eine niedrigdimensionale latente Repräsentation erzwingt. Die Architektur besteht aus drei primären Teilen:
- Encoder – komprimiert Eingabedaten in einen latenten Vektor.
- Flaschenhals (Latenter Vektor) – speichert die aussagekräftigsten Merkmale.
- Decoder – rekonstruiert die Eingabe aus dem latenten Vektor.
Encoder und Decoder sind meist Feed-Forward-Netzwerke, aber spezialisierte Varianten – konvolutional für Bilder, rekurrent für Text – sind in der Praxis üblich.
Encoder
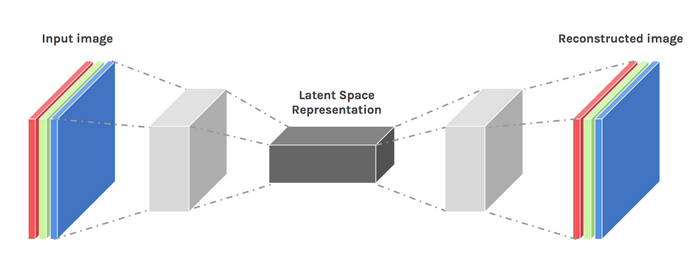
Der Encoder bildet hochdimensionale Eingaben (z. B. 28×28 Pixelbilder) auf einen kompakten latenten Vektor ab. Während des Trainings optimiert er seine Gewichte so, dass der latente Vektor essenzielle Information erfasst, was dem Decoder ermöglicht, die Eingabe mit minimalem Verlust zu rekonstruieren.
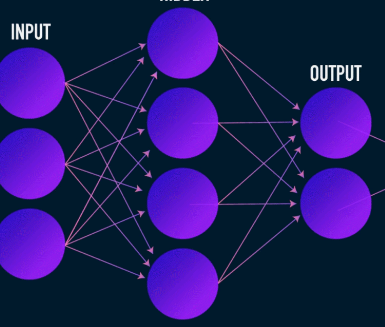
Flaschenhals (Latenter Vektor)
Die Größe des latenten Vektors ist ein Trade-off: zu klein und kritische Details gehen verloren; zu groß und Kompression sowie Rechenaufwand werden untergraben. Die Wahl einer angemessenen Dimensionalität ist entscheidend für Modellperformance.
Decoder
Der Decoder spiegelt den Encoder wider und transformiert den latenten Vektor zurück in den ursprünglichen Datenraum. Er nutzt typischerweise transponierte Konvolutionen oder Upsampling-Layer, um räumliche Auflösung wiederherzustellen.
Autoencoder trainieren
Autoencoder werden End-to-End mit gradientenbasierten Optimizern wie Adam trainiert. Das Ziel ist, einen Rekonstruktionsverlust zu minimieren, der die Diskrepanz zwischen Eingabe und Rekonstruktion quantifiziert.
Verlustfunktionen
Gängige Optionen sind L1, L2 und Mean Squared Error (MSE). Jede misst, wie nah die Ausgabe an der Eingabe ist, was sie für generative Rekonstruktionsaufgaben geeignet macht.
Netzwerkvarianten
Während Multi-Layer Perceptrons (MLPs) als Encoder/Decoder dienen können, werden Convolutional Neural Networks (CNNs) für Bilddaten aufgrund ihrer räumlichen Wahrnehmung bevorzugt. Rekurrente Netze glänzen bei sequenziellen Daten wie Text.
Standard-Autoencoder fehlt Kreativität – sie können nur Daten reproduzieren, die während des Trainings gesehen wurden. Die Einführung von Stochastizität via variationalem Framework schaltet generative Fähigkeiten frei.
Variational Autoencoders (VAEs)
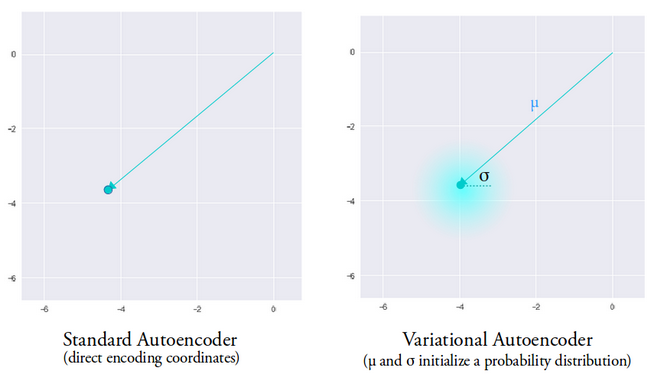
VAEs modifizieren die Standardarchitektur in zwei Weisen:
- Der Encoder gibt einen Mittelwertvektor und einen Varianzvektor aus, die eine Gauß-Verteilung definieren.
- Ein Kullback-Leibler (KL) Divergenz-Term wird zum Verlust hinzugefügt, um die latente Verteilung Richtung Einheits-Gauß zu regularisieren.
Während der Inferenz sampelt der Encoder einen latenten Vektor aus der gelernten Verteilung, was dem Decoder ermöglicht, diverse, realistische Rekonstruktionen zu generieren. Diese Stochastizität mildert die Diskontinuitäten, die oft in deterministischen Autoencodern beobachtet werden.
TensorFlow-Implementierung
Unten finden Sie eine prägnante, produktionsreife TensorFlow-Implementierung eines konvolutionalen VAE, trainiert auf MNIST.
Datenvorbereitung
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
VAE Modelldefinition
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
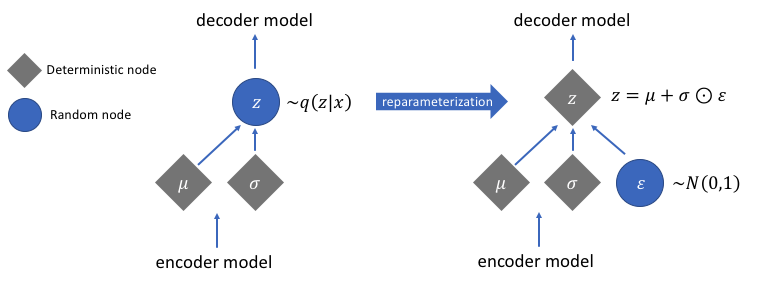
Kernhelferfunktionen – encode, reparameterize und decode – kapseln den VAE-Workflow. Die reparameterize Methode implementiert den Reparameterisierungstrick, der Gradientenfluss durch stochastisches Sampling ermöglicht.
Reparameterisierungstrick
Direktes Samplen eines latenten Vektors aus einer Verteilung bricht Differenzierbarkeit. Durch Ausdrücken des Samples als z = mean + std * eps mit eps ~ N(0,1) propagieren Gradienten durch mean und std. Der KL-Divergenz-Term aligniert die gelernte Verteilung weiter mit einer Standardnormalverteilung, was glatte latente Räume fördert.
Kurzfassung der Schritte
- Encoder- und Decoder-Architekturen definieren.
- Reparameterisierungstrick implementieren, um Back-Propagation zu ermöglichen.
- Modell End-to-End trainieren, Rekonstruktionsverlust plus KL-Divergenz minimieren.
Für den vollständigen Code und zusätzliche Trainingsskripte besuchen Sie das offizielle TensorFlow Tutorial.
Bildquelle: Chiman Kwan (modifiziert)
Industrieroboter
- Wie 3D-Drucker Metallteile fertigen: Vom Pulver zur Präzision
- Abfall und Energiekosten senken mit autonomen Robotern
- Cloud Technologie sichern: Best Practices für Datenschutz und Risikominderung
- Daten im Internet of Reliability nutzen: Strategien für effektives Management
- IoT für HVAC Big Data nutzen: Energie, Komfort und Luftqualität optimieren – Teil 2
- IoT mit IBM & Tech Data zum Leben erwecken – Teil 2
- IoT in die Realität umsetzen: Tech Data & IBM Insights – Teil 1
- KI-gesteuerte Roadmaps: Strategischer Leitfaden für Supply-Chain-Unternehmen
- Data Mining & KI nutzen: Blaupause für Industrie-Marken, um im E-Commerce zu gedeihen
- Werkzeuglebensdauer mit Maschinendaten optimieren: Ein moderner Leitfaden