



Hidden Layer Größe optimieren für höhere Neuronale Netzwerk Genauigkeit
In diesem Artikel führen wir Klassifikationsexperimente durch und analysieren, wie die Hidden-Layer-Dimensionalität die Performance eines Neuronalen Netzes beeinflusst.
Erfahren Sie, wie die Anpassung des Hidden Layers in einem Perzeptron Genauigkeit verbessern, Trainingszeit reduzieren und akzeptable Latenz bewahren kann – demonstriert mit Python-Implementation und echten Datensätzen.
Bevor wir eintauchen, reviewen Sie frühere Posts unserer Neuronalnetz-Serie für ein solides Fundament:
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
- Wie viele Hidden Layers und Hidden Nodes braucht ein Neuronales Netz?
- Genauigkeit eines Hidden Layer Neuronalen Netzes erhöhen
Die Anzahl der Nodes in einem Hidden Layer beeinflusst direkt Klassifikationsgenauigkeit und Trainingsgeschwindigkeit. Unsere Experimente liefern datengestützte Intuition für die Auswahl einer Hidden-Layer-Größe, die Geschwindigkeit, Latenz und Genauigkeit ausbalanciert.
Benchmarking in Python
Wir erweitern den bestehenden Python-Code aus Teil 12, um Trainings- und Validierungsdauern mit time.perf_counter() zu erfassen. Unten die Timing-Instrumentierung:
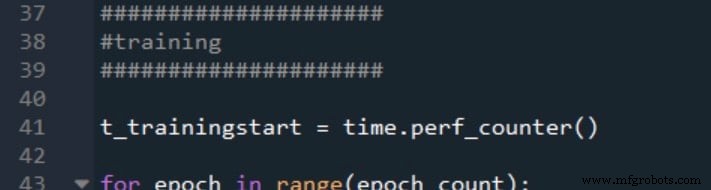
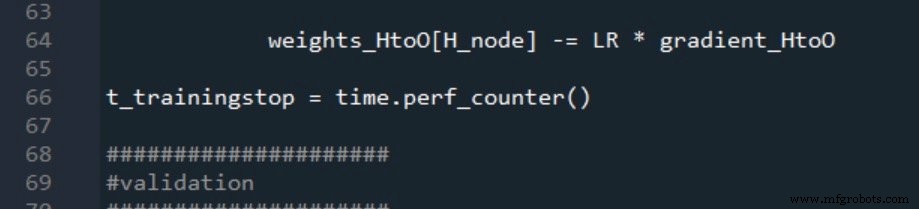
Validierungs-Timing folgt demselben Muster:
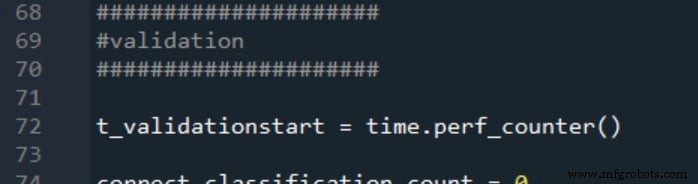
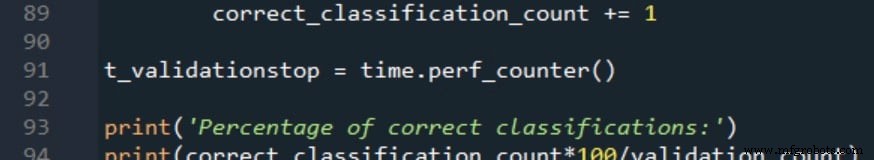
Die Ergebnisse werden berichtet als:
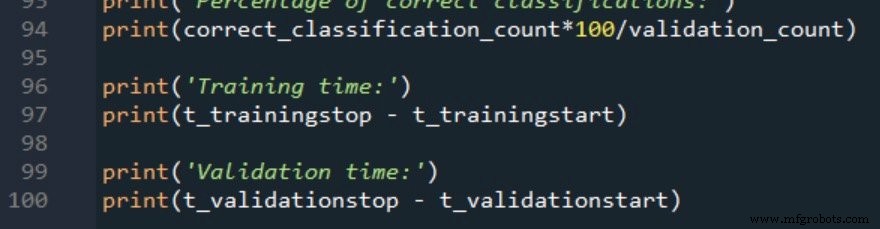
Trainingsdaten und Messprozedur
Wir testen eine binäre Klassifikationsaufgabe mit vier numerischen Inputs von –20 bis +20. Die Netzwerkarchitektur ist 4 Input-Nodes, ein einzelner Hidden Layer, ein Output-Node. Input-Werte werden mit der unten gezeigten Excel-Formel generiert:
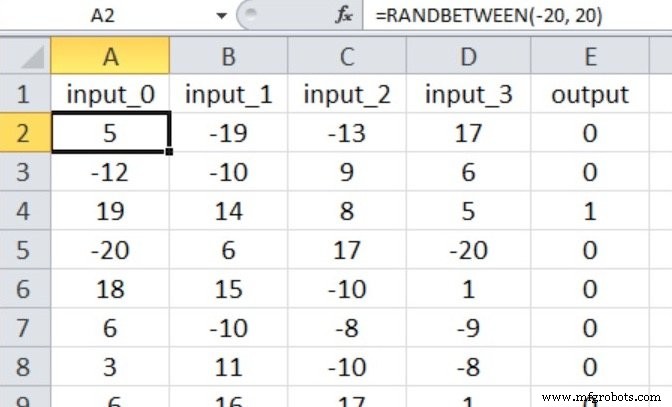
Datensatzgrößen: 40.000 Trainings- und 5.000 Validierungssamples. Lernrate 0,1, ein voller Epoch pro Run. Jede Hidden-Layer-Dimension wird fünfmal getestet; berichtete Genauigkeit und Timing sind arithmetische Mittelwerte.
Experiment 1: Niedrigkomplexes Problem
Das Target ist nur wahr, wenn die ersten drei Inputs null übersteigen; der vierte Input ist irrelevant:
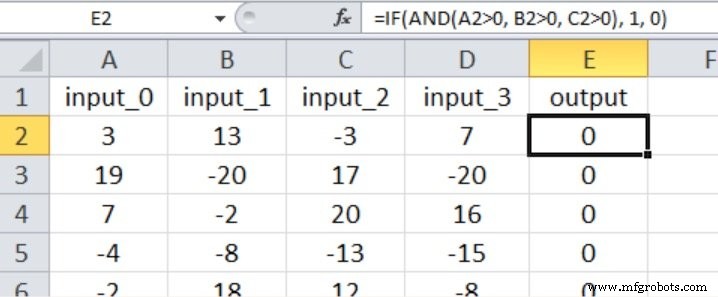
Nach der Richtlinie zwei Drittel der Input-Größe starten wir mit H_dim = 2. Ergebnisse zusammengefasst:
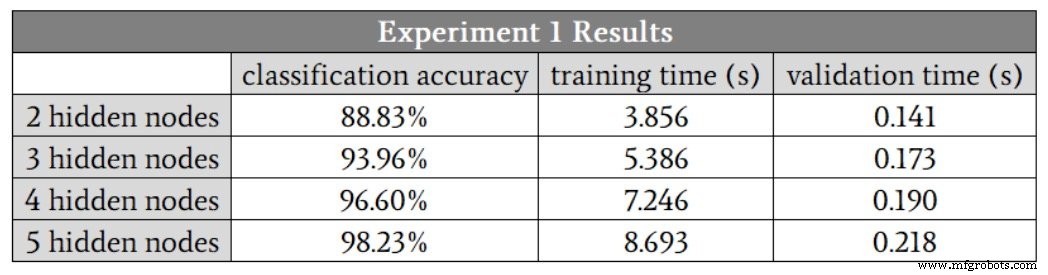
Genauigkeit verbessert sich bis zu fünf Hidden Nodes, aber der marginale Gewinn von vier auf fünf Nodes ist gering, da ein Run mit vier Nodes ein Ausreißer war (88,6 %). Entfernt man den Ausreißer, schneiden vier Nodes leicht besser ab als fünf. Trainingszeit steigt 1,9× von zwei auf vier Nodes, Validierungszeit nur 1,3× – was zeigt, dass Training der rechenintensivere Phase ist.
Experiment 2: Mittelkomplexes Problem
Alle vier Inputs beeinflussen den Output mit nuancierteren Vergleichen:
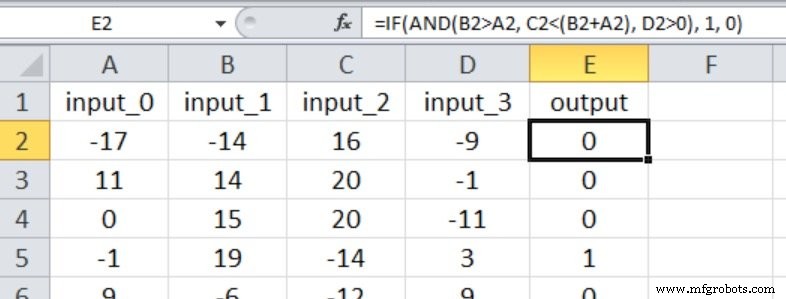
Start mit drei Hidden Nodes, Ergebnisse:
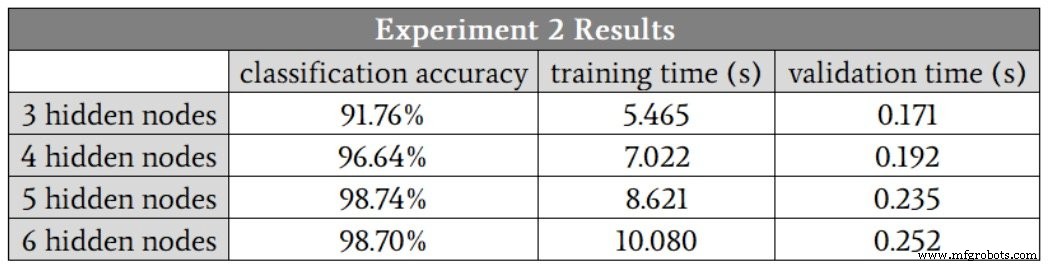
Hier scheinen fünf Hidden Nodes optimal, balancierend Genauigkeit und Geschwindigkeit. Im Gegensatz zu Experiment 1 zeigen Runs mit fünf und sechs Nodes keine Low-Accuracy-Ausreißer, was suggeriert, dass größere Hidden Layer Robustheit gegen Trainingsvarianz verleihen.
Experiment 3: Hochkomplexes Problem
Dieses Szenario führt Nichtlinearität ein: ein Input quadriert, ein anderer wurzelt:
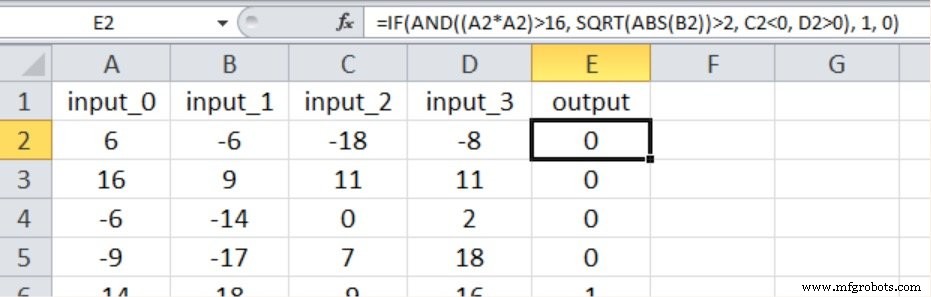
Ergebnisse:
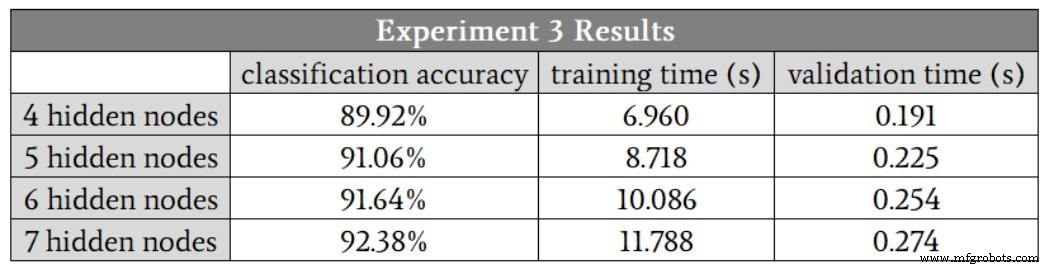
Genauigkeit fällt im Vergleich zu niedrigerkomplexen Tasks, selbst mit sieben Hidden Nodes. Erweiterungen wie Bias-Term oder Lernraten-Annealing könnten Performance verbessern, aber bis solche Änderungen validiert sind, wird ein sieben-Node Hidden Layer empfohlen.
Fazit
Diese Experimente illustrieren einen klaren Trade-off: Erhöhung der Hidden-Layer-Dimensionalität boostet generell Genauigkeit und Stabilität, kostet aber längere Trainingszeiten. Nutzen Sie die datengestützten Erkenntnisse hier, um Designentscheidungen beim Bau Perzeptron-basierter Klassifikatoren zu informieren.
Industrieroboter
- Die richtige Anzahl Hidden Layers und Nodes im Neuronalen Netz wählen
- Neuronale Netze mit Excel trainieren: Python Multilayer Perzeptron bauen & validieren
- Multilayer Perzeptron Neuronales Netz in Python bauen: Praktischer Leitfaden
- Flexibles Perzeptron Neuronales Netz in Python designen
- Multilayer Perzeptron trainieren: Bewährte Strategien für optimale Performance
- Wie vernetzte Netzwerke die moderne Landwirtschaft revolutionieren
- IoT von Hardware bis Applikation sichern: Ein Layer-für-Layer-Blaupause
- Thomas WebTrax vs. Google Analytics & Thomas Network: Welches Tool treibt Ihre industriellen Leads an?
- Wie 0G-Netzwerk-Sensoren Impfstoff-Kühlketten schützen
- Das ideale Laserschneidsystem wählen: Produktivität & Genauigkeit steigern