



Die richtige Anzahl Hidden Layers und Nodes im Neuronalen Netz wählen
Dieser Artikel bietet evidenzbasierte Leitlinien für die Konfiguration des Hidden-Anteils eines Multilayer Perzeptrons.
In vorherigen Posts dieser Serie behandelten wir Perzeptron-Netze, Multilayer-Architekturen und praktische Python-Implementationen. Bevor Sie über Tiefe und Breite Ihrer Hidden Layer entscheiden, möchten Sie vielleicht die grundlegenden Artikel unten reviewen.
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
- Die richtige Anzahl Hidden Layers und Nodes in einem Neuronalen Netz wählen
Hidden-Layer Recap
Lassen Sie uns Schlüsselpunkte zu Hidden Nodes reviewen:
- Single-Layer Perzeptrons – Netze, die nur Input- und Output-Nodes enthalten – sind auf linear trennbare Probleme beschränkt. Sie können komplexe Beziehungen wie die boolesche XOR-Funktion nicht modellieren.
- Ein Hidden Layer transformiert den Perzeptron in einen universellen Approximator, der praktisch jede stetige Abbildung zwischen endlichen Input- und Output-Räumen lernen kann.
- Hidden-to-Output-Gewichte beeinflussen den finalen Fehler indirekt, was Training komplexer macht.
- Backpropagation ist die Standard-Trainingsmethode: Der Fehler wird rückwärts durch das Netzwerk propagiert, was Updates aller Nicht-Output-Gewichte ermöglicht, unabhängig von der Anzahl der Hidden Layer.
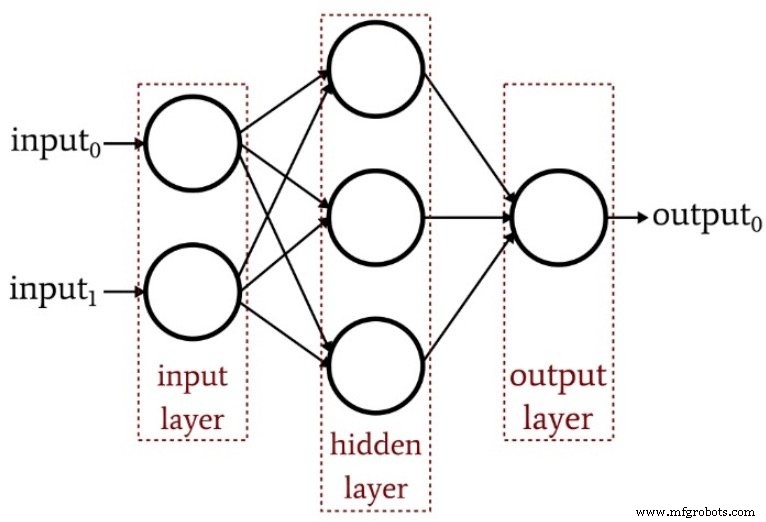
Das Diagramm unten illustriert die Grundstruktur eines Multilayer Perzeptrons.
Wie viele Hidden Layers?
Es gibt keine Einheitslösung. Ein einzelner Hidden Layer verleiht einem Netzwerk jedoch bereits bemerkenswerte Ausdruckskraft. Wenn Performance unzureichend ist, erwägen Sie Lernrate-Tuning, Verlängerung der Trainings-Epochen oder Anreicherung des Trainingsets, bevor Sie Tiefe hinzufügen.
Ein zweiter Hidden Layer erhöht Code-Komplexität und Inferenzzeit und kann Overfitting verschärfen – besonders bei begrenztem Trainingsdaten.
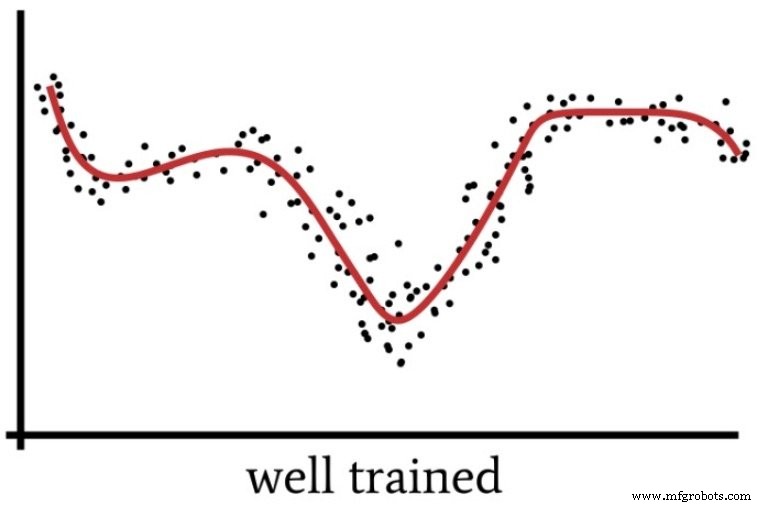
Overfitting tritt auf, wenn das Netzwerk Eigenheiten des Trainingsets auswendig lernt, statt eine verallgemeinerbare Abbildung zu lernen. Das folgende Diagramm visualisiert dieses Phänomen.
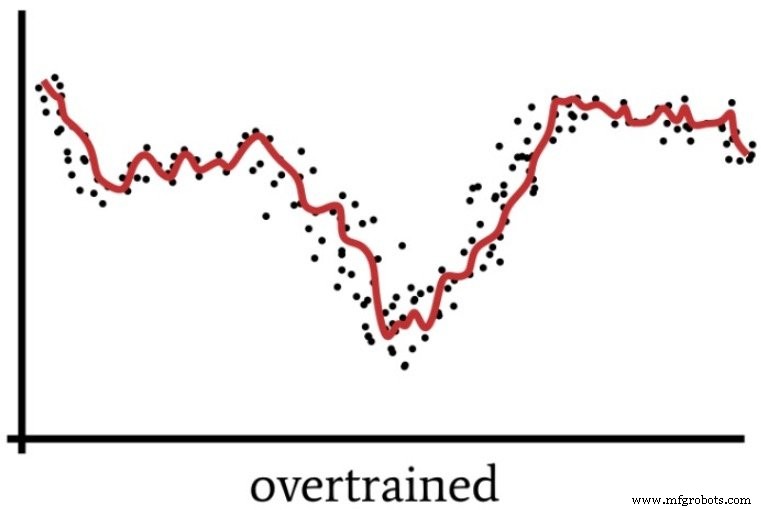
Ein hochparametrisiertes Netzwerk kann ein Problem „überdenken“ und eine Lösung produzieren, die auf Trainingsdaten gut performt, aber auf unbekannten Samples schlecht. Die nachfolgende Abbildung zeigt, wie übermäßige Kapazität Generalisierung behindern kann.
Wann ist ein zusätzlicher Hidden Layer gerechtfertigt? Dr. Jeff Heaton merkt in seinem umfassenden Buch zum Neuronalnetz-Training an, dass ein einzelner Hidden Layer jede stetige Funktion zwischen endlichen Räumen approximieren kann. Ein zweiter Layer erlaubt dem Netzwerk, Entscheidungsgrenzen mit beliebiger Genauigkeit darzustellen, aber nur, wenn die Problemkomplexität es wirklich erfordert.
Wie viele Hidden Nodes?
Die richtige Anzahl Nodes pro Hidden Layer balanciert Ausdruckskraft und Overfitting-Risiko. Während Experimentieren essenziell ist, liefert Dr. Heaton drei praktische Heuristiken (S. 159) als soliden Startpunkt. Basierend auf Signalverarbeitungserfahrung schlage ich folgende Richtlinien vor:
- Bei einzelnen Output-Node und relativ simpler Abbildung: Hidden-Dimensionalität auf zwei Drittel der Input-Dimensionalität setzen.
- Bei mehreren Outputs oder komplexer Beziehung: Hidden-Größe gleich Summe aus Input- und Output-Dimensionalität – aber unter dem Doppelten der Input-Größe halten.
- Bei extrem komplexen Abbildungen: Hidden-Größe auf eins weniger als das Doppelte der Input-Dimensionalität setzen.
Fazit
Durch Befolgen dieser Prinzipien können Sie Hidden Layer eines Multilayer Perzeptrons systematisch konfigurieren und verfeinern für robuste Performance. Im nächsten Artikel demonstrieren wir, wie diese Regeln in konkreten Python-Code übersetzt werden und evaluieren ihren Impact auf reale Datensätze.
Industrieroboter
- Was ist eine Kniehebelpresse? Funktionsweise und Bedeutung
- Funktionsweise von Zahnstangenpressen (Rack and Pinion Presses): Praxishandbuch
- Transfer Molding erklärt: Prozess, Vorteile und Varianten
- Fahrzeuggetriebe verstehen: Typen, Funktionen und Funktionsweise
- Bias-Nodes zu einem Multilayer Perzeptron in Python hinzufügen
- Hidden Layer Größe optimieren für höhere Neuronale Netzwerk Genauigkeit
- Neuronale Netze mit Excel trainieren: Python Multilayer Perzeptron bauen & validieren
- Multilayer Perzeptron Neuronales Netz in Python bauen: Praktischer Leitfaden
- Industriekupplungen: Definition, Funktion & Anwendungsbereiche
- So ermitteln Sie die benötigte Leistung für Ihre Hydraulikpumpe