



Multilayer Perzeptron Neuronales Netz in Python bauen: Praktischer Leitfaden
Dieser Artikel führt Sie durch ein Python-Programm, das ein Neuronales Netz für fortgeschrittene Klassifikation trainiert.
Dies ist der 12. Eintrag in AAC's Neuronalnetz-Entwicklungsserie. Sehen Sie unten, was die Serie sonst noch bietet:
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
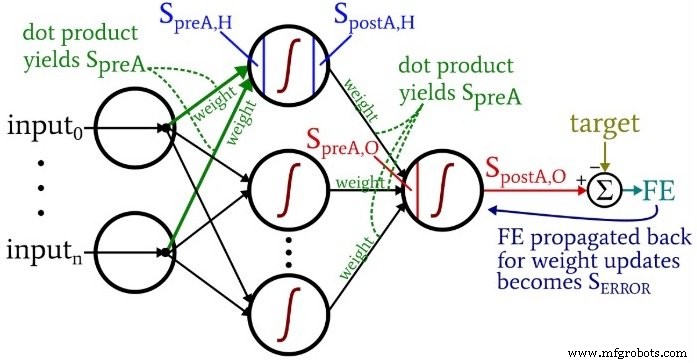
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
In diesem Artikel bauen wir auf unserer Arbeit mit einfachen Perzeptron-Netzen auf und erweitern sie zu einem voll funktionsfähigen Multilayer Perzeptron (MLP) in Python.
Verständlichen Python-Code für Neuronale Netze entwickeln
Nach Review zahlreicher Online-Ressourcen fand ich, dass viele Implementationen entweder überkomplex sind oder Klarheit vermissen. Mein Ziel war ein Programm, das sowohl lehrreich als auch intuitiv ist, sodass Leser sehen, wie Theorie in Code übersetzt wird.
Während dieses Skript Lesbarkeit über rohe Performance priorisiert, bleibt es eine solide Basis für Experimente. Echte Anwendungen verlangen oft optimierten Code für große Datensätze, aber für Lernen und kleine Projekte ist Klarheit wertvoller.
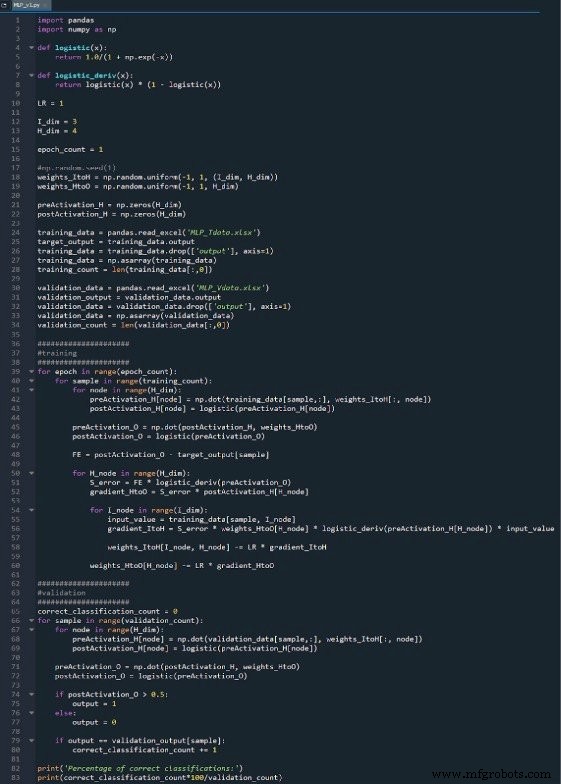
Der vollständige Python Source ist als Bild unten verfügbar und kann als MLP_v1.py heruntergeladen werden. Der Code führt Training und Validierung durch, wobei dieser Post sich auf den Trainingsprozess fokussiert.
Funktionen und Variablen vorbereiten
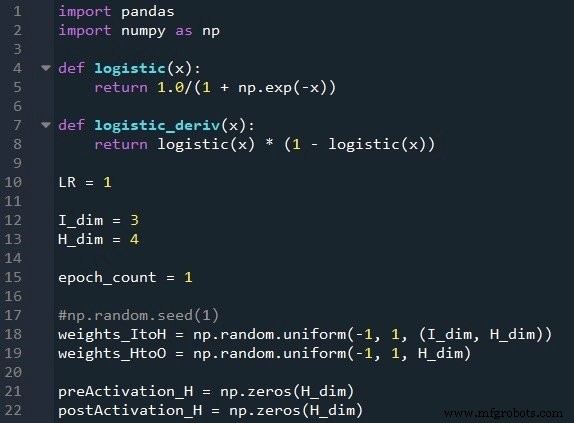
Die NumPy Library handhabt alle numerischen Operationen, während Pandas einfachen Import von Trainingsdaten aus Excel ermöglicht. Wir nutzen die logistische Sigmoid-Funktion für Aktivierung und ihre Ableitung für Backpropagation. Lernrate, Input-Dimensionalität, Hidden-Layer-Größe und Epochenanzahl werden hier gesetzt. Zufällige Initialgewichte werden mit np.random.uniform(-1, 1) generiert, ein fixer Seed sichert Reproduzierbarkeit. Leere Arrays für Hidden Pre- und Post-Aktivationswerte werden ebenfalls initialisiert.
Trainingsdaten importieren
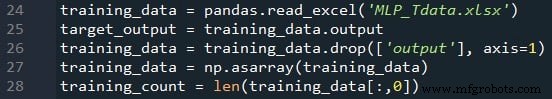
Folgend dem Verfahren aus Teil 4 lesen wir den Datensatz aus Excel, trennen die Target-Spalte, entfernen sie aus der Feature-Matrix, konvertieren die verbleibenden Daten zu NumPy Array und speichern die Sample-Anzahl in training_count.
Feedforward Processing
Die Feedforward-Phase berechnet den Netzwerk-Output durch Propagation der Inputs durch den Hidden Layer zum Output-Node. Der folgende Code demonstriert den Multi-Epoch-Loop, Per-Sample-Berechnungen, Hidden-Layer Pre-Aktivierung und Aktivierung, und finale Output-Berechnung.
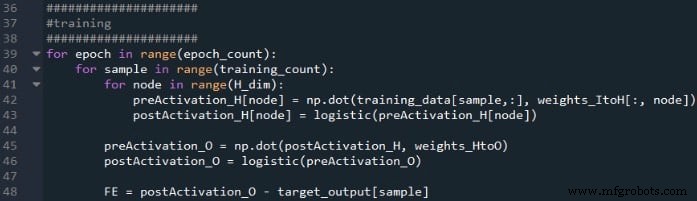
In jedem Epoch iterieren wir über alle Samples. Für jedes Sample berechnen wir Hidden Node Aktivierungen via Dot Products, wenden Sigmoid an, dann berechnen wir Output-Node Pre- und Post-Aktivierung. Der Fehler ist die Differenz zwischen Target und Output.
Backpropagation
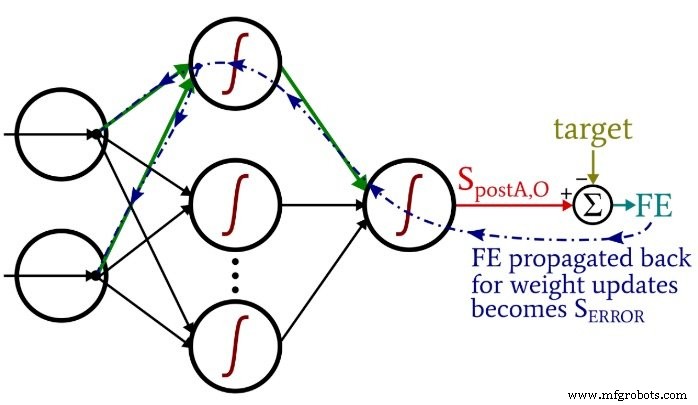
Nach Feedforward justiert Backpropagation Gewichte in umgekehrter Reihenfolge, propagiert Fehlersignale vom Output zurück durch den Hidden Layer. Das folgende Bild illustriert die verschachtelten Loops und Weight Updates.
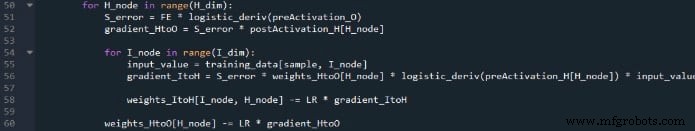
Zuerst berechnen wir den Output-Fehlerterm S_ERROR, dann aktualisieren wir Hidden-to-Output Gewichte. Anschließend berechnen wir für jeden Hidden Node dessen Beitrag zu Input-to-Hidden Weight Updates unter Nutzung des aktuellen Hidden-to-Output Gewichts. Diese Reihenfolge bewahrt korrekte Gradient-Berechnungen.
Fazit
Dieses prägnante Skript kapselt die Kernprinzipien eines MLP: Dateneingabe, Forward Propagation, Fehlerberechnung und Gewichtsanpassung via Backpropagation. Ich hoffe, es dient als klare Brücke zwischen Neuronalnetz-Theorie und praktischer Implementation.
Unten der vollständige Code als Referenz:
Code herunterladen
Industrieroboter
- Ihr erstes AWS CloudFormation Template erstellen – Ein praktischer Leitfaden
- Cloud Center of Excellence aufbauen: Strategien für erfolgreiche Migration und Customer Success
- Reibungslose Nutzererfahrungen schaffen: Ein UX-Design-Blaupause
- String-Listen in VHDL erstellen: Best Practices & Beispiel
- Selbstprüfenden VHDL-Testbench erstellen – Praxisleitfaden
- Zuverlässigen Timer in VHDL bauen: Taktzyklen bis Stunden zählen
- Getakteten Prozess in VHDL erstellen: Praktischer Leitfaden
- Lokale Minima im neuronalen Netzwerk-Training: Mythos oder Realität?
- Array von Objekten in Java erstellen: Schritt-für-Schritt-Anleitung
- Python Netzwerkprogrammierung: Sockets & erweiterte Protokolle meistern