



Hadoop verstehen: Leitfaden zur Big-Data-Verarbeitung
Was ist Hadoop?
Die Explosion von Big Data schuf neue Herausforderungen: Nie zuvor mussten Server so riesige Datenmengen in Echtzeit verarbeiten, sortieren und speichern. Apache Hadoop entstand als Open-Source-Framework, um genau diese Aufgabe in verteilter Rechenumgebung effizient zu lösen.
In diesem Artikel erfahren Sie, was Hadoop ist, welche Kernkomponenten es hat und wie es Big-Data-Verarbeitung ermöglicht.
Die vier Hauptmodule von Apache Hadoop
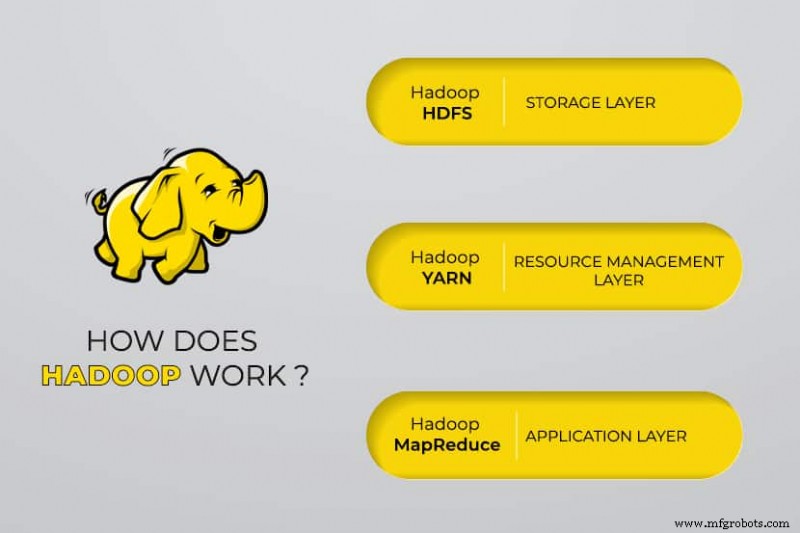
Hadoop Distributed File System (HDFS)
Daten liegen in HDFS, einem verteilten Dateisystem, das einem lokalen Dateisystem ähnelt, aber höheren Datendurchsatz bietet. HDFS skaliert hervorragend – von einer einzelnen Maschine auf Tausende, auf Commodity-Hardware.
Yet Another Resource Negotiator (YARN)
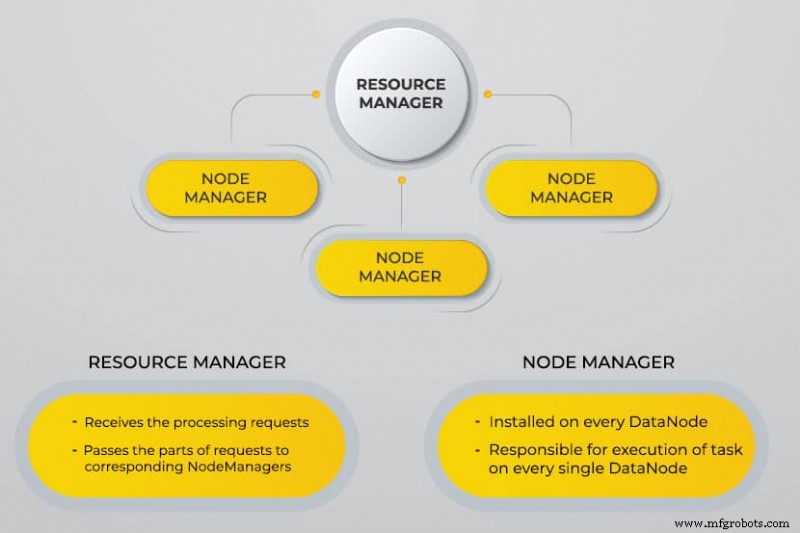
YARN plant Tasks, verwaltet und überwacht Cluster-Knoten und Ressourcen.
MapReduce
Das MapReduce-Modul ermöglicht parallele Datenberechnung. Der Map-Task wandelt Eingabedaten in Key-Value-Paare um; Reduce-Tasks aggregieren diese und liefern das Ergebnis.
Hadoop Common
Stellt standardisierte Java-Bibliotheken für alle Module bereit.
Warum wurde Hadoop entwickelt?
Das exponentielle Wachstum des WWW (Milliarden Seiten) machte effizientes Speichern und Verarbeiten unmöglich. Zwei Kernprobleme:
- Speicherung riesiger Datenmengen effizient und abrufbar
- Verarbeitung der gespeicherten Daten
Open-Source-Projekte verteilten Daten und Berechnungen auf Server-Cluster für simultane Verarbeitung. Hadoop löste diese Probleme und senkte zugleich Server-Deployment-Kosten.
Wie funktioniert Hadoop Big Data Processing?
Hadoop nutzt Speicher- und Verarbeitungskapazität von Clustern für verteiltes Processing. Es bildet das Fundament, auf dem weitere Applikationen zur Big-Data-Verarbeitung aufbauen.
Applikationen speichern Daten via Hadoop API im Cluster (NameNode). Der NameNode erfasst Verzeichnisstruktur und Platzierung von „Chunks“ je Datei. Hadoop repliziert diese Chunks auf DataNodes für parallele Verarbeitung.
MapReduce führt Datenabfragen durch: Map-Tasks laufen auf jedem Node für die Input-Files, Reducer verknüpfen und organisieren den finalen Output.
Hadoop Big Data Tools (Ökosystem)
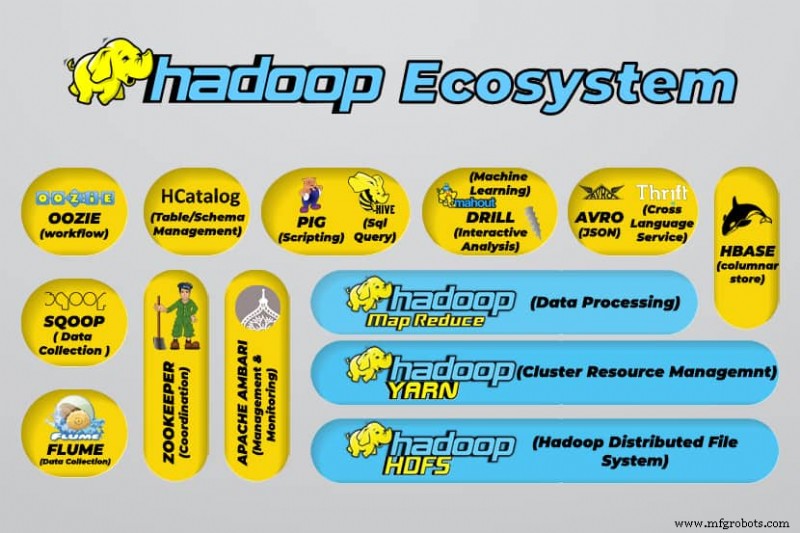
Das Hadoop-Ökosystem umfasst zahlreiche Open-Source-Tools, die Kernkomponenten ergänzen:
- Apache Hive – Data Warehouse für große Datensätze im HDFS
- Apache Zookeeper – Automatisiert Failover, reduziert Impact eines ausgefallenen NameNode
- Apache HBase – Open-Source NoSQL-Datenbank für Hadoop
- Apache Flume – Verteilter Service für Streaming großer Log-Datenmengen
- Apache Sqoop – CLI-Tool für Datentransfer zwischen Hadoop und relationalen DBs
- Apache Pig – Entwicklungsplattform für Hadoop-Jobs (Sprache: Pig Latin)
- Apache Oozie – Scheduling-System für Hadoop-Job-Management
- Apache HCatalog – Speicher- und Tabellenmanagement für Daten verschiedener Processing-Tools
Vorteile von Hadoop
- Schnelleres Speichern & Verarbeiten riesiger Datenmengen – Kritisch für Social Media, IoT
- Flexibilität – Unstrukturierte Daten (Text, Bilder, Video) ohne Preprocessing speicherbar; verhält sich wie NoSQL-DB
- Verarbeitungsleistung – Verteiltes Computing-Modell macht es schnell & effizient
- Kostensenkung – Open Source, kostenlos, nutzt günstige Commodity-Hardware
- Skalierbarkeit – Einfaches Hinzufügen von Nodes ohne großen Admin-Aufwand
- Fehlertoleranz – Redundante Datenkopien im Cluster; bei Geräteausfall automatische Task-Umleitung; High Availability auf Software-Ebene
Die drei Hauptanwendungsfälle
Big Data verarbeiten
Empfohlen für Petabyte-Bereich. Weniger geeignet für wenige hundert Gigabyte.
Vielfältige Datentypen speichern
Text, Bilder, Video – Hadoop speichert alles effizient. Charakteristika eines Data Lakes: Flexibilität bei der späteren Verarbeitung.
Parallele Datenverarbeitung
MapReduce orchestriert paralleles Processing unabhängiger Daten. Gemeinsame Operationen sind nicht vorgesehen.
Praxisbeispiele: Wofür wird Hadoop real eingesetzt?
- Kundenbedürfnisse verstehen – Finanzbranche, Social Media analysieren Nutzeraktivitäten für personalisierte Angebote (z. B. gezielte Werbung)
- Geschäftsprozesse optimieren – Transaktions- & Kundendatenanalyse, Trend- & Predictive Analytics für Sortiments- & Lageroptimierung; Mitarbeiterverhalten monitoren
- Gesundheitswesen verbessern – Medizinische Daten & Behandlungsergebnisse analysieren für Früherkennung, Medikamentenvorhersage, Therapieplanung
- Finanzhandel – Algorithmen scannen Marktdaten für Trading-Chancen & Saisonalitäten; Automatisierung
- IoT-Datenmanagement – Milliarden Transaktionen von IoT-Geräten; Hadoop als Data Warehouse; kontinuierliche Updates für IoT-Plattformen
Weitere Einsatzgebiete: Geräte-Performance, Personal Quantification, Sport- & Wissenschaftsforschung.
Herausforderungen bei Hadoop
- MapReduce nicht universell – Geeignet für einfache, unabhängige Tasks; ineffizient bei iterativen Algorithmen (intensive Interkommunikation, viele Zwischenfiles)
- Unvollständiges Data Management – Fehlende Tools für Metadaten, Governance, Standardisierung, Datenqualität
- Fachkräftemangel – Steile Lernkurve; Java/MapReduce-Experten selten. Daher SQL-on-Hadoop (z. B. Hive) beliebt. Administration erfordert OS-, Hardware- & Kernel-Kenntnisse
- Datensicherheit – Kerberos-Authentisierung wichtiger Schritt; fragmentierte Security bleibt Risiko
Fazit
Hadoop ist hochwirksam bei Big-Data-Verarbeitung, wenn Herausforderungen adressiert werden. Vielseitiges Tool für datenintensive Unternehmen. Hauptvorteil: Läuft auf beliebiger Hardware, Cluster über Tausende Server verteilsbar – ideal für Infrastructure-as-Code-Umgebungen.
Cloud Computing
- Big Data mit Cloud Computing nutzen: Ein strategischer Vorteil
- Cloud Security verstehen: Warum Ihr Business es braucht
- Big Data und Cloud Computing: Wie sie zusammenarbeiten
- Big Data & Cloud Computing nutzen, um Business Growth zu treiben
- Aufkommende Trends bei IoT-Plattformen 2018: Edge Computing, Blockchain und mehr
- Predictive Maintenance: Effizienz und Risikoreduktion durch datengetriebene Einblicke
- DDR5 RAM erklärt: Features, Vorteile und Verfügbarkeit
- Industrial Internet of Things (IIoT): Definition, Umfang und industrielle Auswirkungen
- Big Data vs. KI: Synergie hinter der digitalen Transformation
- Kleine Daten in große Dateneinblicke für die Fertigung transformieren