



IBMs neuer Low-Precision KI-Chip erreicht 25,6 TFLOPS Training & 102,4 TOPS Inferenz
Auf der ISSCC 2024 enthüllte IBM Research einen 7 nm Prototyp, der jahrelange Arbeit an Low-Precision KI-Training und Inferenz verkörpert. Der Chip liefert 16-Bit und 8-Bit Training sowie 4-Bit und 2-Bit Inferenz – weit unter der Industriennorm von 32-Bit Training / 8-Bit Inferenz.
Die Senkung numerischer Präzision schneidet Compute- und Power-Anforderungen, aber IBM führte auch mehrere architektonische Optimierungen ein, die Effizienz weiter steigern. Die Kernherausforderung ist, Präzision zu reduzieren ohne Accuracy zu schädigen – ein Problem, das IBM seit Jahren auf algorithmischer Ebene angeht.
IBMs AI Hardware Center, gestartet 2019, zielt darauf ab, KI-Compute-Performance jährlich um 2,5× zu steigern, mit Ziel einer 1.000× Verbesserung in FLOPS/W bis 2029. Solch ehrgeizige Ziele werden getrieben vom explosiven Wachstum von KI-Modellen – besonders Trillion-Parameter NLP Systemen – und dem wachsenden CO2-Fußabdruck ihres Trainings.
Auf dem Prototyp erreicht der 4-Kern-Chip 25,6 TFLOPS für 8-Bit Training, während er 102,4 TOPS für 4-Bit Integer Inferenz liefert (beide gemessen bei 1,6 GHz und 0,75 V). Das Absenken des Takts auf 1 GHz und der Spannung auf 0,55 V verbessert Energieeffizienz auf 3,5 TFLOPS/W (FP8) oder 16,5 TOPS/W (INT4).
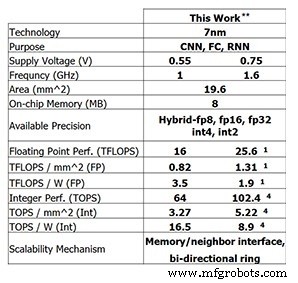
Performance von IBM Researchs Test Chip (Bild: IBM Research) **Berichtete Performance bei 0% Sparsity. (1) FP8. (4) INT4.
Low-Precision Training
Diese Performance baut auf jahrelanger algorithmischer Arbeit an Low-Precision Training und Inferenz-Techniken auf. Der Chip ist der erste, der IBMs Hybrid FP8 Format unterstützt, eingeführt auf NeurIPS 2019, das 8-Bit Training ermöglicht, während es den Compute von 16-Bit Training halbiert, ohne Ergebnisse zu kompromittieren.
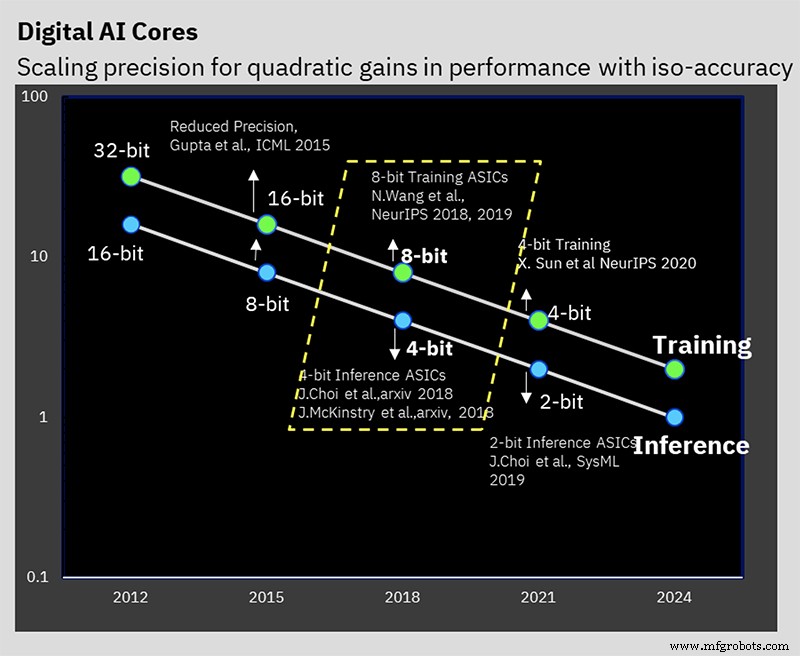
IBM Research arbeitet an der Lösung des Problems, Accuracy bei Reduzierung der Präzision zu erhalten (Bild: IBM)
„Low-Precision Training ist herausfordernd, aber 8-Bit Training ist mit den richtigen Zahlenformaten erreichbar“, sagte Kailash Gopalakrishnan, IBM Fellow und Senior Manager für Accelerator Architectures und Machine Learning. „Die richtigen numerischen Formate, angewendet auf die korrekten Tensoren, sind kritisch.“
Hybrid FP8 kombiniert zwei Formate: eines für Weights und Activations im Forward Pass, und ein anderes für Gradients im Backward Pass. Training erfordert beide Pässe, während Inferenz nur das Forward Format nutzt.
„Wir fanden, dass Forward Tensore höhere Fidelität brauchen – mehr Präzision in der Mantisse – während Gradients einen breiteren Dynamikbereich mit größerem Exponenten verlangen. Dieser Trade-off führte zum 1-4-3 (Sign-Exponent-Mantisse) Split für Forward und einem 5-Bit Exponenten für Backward, was einen Dynamikbereich von 232 gibt. Unsere Hardware unterstützt nun beide Varianten.“
Hierarchische Akkumulation
IBMs „Hierarchical Accumulation“ Technik reduziert Präzision während Akkumulation neben Weights und Activations. Traditionelles FP16 Training akkumuliert in 32-Bit Arithmetik um Accuracy zu bewahren, aber das 8-Bit Schema akkumuliert in FP16. Durch Gruppieren langer Akkumulationen in kleinere Chunks und Summieren dieser minimiert der Chip Rundungsfehler ohne die Vorteile niedrigerer Präzision zu opfern.
„Tausende Zahlen sequenziell zu addieren kann Präzision degradieren“, erklärte Gopalakrishnan. „Chunking der Akkumulation hält die Summe akkurat während die Hardware lean bleibt.“
Low-Precision Inferenz
Während die meisten Inferenz-Engines INT8 nutzen, demonstrierte IBM, dass 4-Bit Integer Arithmetik State-of-the-Art Accuracy matchen kann. Nach Quantisierung reduziert ein Quantization-Aware Training Schritt den Accuracy-Loss auf unter 0,5 %, was für viele Anwendungen akzeptabel ist.
On-Chip Ring
Der Chip inkorporiert ein Network-on-Chip, optimiert für Deep Learning, das es Kernen ermöglicht, Daten effizient zu multicasten. Dies reduziert Off-Chip Memory Traffic und Bandbreitenanforderungen.
„Wir entkoppelten die Ring-Operating-Frequenz von den Kernen, was unabhängige Optimierung und höhere Kerngeschwindigkeiten ohne Long-Wire-Latenz des Rings erlaubt“, sagte Ankur Agrawal, Research Staff Member in Machine Learning und Accelerator Architectures.
Power Management
IBM führte ein Frequency-Scaling Schema ein, das den Chip nah an seinem Power Envelope hält throughout die Workload. Durch aggressives Setzen der initialen Spannung und Frequenz hält der Chip hohe Performance während Compute-intensiver Phasen und adaptet an niedrigere Demand ohne kostspielige Spannungsänderungen.
„Deep Learning Workloads haben distinkte Power Peaks und Troughs“, merkte Agrawal an. „Unsere Strategie hält Powerverbrauch stabil, wandelt Dips in Performance-Gewinne um.“
Test Chip
Das 4-Kern-Design balanciert Connectivity-Komplexität mit Kern-Größe und bietet eine skalierbare Architektur. IBM sieht 1-2 Kern Chips für Edge Devices und 32-64 Kern Chips für Data-Center Deployments vor, alle fähig für FP16, Hybrid FP8, INT4 und INT2.
„Verschiedene Applikationsdomänen verlangen unterschiedliche Präzisions- und Energie-Trade-offs“, sagte Gopalakrishnan. „Unser Schweizer Taschenmesser an Formaten lässt uns jeden Use Case targeten ohne Effizienz zu kompromittieren.“
Ergänzend zur Hardware veröffentlichte IBM Research den „Deep Tools“ Compiler Stack, der 60-90 % Utilization auf dem Chip erreicht.
Laut einem früheren Interview sollten Low-Precision KI-Chips basierend auf dieser Architektur innerhalb von zwei Jahren den Markt erreichen.
>> Dieser Artikel wurde ursprünglich auf unserer Schwesterseite EE Times veröffentlicht.
Verwandte Inhalte:
- KI-Chips bewahren Accuracy bei Model Reduction
- Training KI-Modelle am Edge
- Das Rennen um KI am Edge
- Edge AI fordert Memory-Technologie heraus
- Engineering Group strebt 1mW KI am Edge an
- Neuronale Netze Anwendung für kleine Aufgaben
- KI IC Research erforscht alternative Architekturen
Für mehr Embedded, abonnieren Sie Embeddeds wöchentlichen E-Mail-Newsletter.
Eingebettet
- Bluetooth Mesh Design Entscheidungen: Module vs. Diskrete Devices
- MIT-Durchbruch: 1,6 mm² Kryptografischer ID-Chip bekämpft Fälschung mit Terahertz-Backscatter
- Wartung bei Personalabbau managen: Strategisches Outsourcing & Continuous Monitoring
- Rockwell Automation partnerschaftlich mit ATCC zur Ausweitung von Automatisierungstraining in Zentral-Minnesota
- Forscher decken BrakTooth auf: 16 Bluetooth-Classic-Schwachstellen gefährden 1.400+ ESP32-Geräte
- Wie IBM Watson KI-Innovationen branchenübergreifend vorantreibt
- Marketing-ROI mit Agentur-Präzision steigern
- Marketing-ROI mit Agentur-Präzision steigern
- IBM: Anlagenverfügbarkeit und Sicherheit durch proaktive EAM-Lösungen steigern
- Präzisionsbearbeitung: Bau überlegener Hydrauliksysteme für Fertigung & Bauwesen