



Basic Perzeptron Neuronales Netz mit Python trainieren: Schritt-für-Schritt Anleitung
Basic Perzeptron Neuronales Netz mit Python trainieren
Dieser Guide führt Sie durch eine vollständig kommentierte Python-Implementation, die automatisch Gewichte für einen Single-Layer Perzeptron lernt. Der Code ist bereit zum Kopieren, Ausführen und Anpassen an Ihre eigenen Daten.
AAC Perzeptron Serie erkunden
Für tieferen Kontext oder um in fortgeschrittene Themen einzusteigen, checken Sie den Rest unserer Artikel:
- Klassifikation mit neuronalen Netzen: Was ist der Perzeptron?
- Einfaches Perzeptron-Beispiel zur Datenklassifikation nutzen
- Einen Basic Perzeptron trainieren
- Einfaches Neuronales Netzwerk Training verstehen
- Einführung in Trainings-Theorie für Neuronale Netze
- Lernrate in Neuronalen Netzen verstehen
- Advanced Machine Learning mit dem Multilayer Perzeptron
- Die Sigmoid-Aktivierungsfunktion: Aktivierung in Multilayer Perzeptronen
- Einen Multilayer Perzeptron trainieren
- Trainingsformeln und Backpropagation für Multilayer Perzeptronen verstehen
- Neuronales Netzwerk-Architektur für Python-Implementation
- Einen Multilayer Perzeptron in Python erstellen
- Signalverarbeitung mit Neuronalen Netzen: Validierung im Neuronalnetz-Design
- Trainingsdaten für Neuronale Netze: Training und Validierung eines Python Neuronalen Netzes
Klassifikation mit Single-Layer Perzeptron
Wir beginnen mit einem klassischen binären Klassifikationsproblem im 3D-Raum. Die Netzwerkarchitektur ist ein einzelner Hidden Layer mit drei Input-Nodes und einem Output-Node, der eine Unit-Step-Aktivierungsfunktion nutzt.
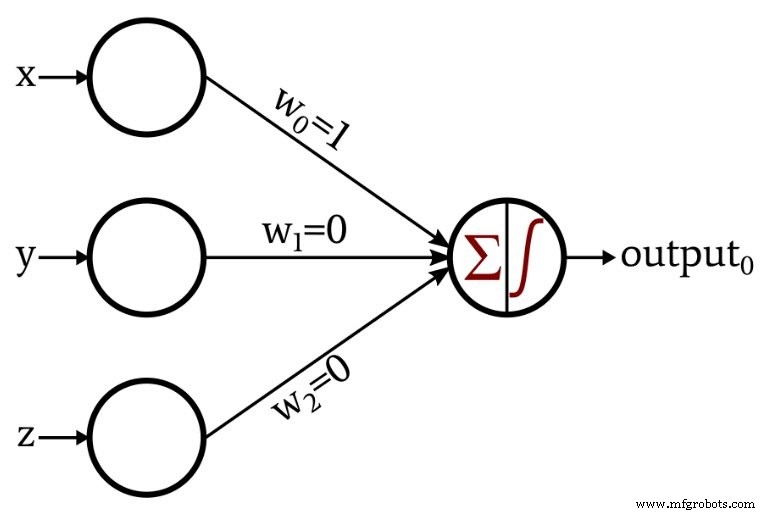
Der Output-Node wendet folgende Unit-Step-Funktion an:
\[f(x)=\begin{cases}0 & x < 0\\1 & x \ge 0\end{cases}\]
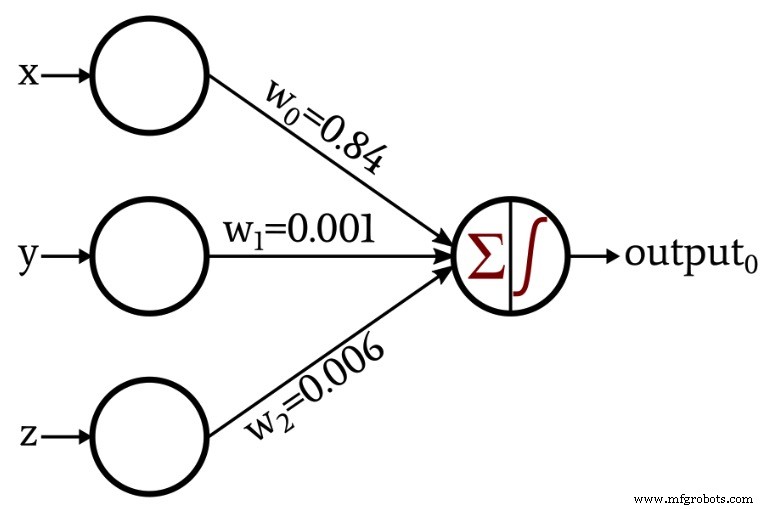
Um Lernen zu illustrieren, erweitern wir die Architektur, um Gewichte automatisch via einfachem Trainingsloop anzupassen:
Python Implementation
Das folgende Skript liest Trainingsdaten aus einer Excel-Datei, initialisiert Gewichte zufällig und aktualisiert sie iterativ per Perzeptron-Lernregel.
 import pandas
import numpy as np
# Dimensionalität des Input-Raums (x, y, z)
input_dim = 3
# Lernrate kontrolliert Gewichtsanpassungsmagnitude
learning_rate = 0.01
# Zufällige Initialgewichte; für Reproduzierbarkeit fixe Werte setzen
Weights = np.random.rand(input_dim)
# Weights = np.array([0.5, 0.5, 0.5])
# Datensatz laden: Sheet mit Spalten für jedes Feature und 'output' Spalte
Training_Data = pandas.read_excel("3D_data.xlsx")
# Erwartete Outputs von Feature-Matrix trennen
Expected_Output = Training_Data.output
Training_Data = Training_Data.drop(["output"], axis=1)
# Zu NumPy Array für vektorisierte Operationen konvertieren
Training_Data = np.asarray(Training_Data)
training_count = len(Training_Data[:, 0])
# Über mehrere Epochen trainieren
for epoch in range(5):
    for datum in range(training_count):
        # Gewichtete Summe der Inputs
        Output_Sum = np.sum(np.multiply(Training_Data[datum, :], Weights))
        # Unit-Step Aktivierung anwenden
        Output_Value = 0 if Output_Sum < 0 else 1
        # Fehler zwischen erwartetem und tatsächlichem Output berechnen
        error = Expected_Output[datum] - Output_Value
        # Jedes Gewicht per Lernregel aktualisieren
        for n in range(input_dim):
            Weights[n] += learning_rate * error * Training_Data[datum, n]
print(f"w_0 = {Weights[0]:.3f}")
print(f"w_1 = {Weights[1]:.3f}")
print(f"w_2 = {Weights[2]:.3f}")
Kernkonzepte erklärt
Netzwerk konfigurieren und Daten organisieren
Das Netzwerk hat drei Input-Nodes passend zu 3D-Koordinaten. Lernrate 0,01 ist ein Standard-Startpunkt; nach Experimentieren anpassbar. Gewichte werden zufällig geseedet, um Symmetrie zu vermeiden, aber Sie können sie auf fixe Werte setzen für deterministisches Verhalten.
Trainingsdaten werden aus Excel gelesen, in Inputs und erwartete Outputs geteilt, dann zu NumPy Array konvertiert für effiziente Computation.
Output-Werte berechnen
Jede Epoche iteriert über alle Trainingsamples. Für jedes Sample wird die gewichtete Summe der Inputs berechnet. Die Unit-Step Funktion mapt diese Summe auf binären Output: 0 wenn Summe negativ, 1 sonst.
Gewichte aktualisieren
Wenn vorhergesagter Output vom erwarteten abweicht, justiert die Perzeptron-Lernregel jedes Gewicht proportional zum Input-Wert, Fehler und Lernrate:
\[w_{new} = w + (\alpha \times \delta \times input)\]
wobei \(\delta = \text{output}_{expected} - \text{output}_{calculated}\) und \(\alpha\) die Lernrate ist.
Fazit
Sie haben nun eine vollständige, annotierte Implementation eines Single-Layer Perzeptrons in Python gesehen. Der Code ist eine solide Basis für Experimente mit verschiedenen Datensets, Lernraten oder sogar Erweiterung auf multiple Outputs in zukünftigen Projekten.
Eingebettet
- Intrusion Detection Systeme: Netzwerkschutz durch intelligente Alarme
- Automobil-Elektriker werden: Ausbildung, Aufgaben und Karriereaussichten
- Industrielle IoT-Geräte härten gegen Cyber-Angriffe
- Offline AI Model für Diabetische Retinopathie Stages Detection mit Edge Impulse bauen
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Raspberry Pi & HDC2010: Kompletter I2C Temperatur- & Feuchtigkeitssensor Setup-Guide
- Netzwerksicherheitsschlüssel finden & schützen: Einfache Schritte für Ihr WLAN
- 5 wesentliche Netzwerksicherheitsstrategien für kleine Unternehmen
- Sicherheit Ihres Shopfloor-Netzwerks: Sind Sie vorbereitet?
- Belegschaft von morgen auf Industrie 4.0 vorbereiten: Trainingsstrategien für die digitale Fabrik