



Deep-Learning-basiertes Vorhersagenetzwerk für Metamaterial-Design mit Spaltring-Resonatoren
Zusammenfassung
Die Einführung von "Metamaterialien" hatte einen tiefgreifenden Einfluss auf mehrere Bereiche, einschließlich Elektromagnetik. Das Design einer Metamaterialstruktur auf Anforderung ist jedoch immer noch ein extrem zeitaufwändiger Prozess. Als effiziente Machine-Learning-Methode wurde Deep Learning in den letzten Jahren weit für Datenklassifikation und Regression verwendet und hat in der Tat gute Generalisierungsleistung gezeigt. Wir haben ein tiefes neuronales Netzwerk für On-Demand-Design gebaut. Mit der erforderlichen Reflexion als Eingabe werden die Parameter der Struktur automatisch berechnet und dann ausgegeben, um den Zweck des On-Demand-Designs zu erreichen. Unser Netzwerk hat niedrige mittlere quadratische Fehler (MSE) erreicht, mit MSE von 0,005 sowohl auf dem Trainings- als auch auf dem Testset. Die Ergebnisse zeigen, dass durch Deep Learning das trainierte Modell die Strukturdesign genauer leiten kann, wodurch der Designprozess beschleunigt wird. Im Vergleich zum traditionellen Designprozess kann die Verwendung von Deep Learning zur Anleitung des Metamaterial-Designs schnellere, genauere und bequemere Zwecke erreichen.
Einleitung
Nano-Optik ist ein interdisziplinäres Fachgebiet der Nanotechnologie und Optik. In den letzten Jahren haben Wissenschaftler durch ständiges Entwerfen von Strukturen mit unterschiedlichen Subwellenlängengrößen, um spezielle Wechselwirkungen mit einfallendem Licht zu erreichen, erfolgreich bestimmte Transmissionsmerkmale von Licht manipuliert [1-3]. Seit Metamaterialien vorgeschlagen wurden, haben sie die Aufmerksamkeit vieler Wissenschaftler in diesem Bereich auf sich gezogen, und gleichzeitig schreiten ihre verwandten theoretischen Studien [4, 5], Prozesse [6, 7] und angewandte [8] Forschung alle mit gleicher Geschwindigkeit voran. Viele besondere Funktionen wurden realisiert, einschließlich holografischer Bildgebung, perfekter Absorption [9] und flacher Linsen [10]. Aufgrund der rasanten Entwicklung der Terahertz-Technologie und ihrer einzigartigen Eigenschaften ist sie auch zu einem beliebten Forschungsthema im Bereich der Metamaterialien in den letzten Jahren geworden [11-13].
Obwohl die Anwendung von Metamaterialien sehr breit ist, erfordert die traditionelle Designmethode, dass der Designer wiederholt komplexe numerische Berechnungen an der zu entwerfenden Struktur durchführt. Dieser Prozess verbraucht enorme Zeit und Rechenressourcen. Daher ist es dringend notwendig, neue Wege zu finden, um traditionelle Designmethoden zu vereinfachen oder sogar zu ersetzen.
Als interdisziplinäres Feld deckt Machine Learning viele Disziplinen ab, einschließlich Lebenswissenschaften, Informatik und Psychologie. Es arbeitet daran, Computer zu nutzen, um menschliche Lernprozesse zu imitieren und umzusetzen, um neues Wissen oder Fähigkeiten zu erwerben. Das Grundprinzip des Machine Learning kann einfach als die Verwendung von Computer-Algorithmen beschrieben werden, um die Korrelation unter einer großen Datenmenge zu erhalten oder Regeln unter ähnlichen Daten vorherzusagen und schließlich den Zweck der Klassifikation oder Regression zu erreichen. Bis jetzt wurden viele Machine-Learning-Algorithmen auf die Bezeichnung von Metamaterialien angewendet und haben signifikante Ergebnisse erzielt, einschließlich genetischer Algorithmen [14], linearer Regressionsalgorithmen [15] und flacher neuronaler Netze. Da die Struktur immer komplexer wird und die Änderungen in der Struktur vielfältiger werden, werden Probleme mehr Zeit zur Lösung benötigen. Gleichzeitig macht die hochgradig nichtlineare Natur der Probleme es für einfache Machine-Learning-Algorithmen schwierig, genaue Vorhersagen zu erhalten. Zusätzlich erfordert das Design einer passenden Metamaterialstruktur für einen spezifischen elektromagnetischen Effekt, dass Designer versuchen und komplexe numerische Berechnungen an der Struktur durchführen. Diese Prozesse werden eine enorme Menge an Zeit und Rechenressourcen verbrauchen.
Als einer der herausragendsten Algorithmen im Bereich Machine Learning hat Deep Learning weltberühmte Erfolge in verschiedenen verwandten Bereichen wie Computer Vision [16], Merkmalsextraktion [17] und natürlicher Sprachverarbeitung [18] erzielt. Gleichzeitig sind Erfolge in anderen nicht-computerbezogenen Bereichen zahlreich, einschließlich vieler Grundlagenwissenschaften wie Lebenswissenschaften, Chemie [19] und Physik [20, 21]. Daher ist die Anwendung von Deep Learning auf das Design von Metamaterialien auch derzeit eine heiße Forschungsrichtung, und viele herausragende Arbeiten sind erschienen [22-24].
Inspiriert durch Deep Learning berichtet diese Arbeit über eine Studie, die einen Machine-Learning-Algorithmus basierend auf einem tiefen neuronalen Netzwerk verwendet, um die Struktur des Spaltring-Resonators (SRR) vorherzusagen, um den Zweck des On-Demand-Designs zu erreichen. Zusätzlich werden das Vorwärtsnetzwerk und das Rückwärtsnetzwerk innovativ separat trainiert, was nicht nur die Genauigkeit des Netzwerks verbessern kann, sondern auch verschiedene Funktionen durch flexible Kombination erreichen kann. Die Ergebnisse zeigen, dass die Methode MSE von 0,0058 und 0,0055 auf dem Trainingsset und Validierungsset erreichen kann und gute Robustheit und Generalisierung aufweist. Mit dem trainierten Modell, das das Design von Metamaterialstrukturen leitet, kann der Designzyklus auf Tage oder sogar Stunden verkürzt werden, und die Effizienzverbesserung ist offensichtlich. Zusätzlich hat diese Methode auch gute Skalierbarkeit und muss nur die Trainingsdatensätze ändern, um verschiedene Eingaben oder verschiedene Strukturen auf Anforderung zu entwerfen.
Theorie und Methode
COMSOL-Modellbau
Um zu zeigen, dass Deep Learning auf das Reverse-Design von Metamaterialstrukturen angewendet werden kann, haben wir eine dreischichtige SRR-Struktur modelliert, die aus einem Goldring, einem Siliziumdioxid-Boden und einem Goldboden besteht, um ihre elektromagnetische Reaktion unter der Einwirkung von einfallendem Licht zu beobachten. Wie in Abb. 1 gezeigt, werden der Öffnungswinkel θ des Goldrings, der innere Radius r des Rings und die Linienstärke d des Rings als unabhängige Variablen dieser Struktur ausgewählt. Wenn ein Strahl linear polarisierten Lichts normal in die Metamaterialien eintritt, werden die Wellenlängen-Reflexionskurven unter verschiedenen Strukturen durch Ändern der strukturellen Variablen erhalten. Die Dicke des Au-Rings beträgt 30 nm, des SiO₂-Bodens 100 nm und des Au-Bodens 50 nm, und die Größe der Meta-Atome beträgt 200 nm mal 200 nm.
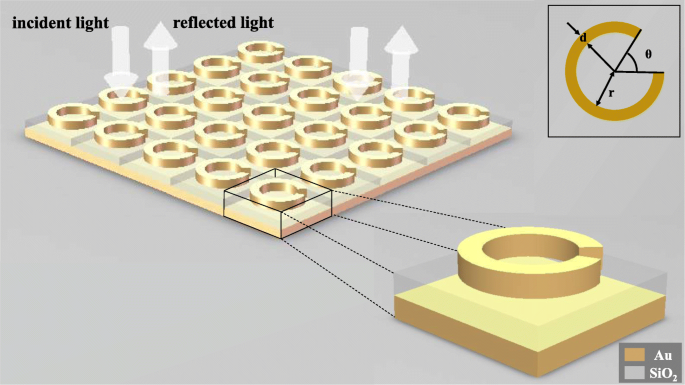
COMSOL Multiphysics 5.4 [25] wird für die Modellierung verwendet, dreidimensionale Raumdimension gewählt, Optik ≥ Wellenoptik ≥ elektromagnetische Wellenfrequenzbereich (ewfd) für das physikalische Feld ausgewählt und der Wellenlängenbereich für die Forschung gewählt. Das obige Modell wird in der Geometrie erstellt. Das Material jedes Teils und sein Brechungsindex werden der Reihe nach im Material definiert, und Ports und periodische Bedingungen werden im elektromagnetischen Wellenfrequenzbereich hinzugefügt.
Aufbau eines Deep-Learning-Neuronalen-Netzwerk-Modells
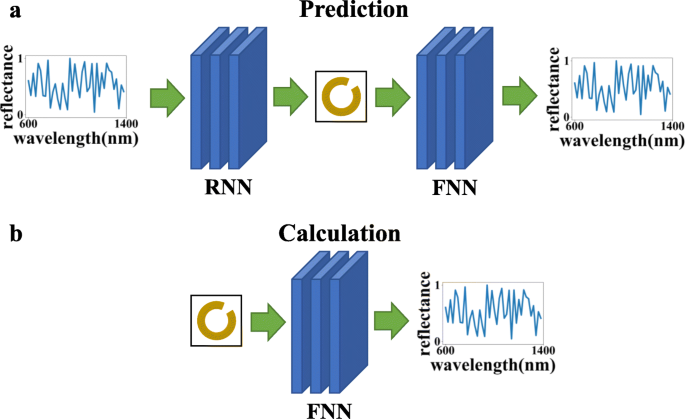
Wir haben ein Rückwärtsnetzwerk und ein Vorwärtsnetzwerk für die Metamaterialstruktur konstruiert. Das Rückwärtsnetzwerk kann die strukturellen Parameter des SRR aus den gegebenen zwei Sätzen von Wellenlängen-Reflexionskurven mit unterschiedlichen Polarisationsrichtungen vorhersagen. Das Vorwärtsnetzwerk kann die Wellenlängen-Reflexionskurven in zwei Polarisationsrichtungen durch die gegebenen strukturellen Parameter vorhersagen. Die Funktion des Rückwärtsnetzwerks ist der Hauptkörper der Vorhersagefunktion. Die Rolle des Vorwärtsnetzwerks ist es, die Vorhersageergebnisse des Rückwärtsnetzwerks zu verifizieren, um zu beobachten, ob die Vorhersageergebnisse die erforderliche elektromagnetische Reaktion erfüllen.
Eclipse 2019 wird als Entwicklungsplattform, Python 3.7 als Programmiersprache und TensorFlow 1.12.0 als Entwicklungsframework verwendet.
Die beiden Netzwerke werden separat trainiert, um die Trainingsergebnisse jedes Netzwerks davon abzuhalten, von dem Fehler des anderen Netzwerks beeinflusst zu werden, was dadurch die jeweilige Genauigkeit der beiden Netzwerke sicherstellt.
Wie in Abb. 2 gezeigt, ist ein weiterer Vorteil des separaten Trainings der beiden Netzwerke, dass sie für verschiedene Zwecke durch unterschiedliche Verbindungssequenzen verwendet werden können: (a) Rückwärtsnetzwerk + Vorwärtsnetzwerk, das die gegebenen Wellenlängen-Reflexionskurven verwenden kann, um die Strukturparameter zu berechnen, Vorhersagen zu machen und zu verifizieren, ob die Vorhersageergebnisse den Anforderungen entsprechen, und (b) die Verwendung des Vorwärtsnetzwerks allein kann den Berechnungsprozess der numerischen Berechnungsmethode vereinfachen und die Berechnungszeit reduzieren.
Es ist erwähnenswert, dass der Prozess der Eingabe und Erhaltung der Ergebnisse des trainierten Modells mit der Deep-Learning-Methode extrem wenig Zeit in Anspruch nimmt. Und wann immer neue Daten durch Simulation oder Experiment gewonnen werden, kann das Modell für weiteres Training verwendet werden. Studien haben gezeigt, dass mit der kontinuierlichen Zunahme von Trainingsdaten die Genauigkeit des Modells immer höher wird und die Generalisierungsleistung immer besser wird [26].
Die Parameter der Struktur sind mehrere Sätze kontinuierlicher Eigenwerte, die zum Regressionsproblem gehören. In den letzten Jahren waren vollständig verbundene Netzwerke der Fokus von Deep-Learning-Netzwerken bei Regressionsproblemen und zeigten die Merkmale hoher Zuverlässigkeit, großem Datendurchsatz und niedriger Latenz. Einige Anpassungen an einem vollständig verbundenen Netzwerk ermöglichen es dem Netzwerk, die Struktur besser vorherzusagen.
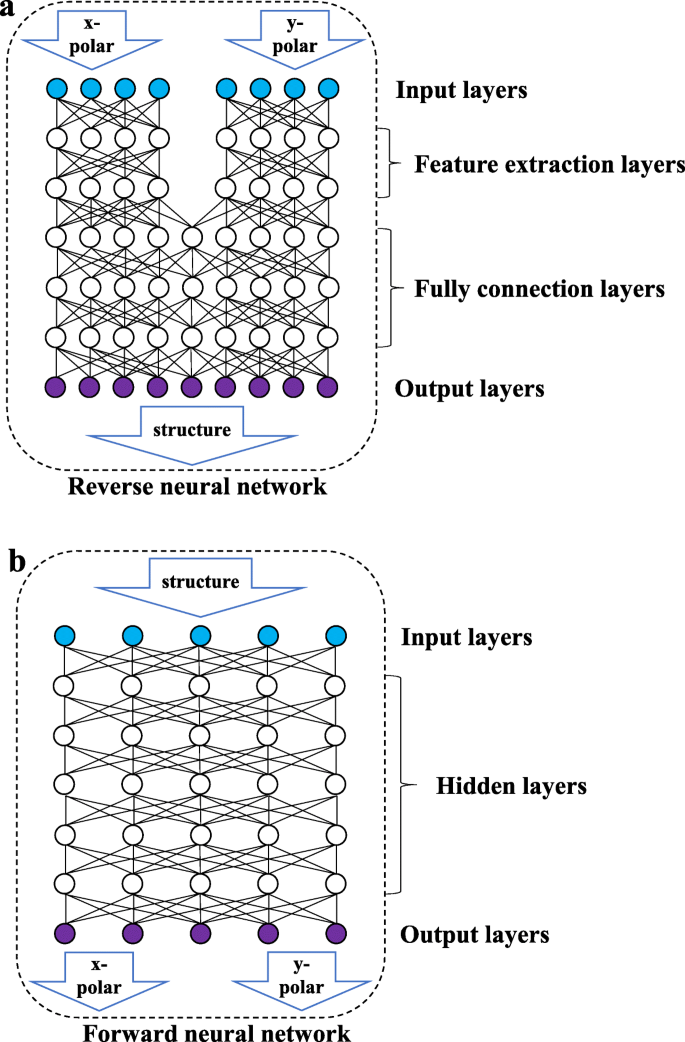
Wie in Abb. 3b gezeigt, ist das Vorwärtsnetzwerk ein vollständig verbundenes Netzwerk, in dem alle Knoten zweier benachbarter Schichten miteinander verbunden sind. Die Eingabedaten sind die strukturellen Parameter, und die Ausgabe ist die Wellenlängen-Reflexionskurve der beiden Polarisationsrichtungen. Wie in Abb. 3a gezeigt, besteht das Rückwärtsnetzwerk aus einer Merkmalsextraktionsschicht (FE-Schicht) und einer vollständig verbundenen Schicht (FC-Schicht). Die FE-Schicht umfasst zwei Sätze vollständig verbundener Netzwerke, die nicht miteinander verbunden sind, und verarbeitet die Wellenlängen-Reflexionskurven des linear polarisierten Lichts in den zwei Richtungen, um einige Merkmale der Eingabedaten zu extrahieren. Die FC-Schicht wird die extrahierten Merkmale lernen und die strukturellen Parameter ausgeben. Aufgrund der Eigenschaften hoher Kohäsion und niedriger Kopplung zwischen den Wellenlängen-Reflexionskurven in verschiedenen Polarisationszuständen kann die Trennung der Eingaben von zwei Sätzen polarisierten Lichtdaten in verschiedenen Richtungen verhindern, dass das Netzwerk während des Datenextraktionsprozesses durch Datennormalisierung gestört wird. Das Vorwärtsnetzwerk beinhaltet nicht mehrere Sätze von Eingaben und muss keine gegenseitige Störung zwischen Daten berücksichtigen, daher hat es keine Merkmalsextraktionsschicht.
Um die optimale Netzwerkstruktur zu bestimmen, werden Netzwerke in verschiedenen Strukturen mit dem gleichen Datensatz trainiert. Wie in Abb. 4 gezeigt, nachdem die Daten 50 Epochen erlebt haben (wenn alle Daten einen vollständigen Trainingsdurchlauf durchlaufen haben, wird dies eine Epoche genannt), der MSE, der durch das Vorwärtsnetzwerk verschiedener Strukturen erreicht wird. Wie aus dem linken Bild von Abb. 4 ersichtlich, erreicht das Vorwärtsnetzwerk, wenn es 5 versteckte Schichten enthält, jede mit 100 Knoten, den niedrigsten MSE von etwa 0,0174, sodass das Vorwärtsnetzwerk dieser Struktur ausgewählt wird.
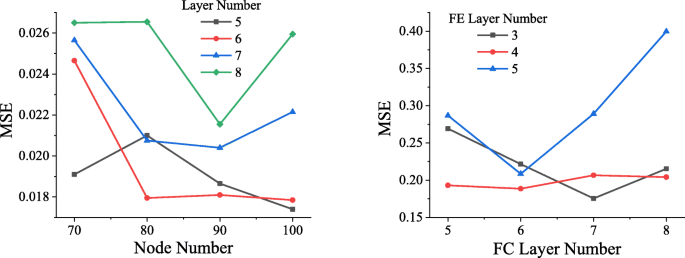
Ähnlich wurden verschiedene Netzwerke von Rückwärtsnetzwerken trainiert, und das Trainingsvolumen wurde weiterhin auf 50 Epochen festgelegt. Das Ergebnis ist im rechten Bild von Abb. 4 gezeigt. Wenn die Anzahl der FC-Schichten 7 und die Anzahl der FE-Schichten 3 beträgt, erreicht das Netzwerk den niedrigsten MSE von etwa 0,1756.
Wir fanden heraus, dass eine größere Anzahl von Netzwerkschichten ein Gradientenexplosionsphänomen erzeugen wird, was dazu führt, dass das Netzwerk nicht konvergiert, und der Verlust unendlich ist, daher wird es nicht in der Abbildung aufgeführt.
Datenvorverarbeitung
Um ein zuverlässigeres Vorwärtsnetzwerk zu trainieren, werden die Reflexionsdaten neu aufgeteilt und mit der Brechzahl von Au und SiO₂, die jeder Frequenz entspricht, zusammengefügt. Die sortierten Daten werden dann normalisiert und in das Vorwärtsnetzwerk eingegeben, was die Genauigkeit des Vorwärtsnetzwerks erheblich verbessern kann.
Um sicherzustellen, dass Daten mit größeren Werten nicht einen höheren Einfluss auf das Netzwerk haben als Daten mit kleineren Werten, müssen die Eingabedaten normalisiert werden, damit jede Datenspalte der Standardnormalverteilung entspricht (der Mittelwert ist 0, die Varianz ist 1), und dann können die verarbeiteten Daten x wie folgt ausgedrückt werden:
x = (x₀ - μ) / σ
In dem Ausdruck ist x₀ die ursprüngliche Stichprobendaten, μ der Stichprobenmittelwert und σ die Stichprobenstandardabweichung. Wenn die Eingabedaten nicht neu aufgeteilt werden, wird die Reflexion nach der Normalisierung verzerrt, was die Genauigkeit des Netzwerks verringert. Die neu aufgeteilten Daten werden ihre Verteilung durch Normalisierung nicht beeinflussen.
Neuronales-Netzwerk-Verfahren
Das Prinzip des neuronalen Netzes besteht darin, viele Neuronen (Knoten) durch Nachahmung der Arbeits- und Lernweise des menschlichen Gehirns aufzubauen [27]. Neuronen sind miteinander verbunden, und die Ausgabe wird durch Anpassen des Verbindungsgewichts angepasst. Die Ausgabe des j-ten Knotens einer Schicht kann wie folgt ausgedrückt werden:
y_j = Σ(i=1 bis n) f(w_i x_i + b_j) / n
f ist die Aktivierungsfunktion, w_i ist das Verbindungsgewicht des i-ten Knotens der vorherigen Schicht, der mit dem j-ten Knoten verbunden ist, x_i ist die Ausgabe des i-ten Knotens der vorherigen Schicht, b_j ist der Bias-Term dieses Knotens, und n ist die Anzahl der Knoten in der vorherigen Schicht, die mit dem j-ten Knoten verbunden sind.
Wahl einer Aktivierungsfunktion
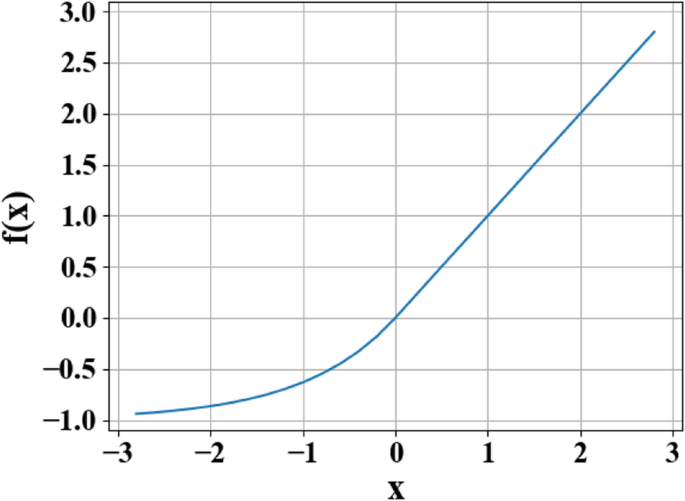
Um die hohe Nichtlinearität des inversen Problems zu erfüllen, wird die ELU-Funktion [28] als Aktivierungsfunktion jeder Neuronenschicht verwendet [28]. Die Ausgabe f(x) der ELU-Funktion kann in stückweiser Form wie folgt ausgedrückt werden:
f(x) = { x für x ≥ 0; α(eˣ - 1) für x < 0 }
In dieser Funktion ist x die ursprüngliche Eingabe, und der Parameterwert für α reicht von 0 bis 1.
Der Grund für die Verwendung der Aktivierungsfunktion ist, dass die Aktivierungsfunktion die nichtlineare Ausdrucksfähigkeit jeder Netzwerkschicht ändert, wodurch die gesamte nichtlineare Anpassungsfähigkeit des Netzwerks verbessert wird. Wie in Abb. 5 gezeigt, kombiniert die ELU-Funktion die Vorteile von Sigmoid- und Rektifizierten-Linearen-Einheiten (ReLU)-Aktivierungsfunktionen. Wenn x < 0, hat sie eine bessere weiche Sättigung, was das Netzwerk robuster gegenüber Eingabeänderungen und Rauschen macht. Wenn x > 0, gibt es keine Sättigung, was hilft, das Verschwinden des Gradienten des Netzwerks zu lindern. Das Merkmal, dass der Mittelwert von ELU nahe bei 1 liegt, kann das Netzwerk leichter anpassen. Das Ergebnis beweist, dass die Verwendung von ELU als Aktivierungsfunktion des Deep-Learning-Neuronalen Netzes die Robustheit des Netzwerks signifikant verbessert.
Gewichtsinitialisierungsschema
Die Initialisierungsmethode des Netzwerkgewichts jeder Schicht bestimmt die Geschwindigkeit der Netzwerkanpassung und sogar, ob das Netzwerk anpassen kann oder nicht. Varianz-Skalierungs-Initialisierung basiert auf der Menge der Eingabedaten jeder Schicht und extrahiert Gewichte aus einer abgeschnittenen Normalverteilung, die auf 0 zentriert ist, sodass die Varianz auf einen bestimmten Bereich reduziert werden kann, dann können die Daten tiefer über das Netzwerk verbreitet werden [29]. Auf dieser Netzwerkstruktur kann die Verwendung von Varianz-Skalierungs-Initialisierung die Konvergenzgeschwindigkeit des Netzwerks signifikant beschleunigen.
Overfitting-Lösung
Wegen unzureichender Daten wird das Netzwerk einige Overfitting erzeugen. Mit reduziertem Overfitting kann das Netzwerk gute Generalisierungsleistung auf Daten außerhalb des Trainingsets haben. L2-Regularisierung (auch als Weight-Decay in Regressionsproblemen bezeichnet) wird verwendet, um das Gewicht w zu verarbeiten. Die regularisierte Ausgabe L kann wie folgt ausgedrückt werden:
L = L₀ + (λ / 2n) Σ w²
In Gleichung (4) stellt L₀ die ursprüngliche Verlustfunktion dar, und auf dieser Basis wird ein Regularisierungsterm (λ / 2n) Σ w² hinzugefügt, wobei λ den Regularisierungskoeffizienten, n den Datendurchsatz und w das Gewicht darstellt. Nach Hinzufügung des Regularisierungsterms neigt der Wert des Gewichts w insgesamt dazu, abzunehmen, und das Auftreten übermäßiger Werte kann vermieden werden, daher wird w auch als Gewichtsdämpfung bezeichnet. L2-Regularisierung kann das Gewicht reduzieren, um eine große Steigung der angepassten Kurve zu vermeiden, wodurch das Overfitting-Phänomen des Netzwerks effektiv gelindert und die Konvergenz unterstützt wird.
Auf dieser Basis wird auch die Dropout-Methode verwendet. Diese Methode kann visuell als "Verstecken" eines bestimmten Maßstabs von Netzwerkknoten für jedes Training angesehen werden, und bei jedem Training werden verschiedene Knoten versteckt, um das Ziel zu erreichen, mehrere "partielle Netzwerke" zu trainieren. Und durch Training können die meisten "partiellen Netzwerke" die Ziele genau repräsentieren, und die Ergebnisse aller "partiellen Netzwerke" können sortiert werden, um die Lösung der Ziele zu erhalten.
Die Verwendung der oben genannten L2-Regularisierung und Dropout-Methoden kann nicht nur die durch unzureichende Daten verursachte niedrige Generalisierung effektiv lindern, sondern auch die Auswirkung einer kleinen Menge fehlerhafter Daten im Datensatz auf die Trainingsergebnisse reduzieren.
Auf dieser Netzwerkstruktur und Datensatz, mit Dropout = 0,2 und L2-Regularisierungskoeffizient λ = 0,0001, kann das Netzwerk ähnliche Genauigkeit auf dem Trainings- und Testset erzielen, wodurch eine hohe Generalisierungsleistung erreicht wird.
Ergebnisse und Diskussion
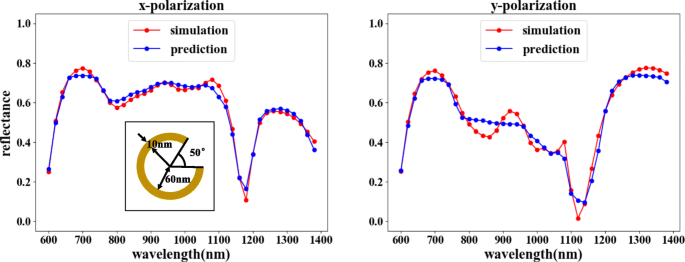
Nach dem Training kann unser Vorwärtsnetzwerk einen hohen Anpassungsgrad erreichen, mit einem MSE von 0,0015, was zeigt, dass die Ausgabe den Simulationsergebnissen sehr ähnlich ist, wie in Abb. 6 gezeigt. Dies stellt auch sicher, dass beim Training des Rückwärtsnetzwerks die Ergebnisse des Rückwärtsnetzwerks zuverlässig verifiziert werden können.
Schließlich werden wir zwei Modelle aus dem gelernten Netzwerk generieren und die beiden Modelle verbinden, um die Vorhersagefunktion zu erreichen.
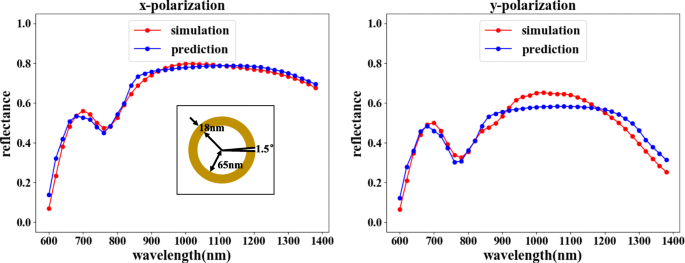
Die Vorhersagefunktion kann die in Abb. 2a gezeigte Kombination wählen. Das Rückwärtsnetzwerk sagt die entsprechende Struktur gemäß der erforderlichen Wellenlängen-Reflexionskurve voraus, und das Vorwärtsnetzwerk verifiziert die optische Antwort der Struktur. Wie in Abb. 7 gezeigt, durch Vergleich der verifizierten Reflexion mit der Eingangsreflexion sind die Reflexionseigenschaften des einfallenden Lichts in den beiden Polarisationsrichtungen im Wesentlichen konsistent. Obwohl geringfügige Reflexionsabweichungen für bestimmte Wellenlängenwerte beobachtbar sind, ist der gesamte Anpassungstrend eindeutig unanfechtbar, da die Fehler innerhalb eines akzeptablen Bereichs liegen.
Schlussfolgerung
In diesem Artikel haben wir unser entworfenes Deep-Learning-Netzwerk vorgestellt, das in der Lage ist, verschiedene Effekte durch flexible Kombinationen von Netzwerkkonfigurationen zu erzeugen. Unser entworfenes Rückwärtsnetzwerk kann die erforderliche Struktur mithilfe der Eingabe-Wellenlängen-Brechkurve vorhersagen, was die zur Lösung des inversen Problems erforderliche Zeit erheblich reduzieren und unterschiedliche Bedürfnisse durch flexible Kombinationen erfüllen kann. Die Ergebnisse zeigen, dass das Netzwerk eine höhere Genauigkeit in Vorhersagen erreicht hat, was weiter impliziert, dass On-Demand-Design durch unsere Methode gelöst werden kann. Die Verwendung von Deep Learning zur Anleitung des Metamaterial-Designs kann automatisch genauere Metamaterialstrukturen erhalten, ein Ergebnis, das mit traditionellen Designmethoden nicht erreichbar ist.
Verfügbarkeit von Daten und Materialien
Die Daten, aus denen das Manuskript stammt, kommen aus unserem Simulationsnetzwerk, und wir können sie aus persönlichen Gründen nicht teilen.
Abkürzungen
- ELU:
- Exponential linear units
- FC layer:
- Fully connected layer
- FE layer:
- Feature extraction layer
- FNN:
- Forward neural network
- MSE:
- Mean square errors
- ReLU:
- Rectified linear unit
- RNN:
- Reverse neural network
- SRR:
- Split-ring resonator
Nanomaterialien
- Deep Learning mit FPGAs beschleunigen: Geschwindigkeit, Flexibilität und Energieeffizienz
- TI präsentiert ersten automobilen SoC mit dediziertem KI-Beschleuniger
- Raspberry Pi Ziffernerkennung mit TensorFlow & OpenCV selbst bauen
- Visionsbasierter Hindernis-vermeidender Mobiler Roboter auf Raspberry Pi
- Anlagenverlässlichkeit steigern: Machine Learning für proaktive Asset Performance nutzen
- IBMs Phasenwechsel-Künstliche Neuronen Imitieren Gehirn-Spikes Für Ultra-Dichte, Niedrigenergie-Computing
- Wireless Network Devices und Sigfox bauen landesweites UK-IoT-Netzwerk auf
- Javas split()-Methode meistern: Praktischer Leitfaden mit Code-Beispielen
- Synergistische elektrische Verbesserung in Epoxid-Composites mit Kohlenstoffnanoröhren und Graphit-Nanoplatelets
- Präzise Batterielebensdauer-Vorhersage mit KI – DOE Argonne Studie