



Xilinx enthüllt Alveo U55C: Doppeltes HBM, skalierbares Clustering für HPC und Big-Data-Workloads
Auf der SC21 Supercomputing-Konferenz enthüllte Xilinx den Alveo U55C Data-Center-Beschleuniger und eine neue, standardsbasierte API-getriebene Clustering-Lösung, die es Kunden ermöglicht, FPGAs in beispiellosem Maßstab einzusetzen. Durch die Ermöglichung von Clustern aus hunderten Alveo-Karten und die Vereinfachung von Applikations- und Cluster-Programmierung macht die neue Plattform das Skalieren von HPC-Workloads sowohl einfacher als auch effizienter.
Für HPC und Large-Scale Data Analytics konzipiert
Der U55C ist speziell für High-Performance-Computing und große Datenanalysen konzipiert. Er liefert die höchste Compute-Dichte und HBM-Kapazität in Xilinx’ Alveo-Linie. Gepaart mit einem RoCE v2-basierten Clustering-Framework befähigt die Karte Nutzer, leistungsstarke FPGA-basierte HPC-Cluster mit ihren bestehenden Data-Center-Servern und Ethernet-Netzwerken aufzubauen.
„Dies ist ein großer Schritt hin zu breiterer Adoption von Alveo und adaptivem Computing im Rechenzentrum“, so Xilinx.
In einem Interview mit embedded.com erklärte Nathan Chang, Xilinx’ HPC Produktmanager, dass viele Workloads jetzt speicherbandbreiten-limitiert statt rechenlimitiert sind. „Wir haben die Karte auf einen Single-Slot-Formfaktor getrimmt und ihr HBM verdoppelt, während wir die Fähigkeit hinzugefügt haben, über hunderte Karten zu skalieren, damit all diese Bandbreite genutzt werden kann“, sagte er.
Er fügte hinzu: „Das Freischalten von Bandbreite über Cluster war eine Herausforderung. Entwickler mussten zuvor ihre eigenen Clustering-Lösungen entwerfen. Mit unserem Open-Standards-Paket – RoCE v2 und Data Center Bridging über Ethernet mit 200 Gbps pro Karte – können Nutzer jetzt Cluster bauen, die in Leistung und Latenz mit InfiniBand konkurrieren, ohne Vendor Lock-in.“
„Das bedeutet, dass in bestehender Rechenzentrumsinfrastruktur diese Karten in aktuellen Servern installiert werden können, das bestehende Ethernet-Fabric genutzt wird und man sowohl in Geschwindigkeit als auch Kosten mit InfiniBand konkurrieren kann“, fuhr Chang fort.
Ein weiterer Vorteil ist, dass Vitis nun für Entwickler zugänglicher ist. Hochsprachen wie C, C++ und Python sowie große KI-Frameworks wie PyTorch und TensorFlow können Alveo ansprechen, ohne RTL- oder Verilog-Expertise zu erfordern.
Alveo U55C Features für HPC und Big Data
Der U55C kombiniert mehrere Schlüsselattribute, die moderne HPC-Workloads verlangen:
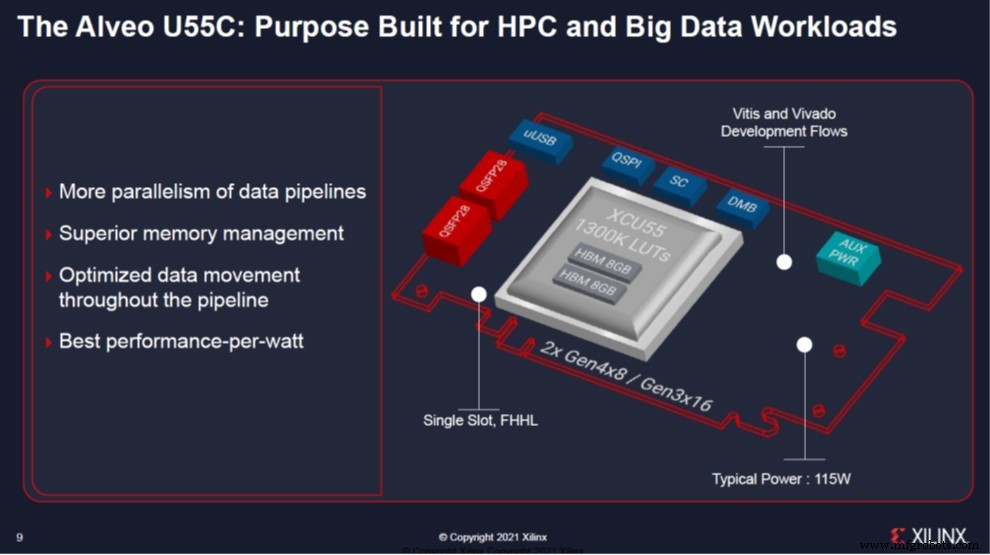
- Höchste Compute-Dichte und 16 GB HBM2 – doppelt so viel wie die vorherige Dual-Slot U280.
- Single-Slot Full-Height, Half-Length (FHHL) Formfaktor mit maximal 150 W Leistungsaufnahme.
- Überlegene Data-Pipeline-Parallelität, Speichermanagement und Datenbewegung-Optimierung für maximale Performance-per-Watt.
- 200 Gbps RoCE v2 Networking, das in Latenz und Bandbreite mit InfiniBand konkurriert.
Die API-getriebene Clustering-Lösung, basierend auf RoCE v2 und Data Center Bridging, lässt Nutzer dichte Alveo-Netzwerke aufbauen, die über hunderte Karten skalieren – unabhängig von Serverplattform oder Netzwerk-Fabric – während Workloads und Speicher geteilt werden. MPI-Integration aus der Xilinx Vitis Unified Software Platform ermöglicht Entwicklern nahtloses Skalieren von Datenpipelines.
Software-Ingenieure und Data Scientists können die High-Level-Programmierbarkeit der Vitis-Plattform nutzen. Xilinx hat stark in Vitis investiert, um die Einstiegshürde für adaptives Computing zu senken. Mit Support für PyTorch, TensorFlow, C, C++ und Python können Entwickler kritische HPC-Workloads in ihren bestehenden Rechenzentrumsumgebungen beschleunigen.
Wer nutzt den U55C?
Chang hob mehrere Proof-of-Concept-Deployments hervor.
CSIRO, Australien
CSIROs Square Kilometre Array Projekt nutzt 420 U55C Karten für Echtzeit-Signalverarbeitung von 131.000 Antennen. Der Cluster – vernetzt durch P4-fähige 100 Gbps Switches – liefert 460 Gbps HBM2 Bandbreite und 15 Tb/s aggregierten Durchsatz in einem kompakten, energieeffizienten Footprint.
Ansys LS-DYNA
Automobil-Sicherheitssimulationen profitieren von mehr als 5x Speed-up gegenüber x86 CPUs, wenn LS-DYNA auf geclusterten U55C Karten läuft. Durch Hyper-Parallelisierung von Datenpipelines handhabt der Solver Hunderte Millionen Freiheitsgrade effizienter und reduziert Simulationszeit drastisch.
TigerGraph
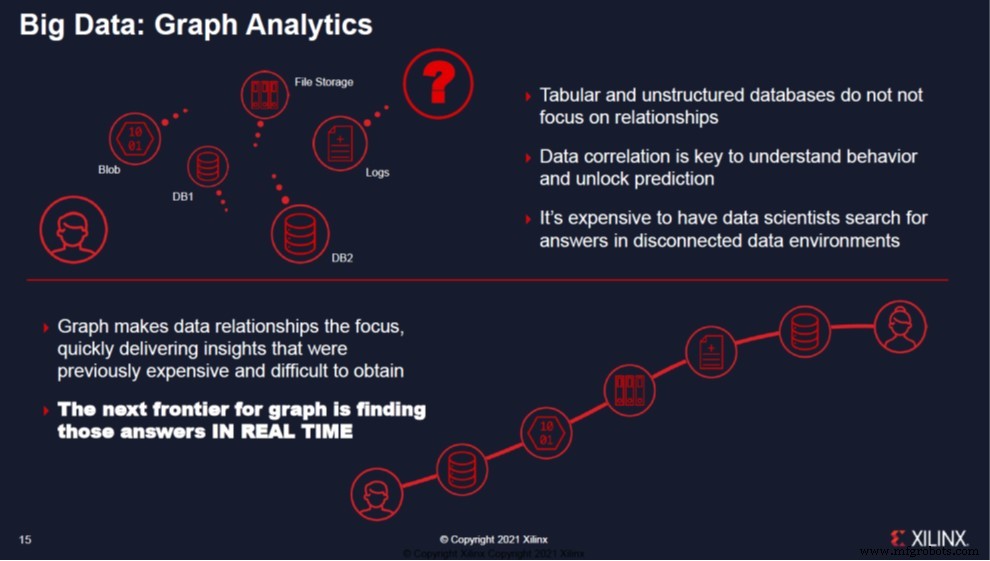
Graph-Analytics-Workloads sehen bis zu 45x schnellere Abfragezeiten und 35% höhere Empfehlungsgenauigkeit, wenn sie durch mehrere U55C Karten beschleunigt werden, was Vorhersagelatenz von Minuten auf Millisekunden senkt.
Der Alveo U55C ist jetzt über Xilinx’ Website und autorisierte Distributoren verfügbar. Er kann auch über Cloud FPGA-as-a-Service-Plattformen und ausgewählte Colocation-Rechenzentren evaluiert werden. Clustering ist für Private Preview verfügbar, mit allgemeiner Verfügbarkeit für Q2 nächsten Jahres geplant.
Eingebettet
- Siemens erweitert Veloce System um vier neue Produkte für nahtlose Hardware-Assisted Verification
- TI stellt BAW Resonator Chips vor: Revolution für Next-Gen Connectivity
- DATA MODUL lanciert Hybrid-Bonding-Technologie für hochvolumige industrielle Touch-Displays
- Cervoz Military-Grade SSD: Robuster Speicher für missionskritische Defense- und Aerospace-Anwendungen
- CEVA enthüllt NeuPro-S: Next-Gen AI Prozessor für Edge Deep Neural Network Inference
- Kontron enthüllt COM HPC: Neuer High-Performance Embedded Computing Standard
- acceed EDAM-4200 Serie: Integrierte I/O Module für skalierbare, zuverlässige Datenkommunikation
- Top 4 Herausforderungen für das Industrial Internet of Things (IIoT)
- Kann Big Data Gesundheitsbudgets revolutionieren? Lux Research Insights
- Big Data vs. KI: Synergie hinter der digitalen Transformation