



Zephyr-basierte IoT-Geräte debuggen: Bewährte Remote-Monitoring-Praktiken
Das Linux Foundation Zephyr Open Source Project ist zum Eckpfeiler für unzählige IoT-Lösungen geworden. Mit einem leichten, skalierbaren Echtzeit-Betriebssystem (RTOS), das für ressourcenbeschränkte Geräte konzipiert ist, unterstützt Zephyr ein breites Spektrum an Architekturen – ARC, Arm, Intel, Nios, RISC‑V, SPARC, Tensilica – und mehr als 250 Boards. Heute verzeichnet das Projekt 1.000 Contributors und 50.000 Commits, die seine Multi-Architektur-Reichweite kontinuierlich erweitern.
Entwicklung für Zephyr erfordert Aufmerksamkeit für Zuverlässigkeit. Probleme, die im Labor auftauchen, verschwinden oft erst, wenn Geräte skalieren, oder wenn sich Netzwerkstacks weiterentwickeln. Eine robuste Strategie für Remote-Monitoring und Debugging ist essenziell, um Probleme zu erkennen, zu diagnostizieren und zu lösen, bevor sie in kostspielige Ausfallzeiten umschlagen.
Betrachten Sie unsere Arbeit mit GPS-Trackern für Farmtier-Überwachung. Jeder Halsband musste nahtlos über mehrere Mobilfunknetze, Länder und Roaming-Zonen operieren. Unerwarteter Stromverbrauch durch Fehlkonfiguration hätte zu erheblichem wirtschaftlichen Verlust geführt. Wir mussten nicht nur das Problem kennzeichnen, sondern seine Ursache verstehen und einen Fix deployen – daher die Notwendigkeit für Echtzeit-Remote-Observability.
Wir kombinierten Zephyr mit Memfault, einer cloud-basierten Device-Observability-Plattform, um einen Monitoring-Stack zu bauen, der Firmware-Updates, Reboots, Watchdogs, Faults, Asserts und Konnektivitätsmetriken abdeckt.
Observability-Plattform einrichten
Memfault befähigt Entwickler, Firmware-Änderungen remote zu überwachen, zu debuggen und auszurollen, was ermöglicht:
- Graceful Production Rollouts, die Freezes vermeiden
- Kontinuierliche Gesundheitsüberwachung von Geräteflotten
- Zero-Downtime Patches, bevor Nutzer einen Hiccup bemerken
Die Integration des Memfault SDK in Zephyr ist unkompliziert: Modul zu Ihrer west.yml Manifest hinzufügen und in prj.conf aktivieren.
# west.yml [ ... ] - name: memfault-firmware-sdk url: https://github.com/memfault/memfault-firmware-sdk path: modules/memfault-firmware-sdk revision: master # prj.conf CONFIG_MEMFAULT=y CONFIG_MEMFAULT_HTTP_ENABLE=y1️⃣ Fokus auf Reboots
Erhöhte Reset-Raten sind oft das erste Anzeichen für ein tieferes Problem – Hardware-Degradation, Firmware-Bugs oder Netzwerkanomalien. Durch Unterscheidung zwischen Hardware- und Software-Resets können Sie feststellen, ob ein Fehler weit verbreitet ist oder auf eine Teilmenge von Geräten isoliert ist.
Grund vor Reboot aufzeichnen
void fw_update_finish(void) { // … memfault_reboot_tracking_mark_reset_imminent(kMfltRebootReason_FirmwareUpdate, ...); sys_reboot(0); }Zephyr bewahrt eine benutzerdefinierte Region über Resets hinweg; Memfault hookt sich hier ein, um den Reboot-Kontext zu erfassen. Nach einem Reboot registrieren Sie einen Init-Handler, um den Hardware-Reset-Grund zu lesen und an die Cloud zu senden.
static int record_reboot_reason(void) { // 1. Hardware-Reset-Grund-Register lesen (siehe MCU-Datenblatt) // 2. Software-Reset-Grund aus noinit RAM erfassen // 3. Daten an Server zur Aggregation senden } SYS_INIT(record_reboot_reason, APPLICATION, CONFIG_KERNEL_INIT_PRIORITY_DEFAULT);Beispiel: Ein Netzteildefekt kann sich als Tausende von Reboots in kurzer Zeit manifestieren. Abbildung 1 zeigt eine Flotte, wo 99 % von 12.000 Reboots pro Tag auf nur zehn Geräte zurückzuführen sind – wahrscheinlich ein mechanisches oder Batterieproblem. Firmware-Updates können solche Probleme mildern, aber Remote-Monitoring lässt Sie sie erkennen und beheben, bevor sie kaskadieren.
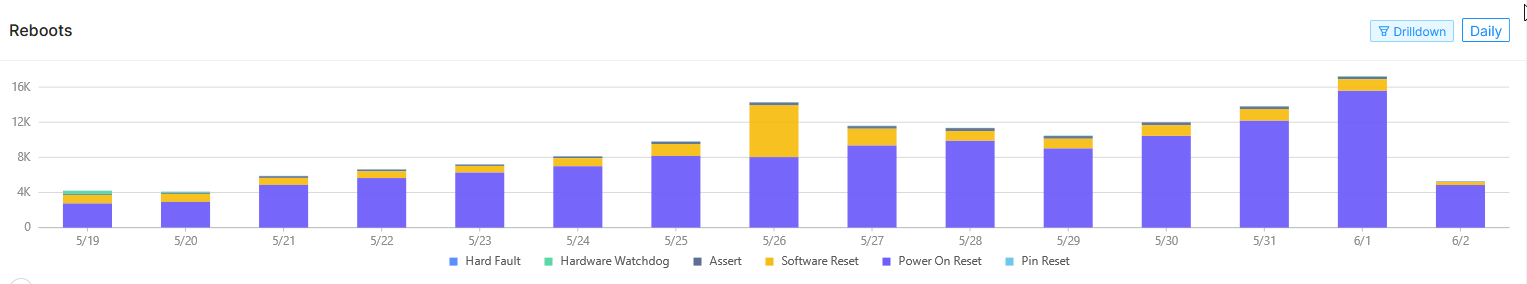
Abbildung 1: Netzteilproblem, Reboots über 15 Tage. (Quelle: Autoren)
- 12K Geräte-Reboots pro Tag – zu viele
- 99% der Reboots von 10 Geräten
- Mechanischer Defekt verursacht konstante Resets
2️⃣ Watchdogs nutzen
Watchdogs sind Ihre letzte Verteidigungslinie gegen Hänger – ob durch blockierte Netzwerkstacks, endlose Schleifen, Deadlocks oder Speicherkorruption. Zephyr stellt eine vereinheitlichte Watchdog-API bereit, die Hardware-Unterschiede abstrahiert.
void start_watchdog(void) { struct device *s_wdt = device_get_binding(DT_LABEL(DT_INST(0, nordic_nrf_watchdog))); struct wdt_timeout_cfg wdt_config = { .flags = WDT_FLAG_RESET_SOC, .window.min = 0U, .window.max = WDT_MAX_WINDOW, }; s_wdt_channel_id = wdt_install_timeout(s_wdt, &wdt_config); const uint8_t options = WDT_OPT_PAUSE_HALTED_BY_DBG; wdt_setup(s_wdt, options); } void feed_watchdog(void) { wdt_feed(s_wdt, s_wdt_channel_id); }Für den Nordic nRF9160 ist der typische Workflow:
- Device Tree für Watchdog konfigurieren.
- Parameter via API setzen.
- Watchdog installieren.
- Periodisch füttern; ein verpasster Feed löst Reboot und Zephyr Fault Handler aus.
Memfault erfasst den Pre-Reset-State, sodass Sie zurück zum fehlerhaften Code-Pfad verfolgen können. Beispiel: Ein SPI-Treiber, der nach 16 Monaten Deployment stecken bleibt, wird durch einen Watchdog-initiierten Fault enthüllt. Abbildung 2 illustriert Timeline und Degradation, während Abbildung 3 den Fault-Handler Register Dump zeigt.
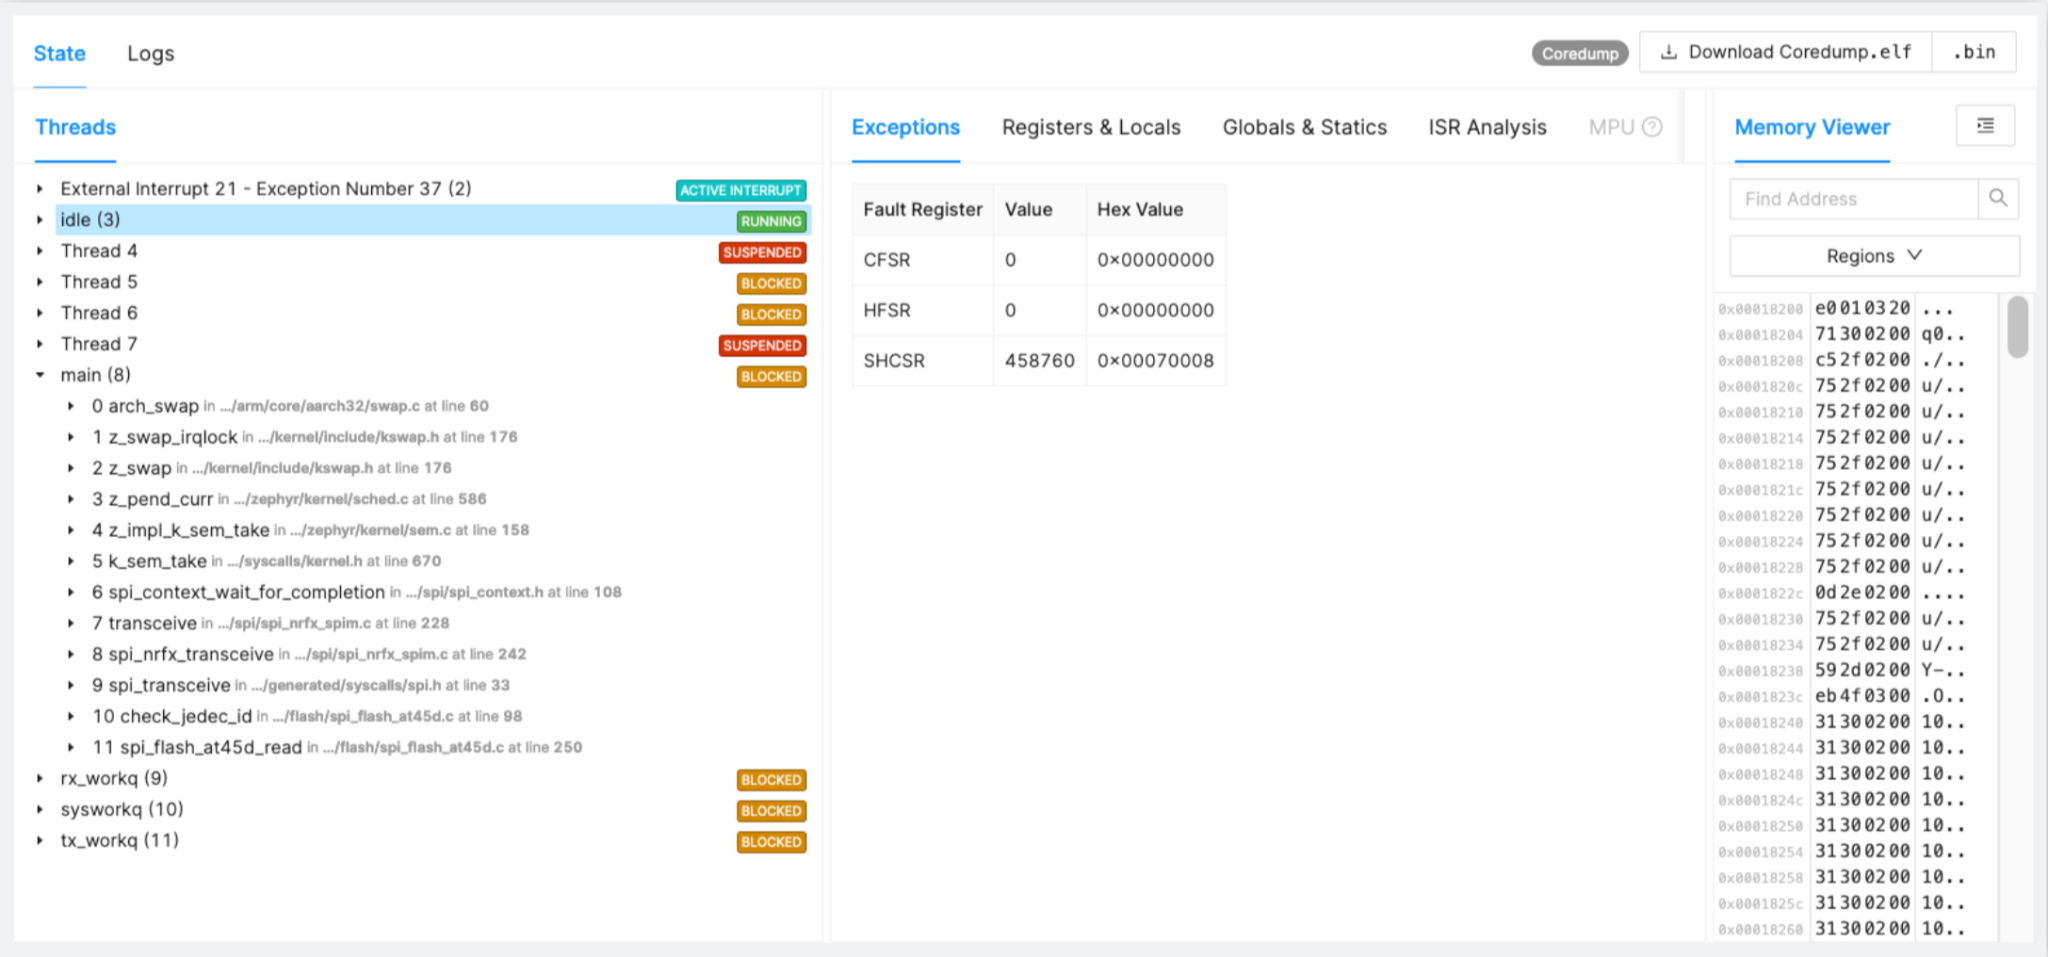
Abbildung 2: SPI Driver Stuck Beispiel. (Quelle: Autoren)
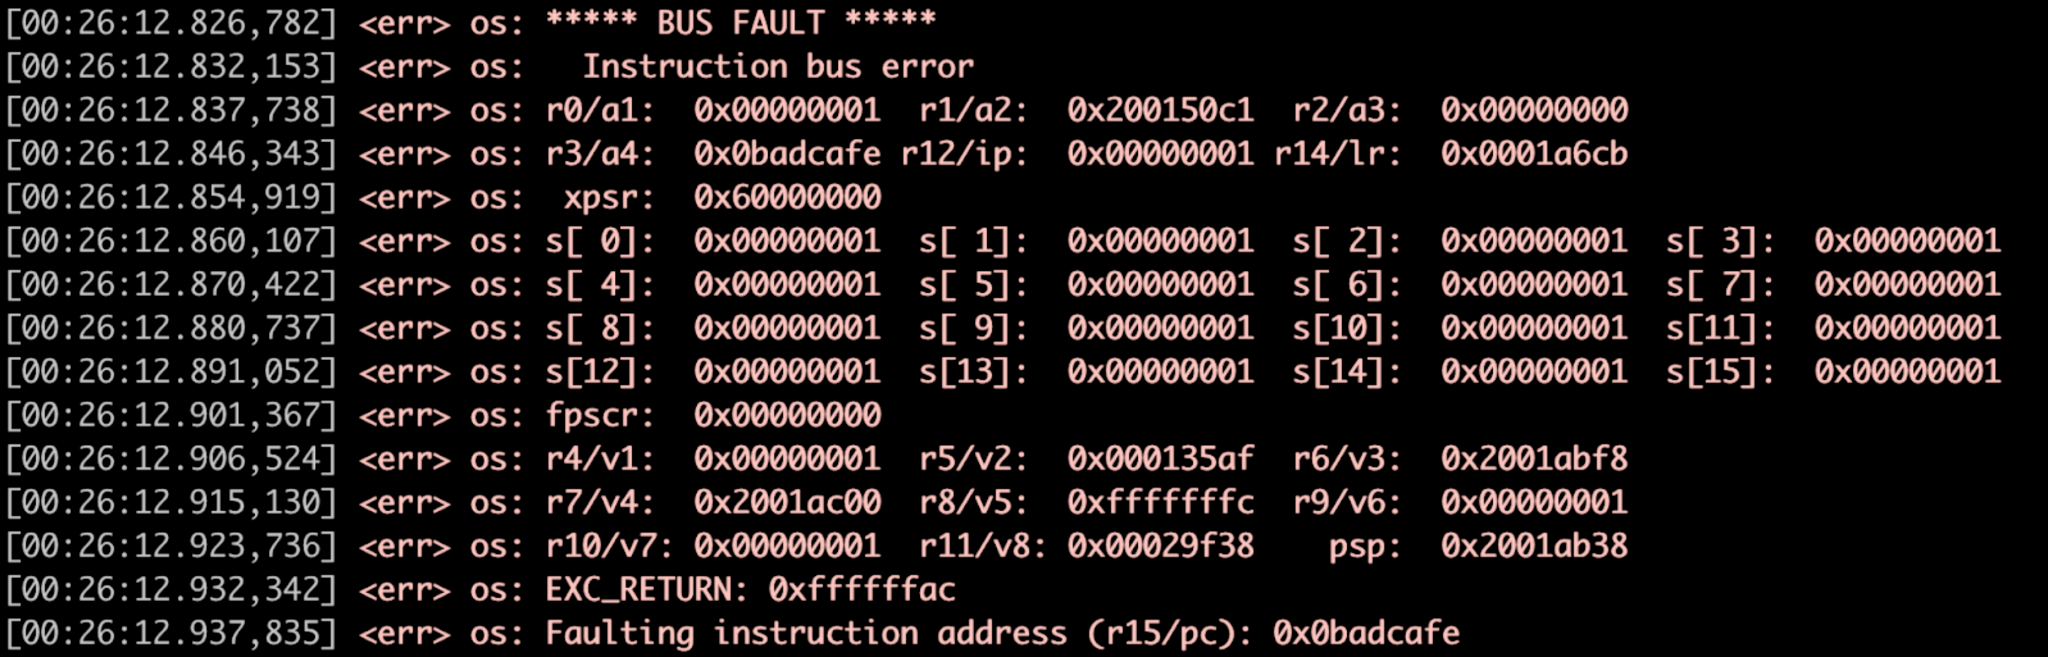
Abbildung 3: Fault Handler Beispiel, Register Dump. (Quelle: Autoren)
3️⃣ Faults und Asserts behandeln
Wenn ein Assert oder Fault auslöst, erfasst Zephyrs Fault Handler den CPU-State. Memfault hookt nahtlos in diesen Fluss ein, persistiert Register, Kernel-Kontext und einen Snapshot aller aktiven Tasks in die Cloud.
void network_send(void) { const size_t packet_size = 1500; void *buffer = z_malloc(packet_size); // Fehlender NULL-Check führt zu Fault memcpy(buffer, 0x0, packet_size); } bool memfault_coredump_save(const sMemfaultCoredumpSaveInfo *save_info) { // Register-State, Kernel & Task-Kontexte, ausgewählte .bss/.data speichern } void sys_arch_reboot(int type) { // … }Wesentliche Diagnostik umfasst:
- Der Cortex‑M Fault Status Register zeigt die Ursache an.
- Memfault stellt die exakte Code-Zeile und umgebende Task-States wieder her.
- Die
_kernelStruktur offenbart Scheduler-Status und, für verbundene Stacks, Bluetooth- oder LTE-Parameter.
4️⃣ Geräte-Level-Metriken tracken
Metriken geben Ihnen einen quantifizierbaren Blick auf Flottengesundheit. Häufig überwachte Werte umfassen CPU-Last, Konnektivitätsmetriken und Thermaldaten. Memfaults SDK lässt Sie Metriken mit minimalem Code deklarieren und reporten.
- Metrik definieren
MEMFAULT_METRICS_KEY_DEFINE( LteDisconnect, kMemfaultMetricType_Unsigned)- Im Code aktualisieren
void lte_disconnect(void) { memfault_metrics_heartbeat_add( MEMFAULT_METRICS_KEY(LteDisconnect), 1); // … }Memfaults Cloud-Backend aggregiert Metriken nach Gerät und Firmware-Version und bietet ein Web-UI zum Vergleichen von Flotten und Auslösen von Alarmen. Typische Use Cases:
- NB‑IoT/LTE‑M Konnektivität: Modem-Power-States überwachen, um Batterieauswirkungen zu beurteilen.
- Cell-Tower-Events und PSM-Timing: Signalqualitäts-Hotspots identifizieren, die Strom verbrauchen.
- Großflotten-Telemetrie: Ausreißer und unerwartete Datenspitzen erkennen.
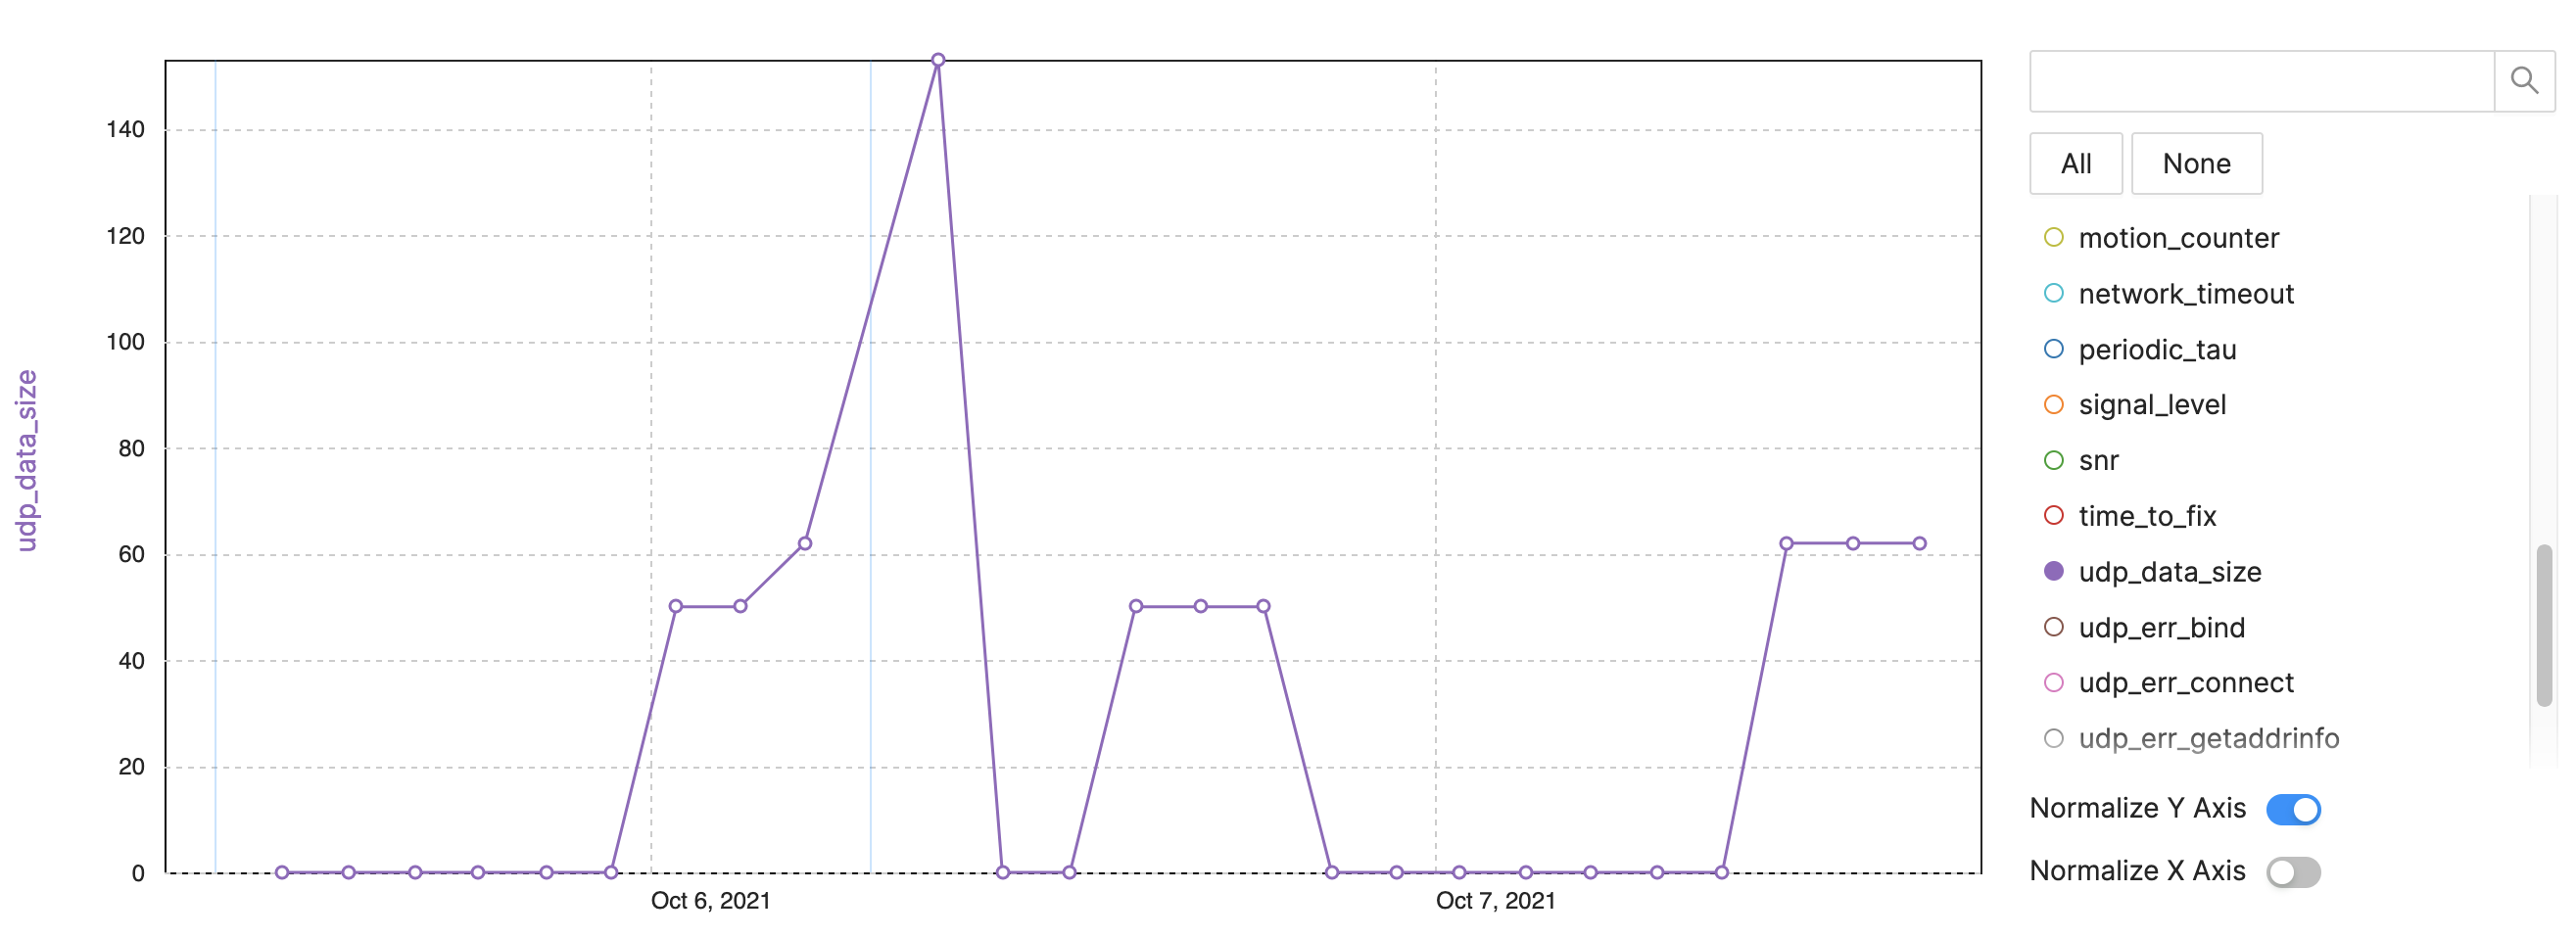
Abbildung 4: Metriken für Device Observability tracken – NB‑IoT Beispiel, LTE‑M Datengröße. (Quelle: Autoren)
- UDP Datengröße pro Sendeintervall.
- Datensprung nach Reboot.
- Große Pakete deuten auf eingebettete Traces oder Diagnostik hin.
- Metriken nutzen, um Datennutzung und Kosten zu steuern.
Fazit
Durch Integration von Zephyr mit Memfault gewinnen Entwickler einen mächtigen End-to-End-Observability-Stack. Fokussieren Sie auf vier Säulen – Reboots, Watchdogs, Faults/Asserts und Konnektivitätsmetriken – und Sie verwandeln eine Geräteflotte von undurchsichtigen Black Boxes in transparente, verwaltbare Systeme. Für tiefere Einblicke schauen Sie die aufgezeichnete Präsentation vom 2021 Zephyr Developer Summit.
Internet der Dinge-Technologie
- Synthetisches Monitoring meistern: Bewährte Best Practices für zuverlässige SaaS & Web Performance
- Cisco 1G Bidirektionale Transceiver: Service Provider und IoT Netzwerk-Effizienz steigern
- ETSI setzt neue Standards für IoT in der Notfallkommunikation
- IIC & TIoTA kooperieren zur Stärkung von IoT-Sicherheit und Blockchain-Standards
- NIST veröffentlicht Entwurfsrichtlinien zur Stärkung der IoT-Gerätesicherheit für Hersteller
- Atmosic und SMK kooperieren für IoT-Geräte mit extrem langer Lebensdauer
- Warum IoT für Asset Management essenziell ist: Top 3 Vorteile
- IoT: Die führende Plattform für präzises Umweltmonitoring
- Top-Anwendungen für Druckluftsysteme in verschiedenen Branchen
- Manufacturing Marketing: Bewährte Best Practices für 2019