



Vertrauenswürdige KI/ML-Prozessoren sicherstellen: Die kritische Rolle der Reliability Verification
Warum Reliability Verification für KI/ML-Prozessoren entscheidend ist
Mit KI und Machine Learning nun integral für ein breites Spektrum an Applikationen – von autonomen Fahrzeugen bis zur medizinischen Diagnostik – kann jeder Ausfall in der zugrundeliegenden Hardware die Glaubwürdigkeit des gesamten Systems untergraben.
In den letzten Jahren haben Unternehmen KI-Adoption beschleunigt und sie zur Top-Priorität für Geschäftsziele gemacht. Dieser Schwung wird durch algorithmische Fortschritte, hochmoderne Hardware-Designs und das exponentielle Wachstum digitalisierter Daten getrieben. Um dieses Wachstum zu sostainieren, müssen Unternehmen beweisen, dass Ergebnisse von KI/ML-Technologien vertrauenswürdig sind. Dieses Vertrauen beginnt beim Design und der Verifikation der Integrated Circuits (ICs), die KI/ML-Funktionalität antreiben.
KI/ML-Processing-Paradigmen
KI-Workloads lassen sich grob in Datacenter/Cloud-basiert oder Embedded kategorisieren. Im ersten Fall residieren Compute-Ressourcen in Remote-Rechenzentren, im zweiten sind dedizierte KI-Chips oder Co-Prozessoren in Geräten oder Edge-Servern näher am Nutzer eingebettet. Edge-Geräte können für Training (Machine Learning) oder Inferenz spezialisiert sein. Historisch fand Training in der Cloud statt, aber der Aufstieg hochperformanter Edge-Lösungen verlagert mehr Training-Workloads an den Edge.
KI/ML-Chips für missionskritische Umgebungen designen
Embedded KI-Chips sind auf spezifische Domänen zugeschnitten wie Automotive, Industrial Control oder Medical Diagnostics – viele davon missionskritisch. Beispielsweise muss ein Advanced Driver Assistance System (ADAS) Sensordaten innerhalb strenger Latenzfenster verarbeiten; eine Verzögerung kann zu katastrophalen Kollisionen führen.
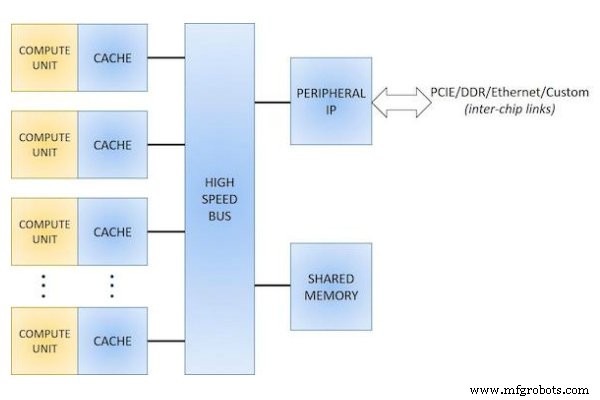
Diese ICs verfügen über extensive parallele Compute-Units, hohe Power-Dichten und komplexe Schaltungen, die darauf ausgelegt sind, Peak-Performance innerhalb enger Power-Envelopes zu liefern. Während General-Purpose CPUs einige KI-Aufgaben bewältigen können, limitiert ihre serielle Natur den Durchsatz. GPUs brillieren bei parallelen Workloads, und Field-Programmable Gate Arrays (FPGAs) bieten rekonfigurierbare Beschleunigung. Dennoch involviert der effizienteste Pfad oft Application-Specific Integrated Circuits (ASICs), die gemeinsam mit dem Software-Stack optimiert sind.
Vorteile ASIC-basierter KI-Lösungen
ASICs bieten überlegene Performance per Watt, deterministisches Verhalten, Flächenersparnis und schnelleres Time-to-Market. Abbildung 1 illustriert ein typisches ASIC KI-Chip Blockdiagramm.
Heterogenes Computing für optimale Performance
Viele moderne KI-Systeme kombinieren mehrere Core-Typen – CPUs, GPUs und ASICs –, um serielle Kontrollaufgaben mit paralleler Datenverarbeitung zu balancieren. Dieser heterogene Ansatz verbessert Durchsatz bei Erhalt der Power-Effizienz, oft gemessen als Tera-Operations pro Sekunde pro Watt (TOPS/W). Power-Saving-Techniken wie Dynamic Voltage and Frequency Scaling, Power Gating und Multi-Vt Designs sind essenziell, um diese Metriken zu treffen.
Angesichts der hohen Einsätze sind zuverlässiges Design und Verifikation dieser komplexen ICs paramount. Ein einzelner Schaltkreisfehler kann KI-Gültigkeit kompromittieren und Stakeholder-Vertrauen erodieren.
Herausforderungen der Reliability Verification für KI/ML ICs
KI/ML-Chips enthalten Millionen bis Milliarden Transistoren – NVIDIAs Tesla P100 GPU beispielsweise 15,3 Milliarden, Intels Loihi 2,07 Milliarden. Designer müssen distincte Reliability-Anforderungen für jede Zielumgebung erfüllen, was gründliches Testen gegen wohldefinierte Spezifikationen erfordert.
Limitationen traditioneller Verifikation
Manuelle Inspektion und klassische SPICE-Style-Simulationen sind für solch große Designs unpraktisch – zeitaufwändig, fehleranfällig und nicht skalierbar. Selbst wenn Designer IP-Blöcke für isolierte Verifikation partitionieren, werden Inter-Block-Interaktionen – besonders über Compute-Cores, Interconnects und High-Bandwidth Memory – oft übersehen, was zu inkompletter Coverage führt.
Lange Laufzeiten auf konventionellen Verifikations-Tools können Produktlaunches verzögern, was den Bedarf an automatisierten, skalierbaren Lösungen unterstreicht, die Multi-Core und verteilte Computing-Umgebungen nutzen.
Calibre PERC: Eine Foundry-qualifizierte Reliability-Plattform
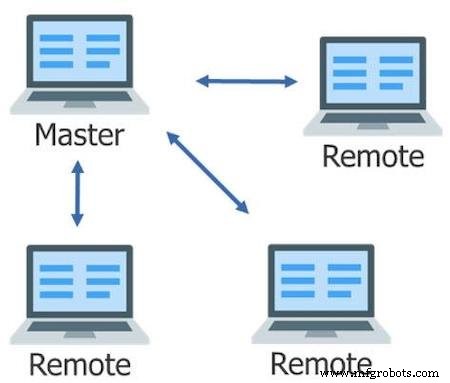
Die Calibre PERC Reliability-Plattform adressiert diese Herausforderungen durch Multi-Threaded (MT) und Multi-Threaded Flexible (MTflex) Skalierung, die Verifikationsaufgaben über mehrere CPUs und Remote-Maschinen verteilt für schnelle Ausführung auf großen KI/ML-Designs.
Über Basic Scaling hinaus integriert Calibre PERC Netlist- und Layout-Daten, um ein breites Spektrum an Reliability-Issues zu detektieren, wodurch Designer Performance- und Operational-Failures proaktiv mindern können.
Transistor-Level Reliability in Multi-Domain Power Architekturen
Moderne KI/ML ICs setzen oft Multiple Power Domains ein, um Analog IP zu isolieren, Power Gating zu ermöglichen und unabhängiges Voltage Scaling zu unterstützen. Beispielsweise nutzt Intels Skylake-Architektur neun primäre Power Domains.
Spezialisierte Schaltungselemente – Spannungsregler, Header/Footer Switches, Level Shifter, Isolation Cells und State-Retention Cells – sind an jedem Domain-Interface erforderlich. Verifikation muss korrekte Implementierung und Konnektivität dieser Elemente bestätigen, wie in Abbildung 3 illustriert.
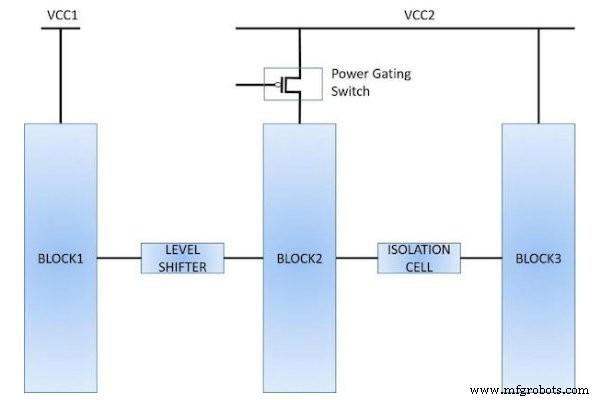
Designer müssen auch passende Device-Selektion über Domains hinweg sicherstellen – beispielsweise Thick-Oxide-Transistoren für High-Voltage Supplies –, um Bias Temperature Instability (BTI) und andere Degradationsmechanismen zu vermeiden.
Unified Power Format (UPF) für Transistor-Level Validierung
UPF bietet eine konsistente Power-Intent-Beschreibung durch den gesamten Design-Flow. Traditionelle UPF-Flows fokussieren auf Logic oder Gate Level, aber Calibre PERC erweitert UPF-Nutzung auf Transistor-Level, was automatisierte Checks für fehlende oder falsch verbundene Level Shifter, Electrical Overstress (EOS) Bedingungen, Floating Wells und mehr ermöglicht.
Lebensdauer-Reliability: Langzeit-Degradation verhindern
KI/ML-Chips müssen über ihre gesamte Design-Lebensdauer zuverlässig operieren. Themen wie BTI, EOS, Electromigration (EM) und Current-Density-Hotspots können Performance stillschweigend degradieren oder katastrophale Auslösung verursachen.
Beispielsweise wird ein High-Voltage Domain, der einen Thin-Oxide-Transistor ohne passenden Level Shifter ansteuert, nicht sofort versagen, aber über Zeit beschleunigt degradieren, was zu eventual Failure führt. Ähnlich schafft EM – getrieben durch Stromfluss – Voids und Hillocks, die Widerstand erhöhen oder Shorts verursachen. Foundries liefern EM-Limits basierend auf intendierten Applikationsumgebungen; Designer targeten typischerweise Worst-Case-Bedingungen und validieren gegen diese Limits.
Fehlende Reliability-Checks Pre-Silicon können zu Tape-Out-Verzögerungen, Verlust von Kundenvertrauen, negativen Markt-Reaktionen, Recalls oder sogar physischem Schaden in sicherheitskritischen Deployments führen.
Strategische Analyse und Management von KI/ML Reliability
Der rasante Fortschritt von KI/ML-Hardware hängt an rigoroser Reliability-Analyse. Fortgeschrittene EDA-Tools, die die einzigartigen Herausforderungen großer, komplexer KI/ML-Chips adressieren, ermöglichen Design Houses, Produkte zu liefern, die über ihre intendierte Lebensdauer zuverlässig performen und Vertrauen in KI-Ergebnisse über Industrien hinweg fördern.
Industry Articles sind eine Content-Form, die Industriepartnern erlaubt, nützliche Nachrichten, Botschaften und Technologien mit All-About-Circuits-Lesern zu teilen, auf eine Weise, wie es redaktionelle Inhalte nicht gut leisten. Alle Industry Articles unterliegen strengen redaktionellen Richtlinien mit dem Ziel, Lesern nützliche Nachrichten, technisches Expertenwissen oder Stories zu bieten. Die Standpunkte und Meinungen in Industry Articles sind die des Partners und nicht notwendigerweise die von All About Circuits oder seinen Autoren.
Internet der Dinge-Technologie
- Warum elektrische Sicherheit wichtig ist: Leben und Arbeit schützen
- Die Kernverantwortlichkeiten eines Reliability Engineers: Asset Performance schützen
- Der Schlüssel zum Zuverlässigkeitserfolg: Kulturwandel vor Technologie
- Die Kraft von Kernkompetenzen für nachhaltigen Geschäftserfolg
- Reliability Excellence: Die menschliche Seite meistern für transformativen Erfolg
- Wie Trending die Zuverlässigkeit von Elektromotoren verbessert
- Obligatorische Routinewartung: Anlagensicherheit & Langlebigkeit steigern
- Warum Rapid Machining die Effizienz in der modernen Fertigung steigert
- Lösungen freisetzen: Wie Ursachenanalyse nachhaltigen Erfolg fördert
- Warum jedes Unternehmen einen robusten Notfallplan braucht