



Analog In-Memory Computing: Energieeffiziente Edge AI Inferenz
Machine Learning und Deep Learning sind nun in alltägliche Technologie verwoben. Von Natural Language Assistenten bis zu Echtzeit-Objekterkennung treibt AI eine wachsende Anzahl an Consumer und Industrial Devices an. Doch die meisten dieser Applikationen verlassen sich auf Cloud-basierte Inferenz Engines – eine Architektur, die Bedenken zu Privatsphäre, Stromverbrauch, Latenz und Kosten aufwirft.
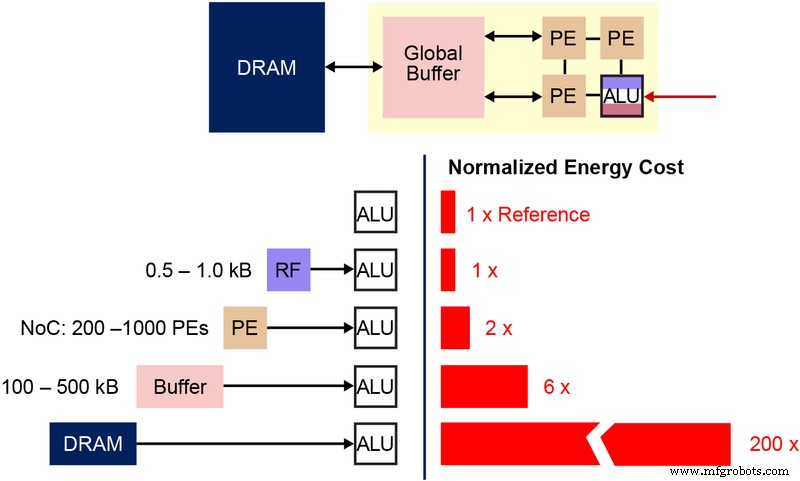
AI lokal auf dem Edge zu deployen, kann diese Probleme eliminieren. Die Haupthürde ist der Memory-getriebene Power Drain konventioneller digitaler Neural Network Acceleratoren. Wenn Weights und Activations aus DRAM oder SRAM gefetched werden, verbraucht die Data Movement allein zwei bis drei Größenordnungen mehr Energie als die Arithmetik selbst. Analog In-Memory Computing tacklet diesen Flaschenhals, indem es Multiply-Accumulate (MAC) Operationen direkt innerhalb eines Non-Volatile Memory Arrays ausführt.
Cloud-basierte AI: Die Pain Points
Wenn ein Edge Device Raw Data an einen Remote Server forwardet, entstehen mehrere Issues:
- Privatsphäre & Sicherheit – Persönliche oder vertrauliche Informationen werden in Rechenzentren übertragen und gespeichert.
- Unnötiger Stromverbrauch – Jedes Bit, das über Radio gesendet, in der Cloud gespeichert und re-retrieved wird, verbrennt Energie.
- Latenz für Small-Batch Inferenz – Responses können über 100 ms dauern, was für Nutzer wahrnehmbar ist.
- Data Economy Ineffizienz – Sensoren generieren massive Streams; alles hochzuladen ist weder ökonomisch noch nachhaltig.
Um diese Herausforderungen zu überwinden, wird ein trainiertes Model zuerst auf einer High-Performance Plattform (Cloud, GPU Farm, etc.) gebaut. Die resultierenden Weights werden dann auf eine Lightweight Inference Engine gemappt, die die Computation lokal ausführt.
Die MAC-lastige Natur Neuronaler Netze
Selbst lightweight Models werden von MACs dominiert. Beispielsweise enthält MobileNet-v1 mit 224×224 Input 4,2 Millionen Parameter und erfordert 569 Millionen MACs pro Inferenz. Die Multiplikation und Akkumulation werden in einem dichten Matrix-Vektor Produkt durchgeführt.
Warum Digital Computing struggelt
In einem konventionellen Accelerator werden Weights und Activations in DRAM/SRAM gespeichert und müssen in eine Arithmetic Logic Unit (ALU) gefetched werden. Abbildung 3 illustriert den Memory Bottleneck: Die Energie für Data Movement (50–100 pJ pro Transfer) überragt die 250 fJ pro MAC Operation. Selbst mit aggressiven Data-Reuse Techniken imposiert die Von Neumann Architektur ein hartes Limit auf Power Efficiency.
Analog In-Memory Computing zur Rettung
Indem Computation in das Memory Array selbst eingebettet wird, verschwindet der Bedarf, Weights zu shuttlen. Der verbleibende Data Transfer limitiert sich auf das Input Signal, typischerweise ein Sensor Output. Flash Cells, die im Sub-Threshold Regime operieren, konsumieren Sub-Nanoamp Ströme, was Active Power vernachlässigbar macht. Im Standby behalten die Non-Volatile Cells Daten ohne jeglichen Power Draw.
Die memBrain™ Plattform von Silicon Storage Technology (ein Microchip Unternehmen) exemplifiziert diesen Ansatz. Aufgebaut auf SuperFlash® (ESF3) Memory Technology, kann jedes Bitcell auf eine präzise Threshold Voltage (Vt) programmiert werden, was einen Conductance etabliert, der ein Weight repräsentiert. Wenn eine Input Voltage appliziert wird, gleich der Strom durch die Zelle dem Produkt aus Input und gespeichertem Weight.
Multi-Level Memory Architektur
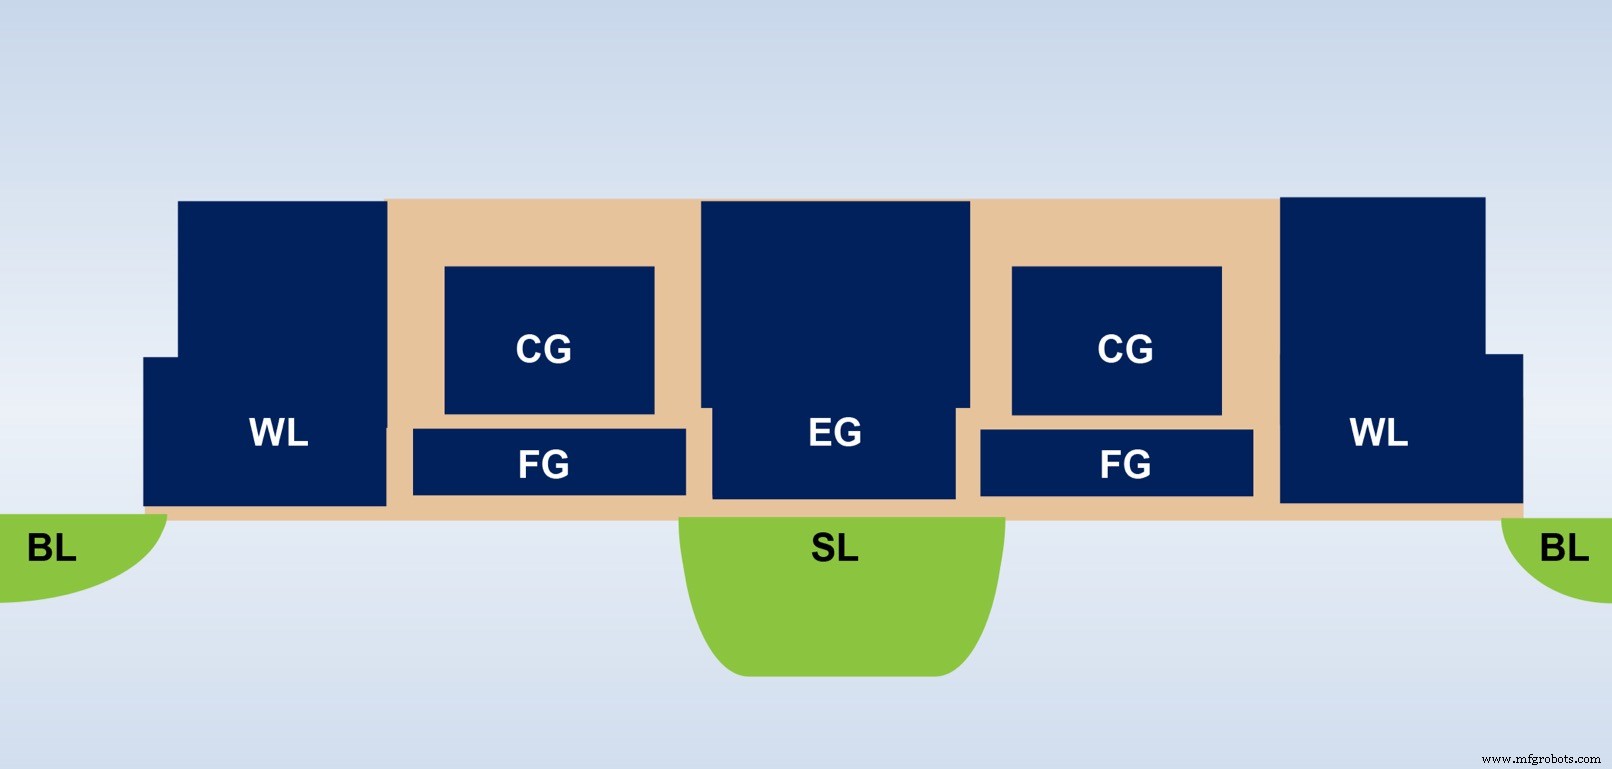
Abbildung 4 zeigt den Querschnitt einer ESF3 Bitcell. Die Zelle umfasst fünf Terminals – Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) und Bitline (BL). High-Voltage EG programmiert das Floating Gate, während Low-Voltage Biasing auf den anderen Terminals die Zelle liest oder schreibt.
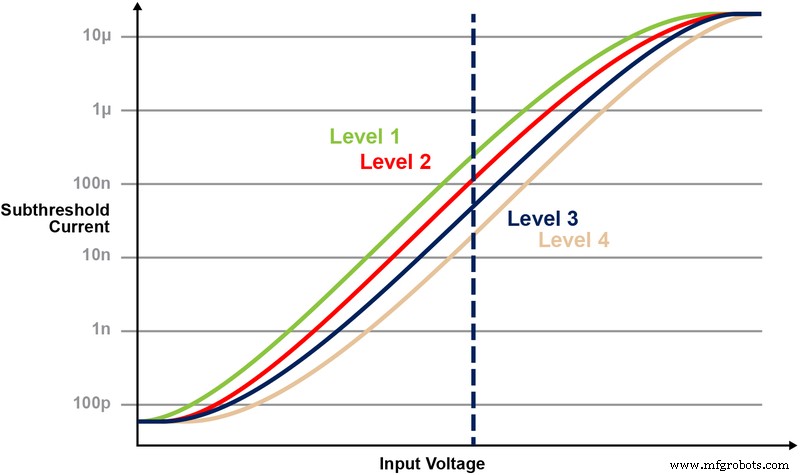
Feingranulares Programmieren tuned das Floating-Gate Vt, um eine spezifische I-V Kurve zu produzieren. Abbildung 5 demonstriert ein 2-Bit Beispiel, wo vier distincte Vt Levels vier separate Stromantworten ergeben, wenn eine feste CG Voltage appliziert wird.
MAC im Memory Array
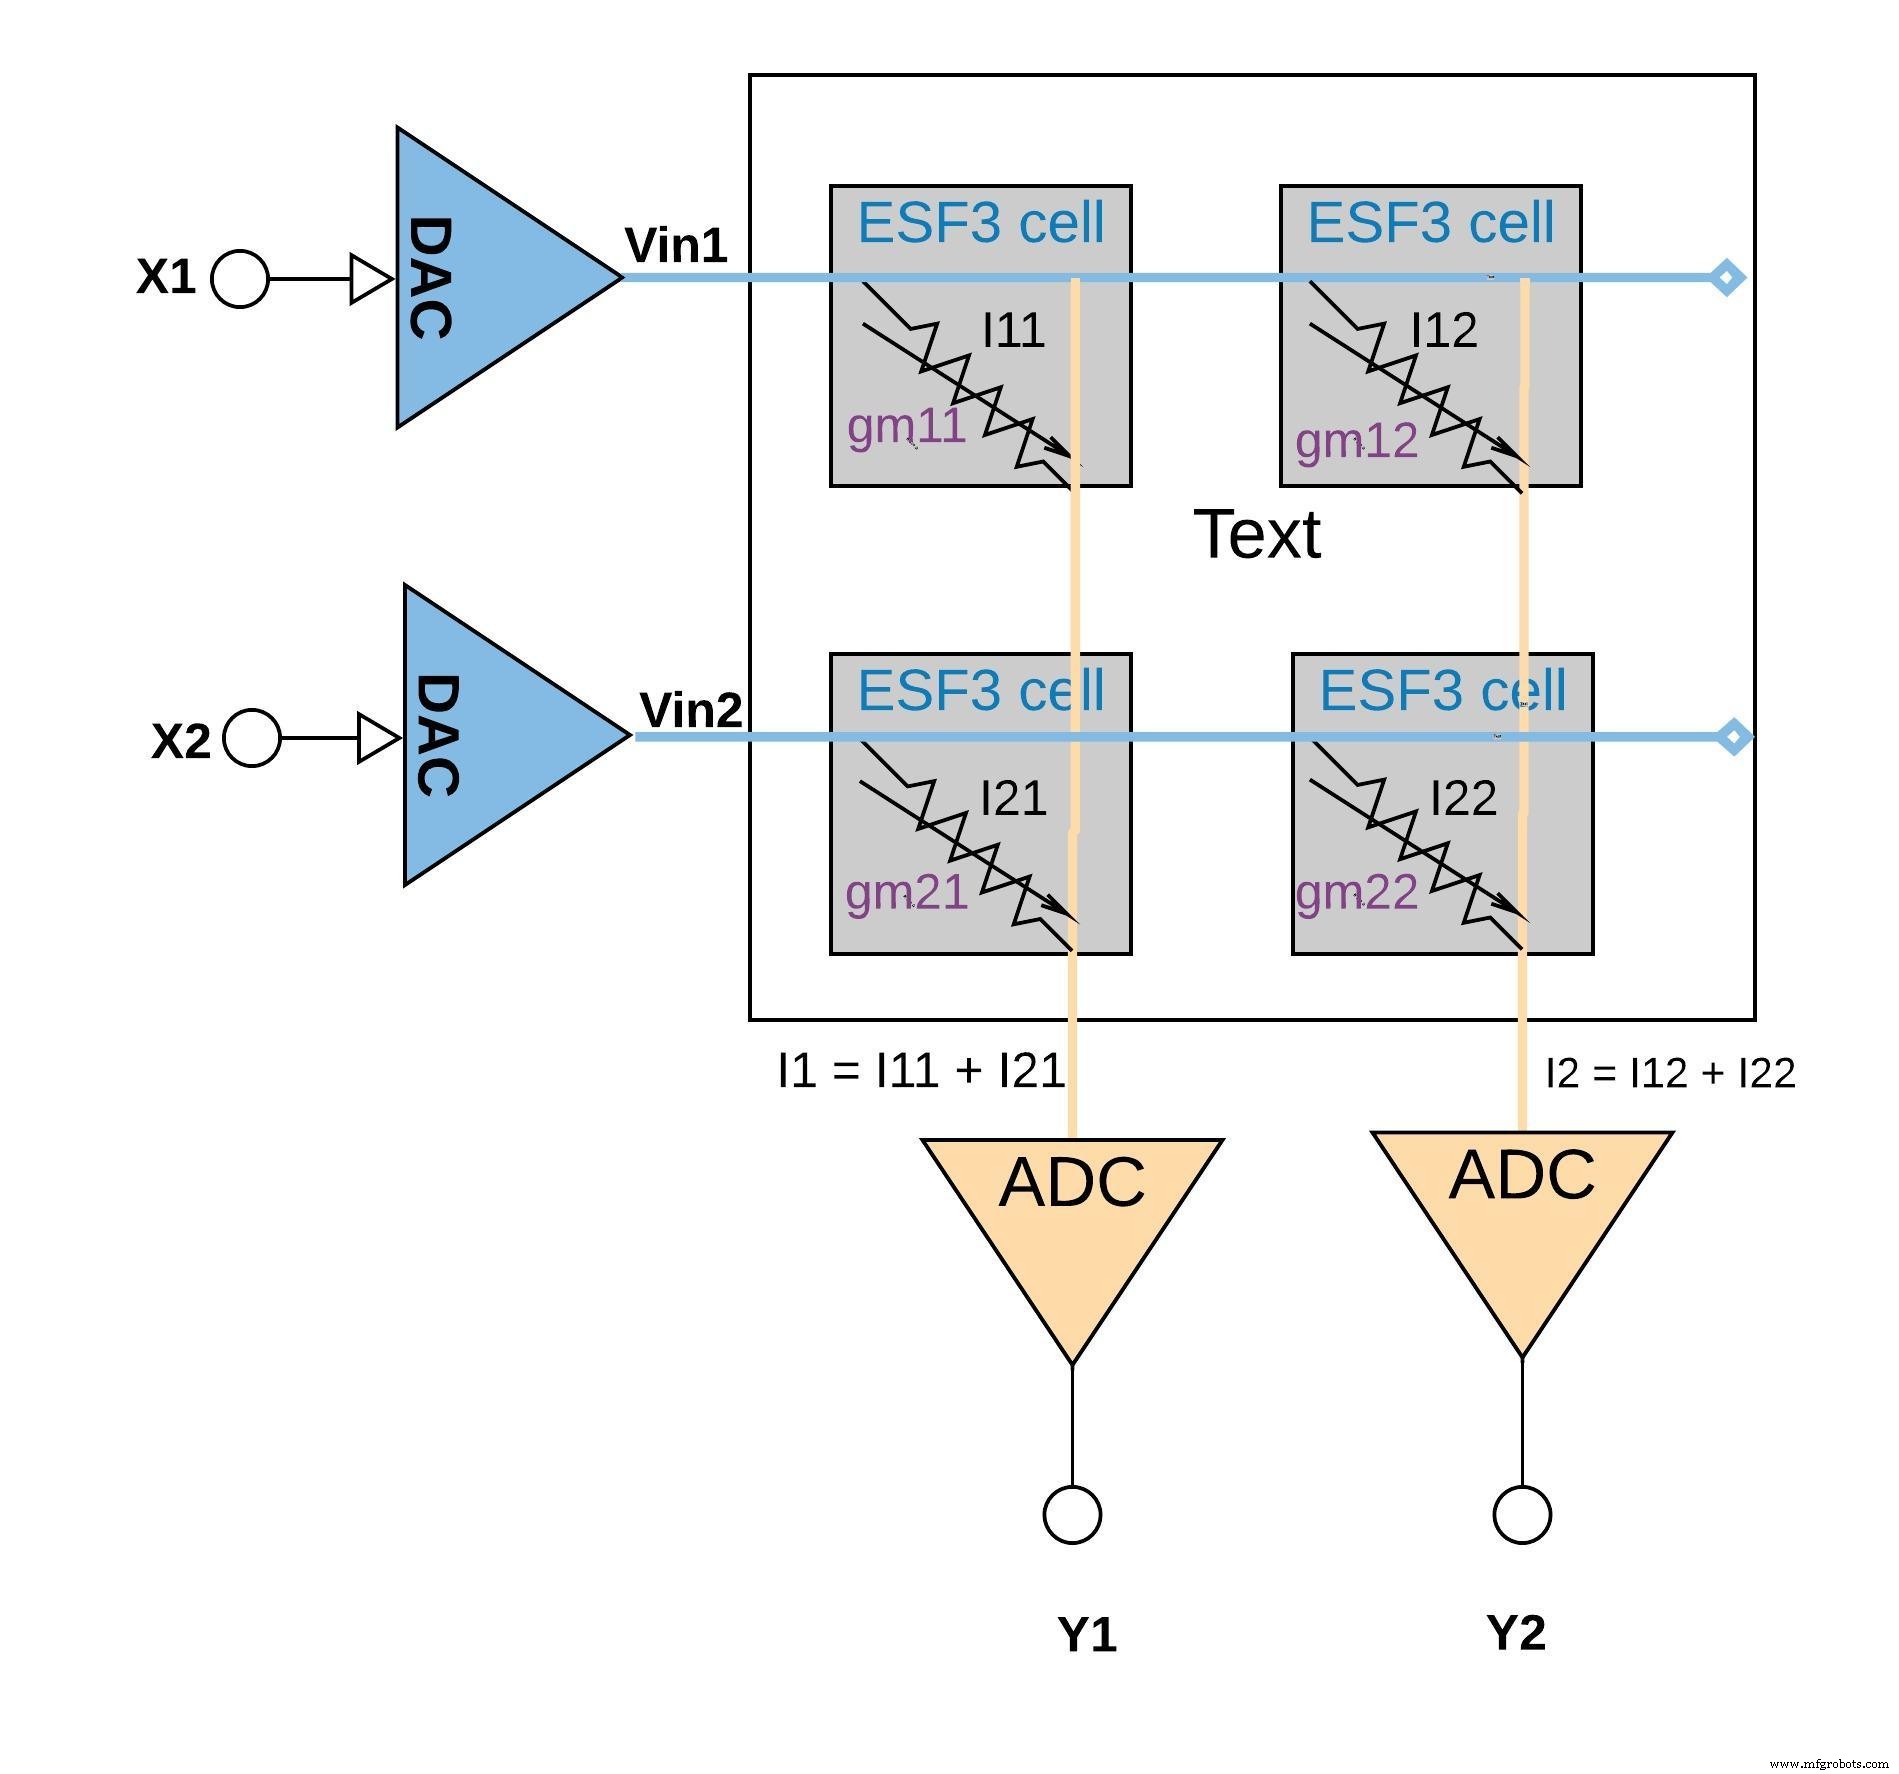
Jede Zelles Conductance gm verkörpert ein trainiertes Weight. Der Strom Iout = gm · Vin implementiert den Multiply Step. Durch Parallel-Verdrahtung vieler Zellen summieren sich die Column Ströme natürlich, was die Accumulate Operation liefert. Abbildung 6 visualisiert ein 2×2 Array, das zwei MACs und eine Accumulation ausführt.
Auf größerer Skala kann eine Weight Matrix auf ein einzelnes Memory Array gemappt werden. Abbildung 7 zeigt das Matrix Layout für einen Fully Connected Layer.
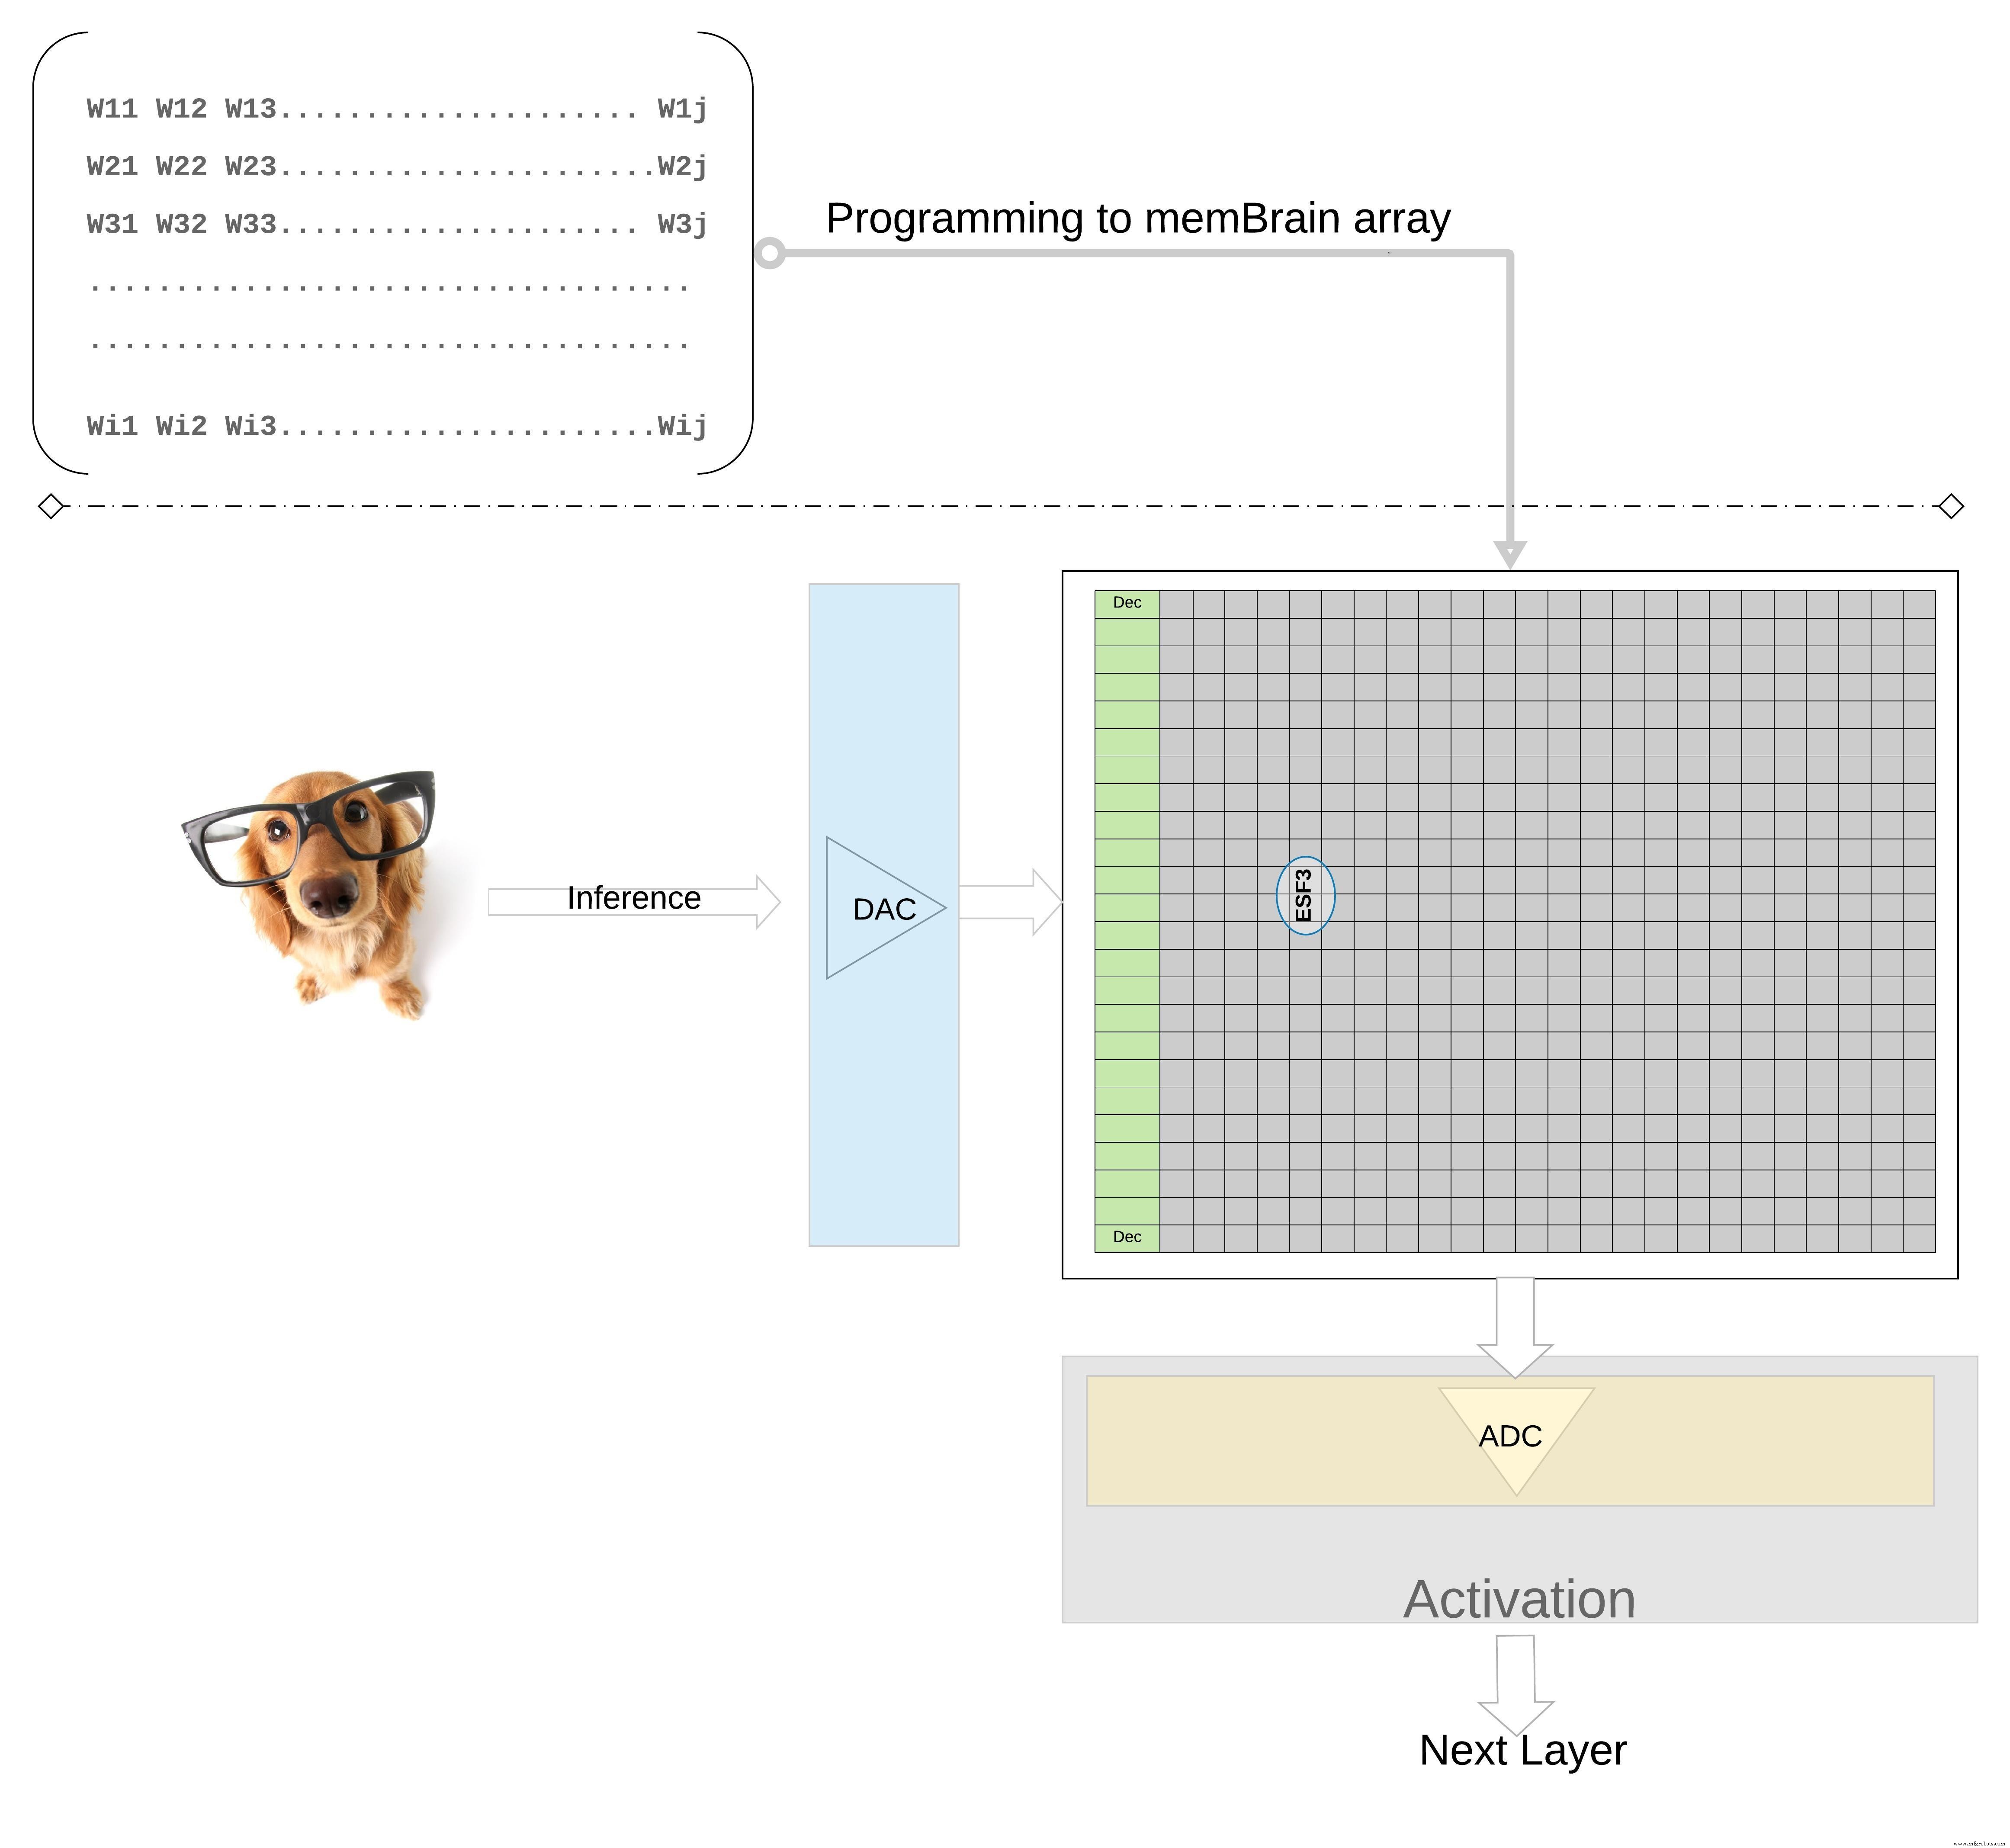
Der Inference Flow ist straightforward: Sensor Daten werden digitalisiert, via DAC in analoge Voltage konvertiert, in das Array eingespeist, und die resultierenden Column Ströme werden via ADC für nachfolgende Activation und Pooling Stages digitalisiert.
Modularität und Skalierbarkeit
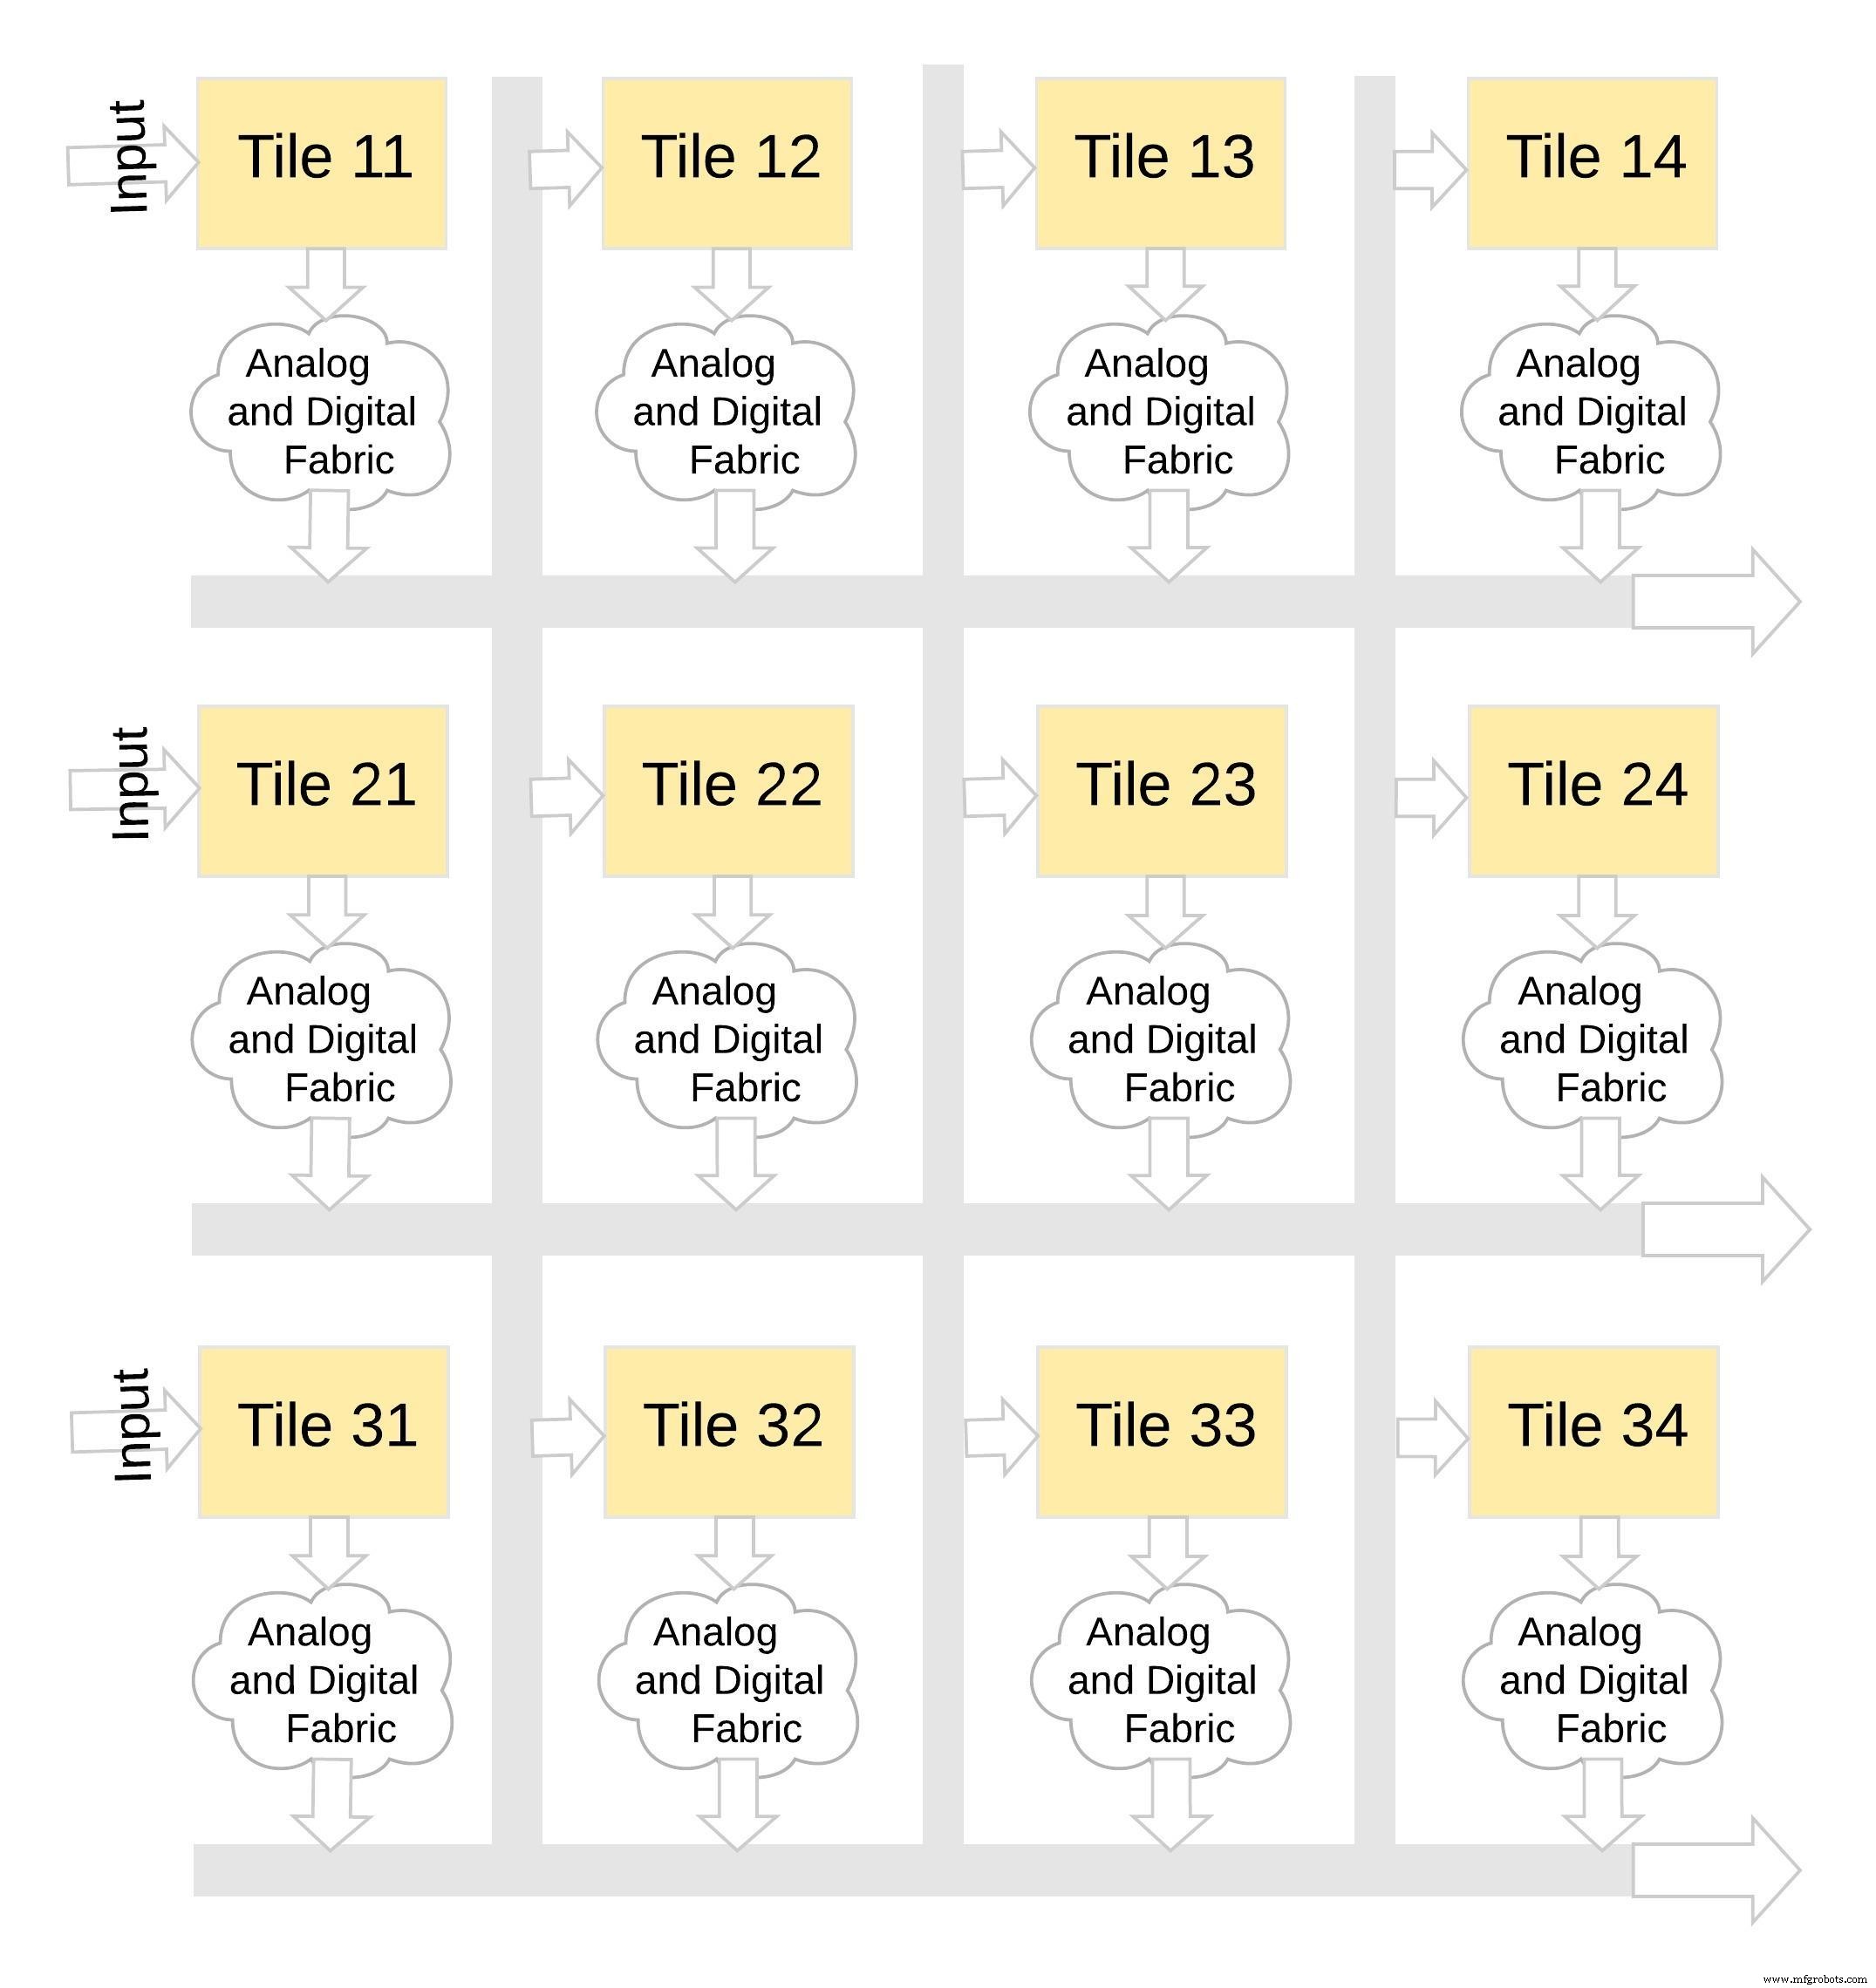
memBrain Tiles sind designed zu stacken. Abbildung 8 zeigt eine 3×4 Konfiguration, wo multiple Tiles einen gemeinsamen Analog-Digital Interconnect teilen. Daten bewegen sich über Tiles via Shared Bus, was den Bau tiefer Netzwerke ohne einzelnes monolithisches Die ermöglicht.
Software Development Kit (SDK)
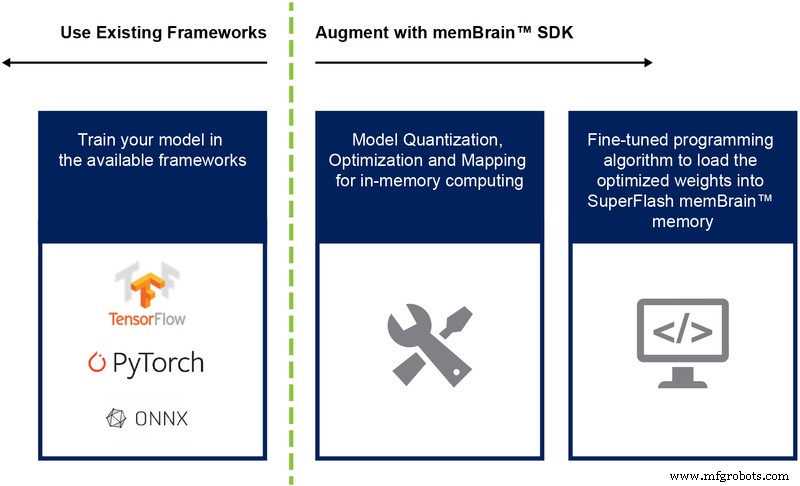
Das begleitende SDK ist Framework-agnostisch. Ob Sie in TensorFlow, PyTorch oder einer anderen Library trainieren, das SDK handhabt Model Quantisierung, Mapping und Deployment zur memBrain Hardware. Abbildung 9 skizziert den Workflow von Training zu Inferenz.
Kernvorteile
- Ultra-low Power – In-Memory Compute eliminiert Data Movement, Flash Cells operieren Sub-Threshold, und kein Standby Power wird benötigt. Die Architektur nutzt auch Sparsity aus, da Zero Weights oder Inputs Zellen idle lassen.
- Kompakter Footprint – Die 1,5-Transistor Split-Gate Zelle speichert einen 4-Bit Wert, während ein 6-Transistor SRAM 24 Transistoren für dieselben Daten bräuchte. Das Resultat ist ein dramatisch kleinerer Die Area.
- Reduzierte Development Cost – Durch Nutzung reifer Flash Prozesse und Vermeidung ultra-dichter Geometrien werden Mask Set Kosten und Lead Times signifikant gesenkt im Vergleich zu ASICs für Edge AI.
Edge AI verspricht transformative Applikationen, aber Power und Cost bleiben limitierende Faktoren. Analog In-Memory Computing, gestützt auf bewährte Multi-Level Flash Technologie, bietet einen praktischen, Low-Cost Pfad, um intelligente Inferenz direkt zum Sensor zu bringen.
Eingebettet
- Wie Edge Computing Enterprise IT transformieren kann: Eine ausgewogene Perspektive
- Warum Cloud Computing IT Teams stärkt
- Edge Computing entmystifiziert: Praktische Use Cases in Transport, Utilities und Manufacturing
- Edge Computing: 5 Fallstricke – und wie man sie meistert
- IIoT-Daten nutzen, um Profitabilität in der Lean Manufacturing zu steigern
- Edge Computing: Der Katalysator, der Industry 4.0 vorantreibt
- Wie Stromausfälle Ihre Netzteile gefährden – und wie Sie sie schützen
- 6 überzeugende Gründe für Edge Computing
- Edge Computing & 5G: Treiber der Unternehmens-Transformation
- Wie kleine Fertigungsbetriebe kosteneffizient digitale Lösungen nutzen können