



Multicore-Programmierung & Debugging meistern: Strategien für Performance & Reliability
In diesem Artikel untersuchen wir die Evolution von Multicore-Prozessoren, ihre wachsende Prävalenz und die Design-, Performance- und Debugging-Überlegungen, die sie begleiten.
System-Performance
Performance-Gewinne in Embedded-Systemen können durch raffinierte Compiler-Optimierungen, effiziente Hardware-Architekturen und zunehmend parallele Ausführung über mehrere Kerne erzielt werden. Während clevere Compiler-Algorithmen zusätzliche Geschwindigkeit aus Single-Threaded-Code quetschen können, ist die langjährige Annahme, dass Taktfrequenzen sich alle paar Jahre verdoppeln, unhaltbar geworden. Die moderne Performance-Grenze liegt im niedrigen einstelligen Gigahertz-Bereich, was Parallelismus zum einzig gangbaren Pfad für Skalierung macht.
Parallelismus
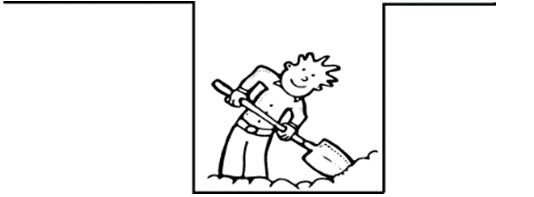
Nicht alle Tasks sind gleichermaßen für Parallelisierung geeignet. Eine einzelne Person muss ein tiefes Loch bohren, daher beschleunigt das Hinzufügen weiterer Arbeiter an diesem Loch den Job nicht; im Gegenteil, es kann den Fortschritt behindern. Umgekehrt ist das Ausheben eines Grabens hochparallel: Mehrere Arbeiter können nebeneinander graben, jeder deckt einen Bruchteil der Gesamtanstrengung ab.
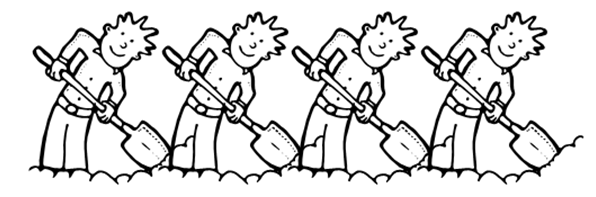
Diese Illustration zeigt MIMD (Multiple Instruction, Multiple Data), wo jeder Arbeiter (Kern) distinkte Operationen ausführen kann. Mit vier unabhängigen Arbeitern könnte ein Task, der einen Kern eine volle Minute braucht, in etwa 15 Sekunden fertiggestellt werden.
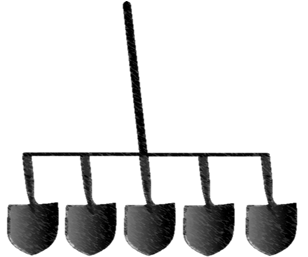
Im Kontrast dazu führt SIMD (Single Instruction, Multiple Data) die gleiche Instruktion über viele Datenelemente simultan aus. SIMD ist ideal für Workloads mit regelmäßigen, wiederholten Operationen – wie Bildfilterung oder Vektormathematik – aber es fehlt Flexibilität für General-Purpose-Computing.
Diese Überlegungen untermauern den Aufstieg von Multicore-Prozessoren: Durch Einbetten mehrerer vollständiger CPU-Subsysteme auf einem einzelnen Die können Designer Performance linear skalieren, provided die Software geschrieben ist, um den Parallelismus auszunutzen.
Verschiedene Typen von Multicore-Processing
Prozessoren können Kerne auf verschiedene Weisen kombinieren, was beeinflusst, wie Workloads verteilt werden und wie Kerne kommunizieren.
Homogenes Multicore
Zwei oder mehr identische Kerne, jeder mit eigenen Registern, funktionalen Einheiten und oft privaten L1-Caches. Kernkommunikation erfolgt typischerweise durch Shared Memory oder Mailbox-Mechanismen. Da jeder Kern vom gleichen Typ ist, kann das gleiche Binary auf jedem von ihnen laufen.
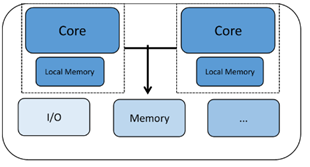
Heterogenes Multicore
Ein Mix verschiedener Kerntypen, jeder optimiert für eine bestimmte Workload. Zum Beispiel könnte ein Bluetooth-Controller einen Kern für Protokoll-Handling dedizieren, während ein zweiter Kern Higher-Level-Application-Logic managt. Diese Architektur ist in Mobile SoCs und industriellen Controllern verbreitet.
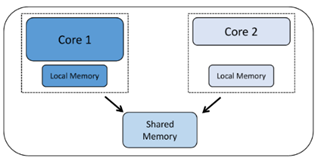
Kernverteilungsmuster unterscheiden Multicore-Designs weiter:
Symmetric Multiprocessing (SMP)
Mehrere identische Kerne führen das gleiche Binary aus, koordiniert durch ein Echtzeit-Betriebssystem (RTOS). Der Scheduler verteilt Arbeit über Kerne, und das Binary wird für einen einzelnen Kerntyp kompiliert.
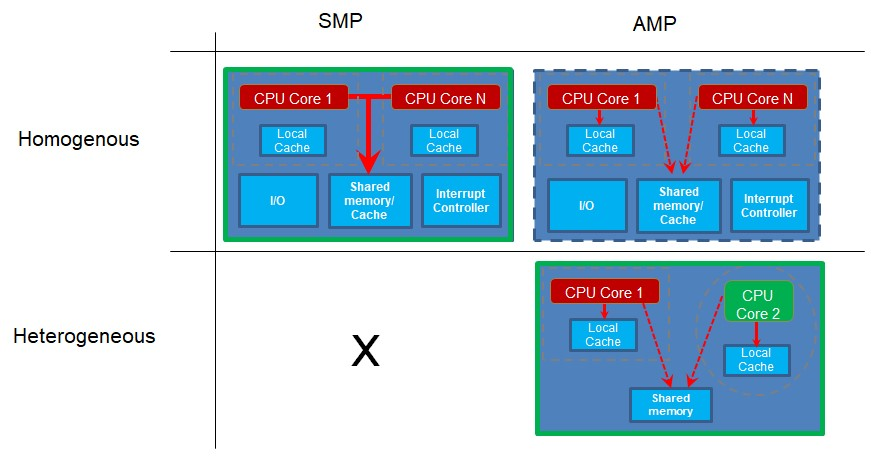
Asymmetric Multiprocessing (AMP)
Jeder Kern führt sein eigenes dediziertes Binary aus. Kerne können homogen oder heterogen sein. Kommunikation ist optional und wird typischerweise via Shared Memory oder Messaging-Primitiven gehandhabt.
Da SMP ein einzelnes Binary erfordert, erzwingt es homogene Kerne. AMP kann auf sowohl homogenen als auch heterogenen Systemen implementiert werden, was es ideal für Anwendungen macht, die distinkte, spezialisierte Workloads benötigen.
Gründe für Multicore-Nutzung
Da Moores Law verlangsamt, ist der effektivste Pfad zu höherer Performance, mehr Kerne auf ein Die zu packen. Während Taktgeschwindigkeiten im niedrigen einstelligen GHz-Bereich plateauiert sind, steigen Transistordichten weiter, was reichere Interconnects und größere On-Chip-Caches ermöglicht. Multicore-Designs erschließen das volle Potenzial dieser Densifizierung.
Heterogenes AMP ist besonders mächtig für Echtzeit- und Throughput-zentrierte Workloads. Durch Isolieren zeitkritischer Funktionen auf einem dedizierten Kern können Designer strikte Latenzgarantien erfüllen, ohne gesamtem Systemdurchsatz zu kompromittieren. Diese Separation vereinfacht auch Zertifizierung, weil die Echtzeit-Komponente unabhängig von der Application Logic verifiziert werden kann.
Herausforderungen bei Multicore-Nutzung
Die Adoption einer Multicore-Architektur führt eine Reihe von Software- und Systemherausforderungen ein:
- Task Granularität – Eine monolithische Applikation kann oft nicht effizient mehrere Kerne nutzen. Entwickler müssen Code in unabhängige Tasks refaktorisieren, die concurrent laufen können. Schlechtes Thread-Design kann zu Unterauslastung oder Kontention führen.
- Synchronisations-Flaschenhälse – Shared Data Structures und I/O-Geräte erfordern Locks (Mutexes, Spinlocks, Read-Write Locks, etc.). Über-aggressives Locking oder hohe Kontention kann Arbeit serialisieren und parallele Gewinne negieren.
- Load Imbalance – Wenn ein Kern seine Arbeit früh fertigstellt während andere hinterherhinken, repräsentiert der idle Kern verschwendete Compute-Zyklen. Große Jobs in kleinere, gleichmäßig große Chunks zu zerlegen ist essenziell.
- Echtzeit-Constraints – In SMP-Systemen muss der RTOS-Scheduler Latenz und Throughput balancieren. Die Wahl zwischen Data-Partitioning (jeder Thread verarbeitet einen Datenblock) und Function-Partitioning (jeder Thread führt eine distinkte Pipeline-Stage aus) hängt vom Workload-Profil ab.
Debugging in Multicore-Umgebungen
Effektives Debugging hängt von umfassender Sichtbarkeit aller Kerne ab:
- Koordinierte Kontrolle – Der Debugger sollte simultanes oder unabhängiges Halten, Steppen und Breakpoint-Setzen über Kerne erlauben.
- Multicore Trace – Trace-Daten von mehreren Kernen simultan zu erfassen verlangt High-Bandwidth-Transport (z.B. CoreSights SWD und TPIU Ports) und intelligentes Filtern, um Data Overload zu vermeiden.
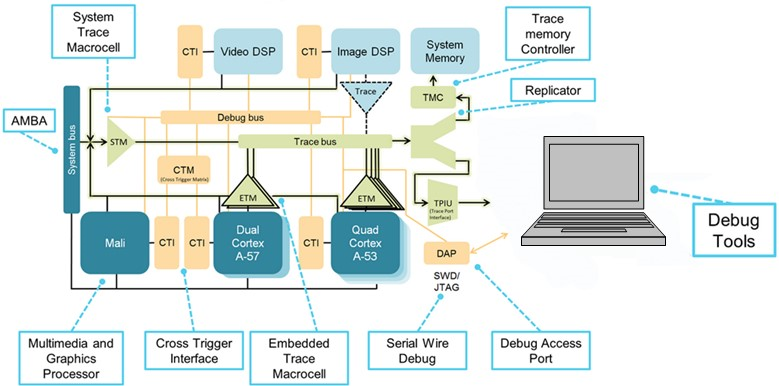
(Quelle: IAR Systems, Diagramm courtesy of Arm Ltd.)
Arms CoreSight Debug-Architektur integriert Cross-Trigger Interfaces (CTI) und eine Cross-Trigger Matrix (CTM), was dem Debugger erlaubt, jeden Kern in Reaktion auf Events von einem anderen Kern zu stoppen oder Aktionen zu triggern. Diese Fähigkeit ist essenziell für Diagnose von Race Conditions und Deadlocks.
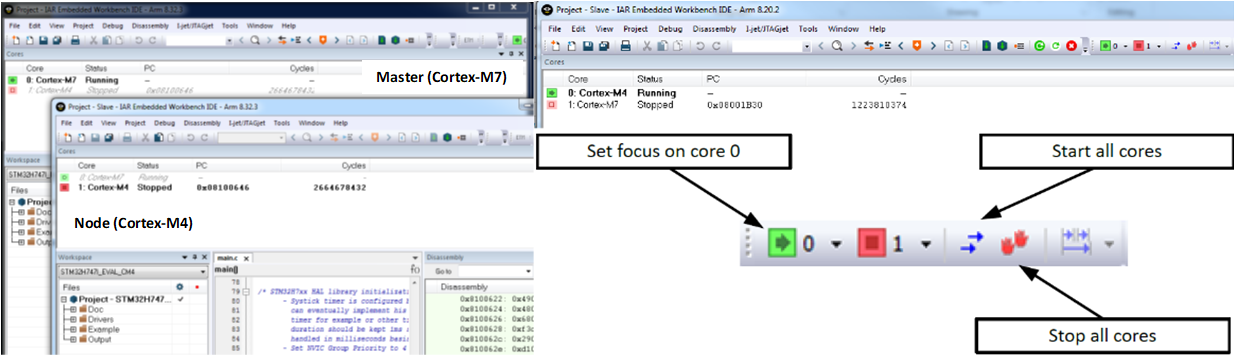
Der IAR Embedded Workbench C-SPY Debugger unterstützt sowohl SMP als auch AMP Konfigurationen. Für SMP spezifiziert der Nutzer die Kernanzahl und der Debugger verbindet automatisch jeden Kern. AMP Support erfordert zwei IDE Instanzen (Master und Node) wenn Kerne separate Binaries laufen.
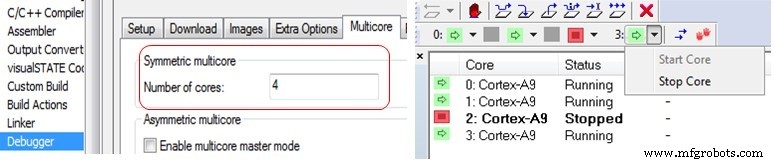
In der rechten Ansicht wird ein 4-Core Cortex-A9 SMP Cluster angezeigt: Kern 2 ist angehalten während die anderen weiter ausführen.
Für heterogene Systeme wie den ST STM32H745/755 (Cortex-M7 + Cortex-M4) startet der Debugger separate IDE-Fenster für jeden Kern. Jedes Fenster zeigt den Status seines Kerns und optional den des anderen, was Entwicklern erlaubt, Inter-Core-Interaktionen in Echtzeit zu beobachten.
Zwei CTIs (System-Level, Cortex-M4, und Cortex-M7) sind durch eine CTM verbunden, was dem Debugger feinkörnige Kontrolle über Breakpoints und Trace-Triggers gibt.
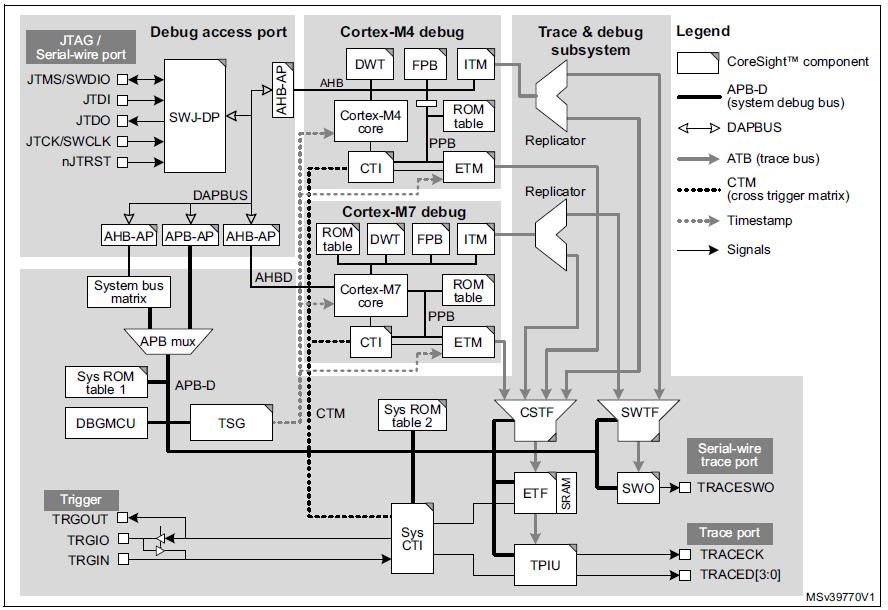
(Quelle: IAR Systems, Diagramm courtesy of STMicroelectronics from M0399 Reference Manual)
Typische Applikationen nutzen ein Shared-Memory-Interface und ein leichtes RTOS (z.B. FreeRTOS) zum Nachrichtenaustausch zwischen Kernen. Aus jeder Kernperspektive erscheint die Kommunikation als simples Task-Messaging, das die zugrundeliegenden Inter-Core-Mechaniken abstrahiert.
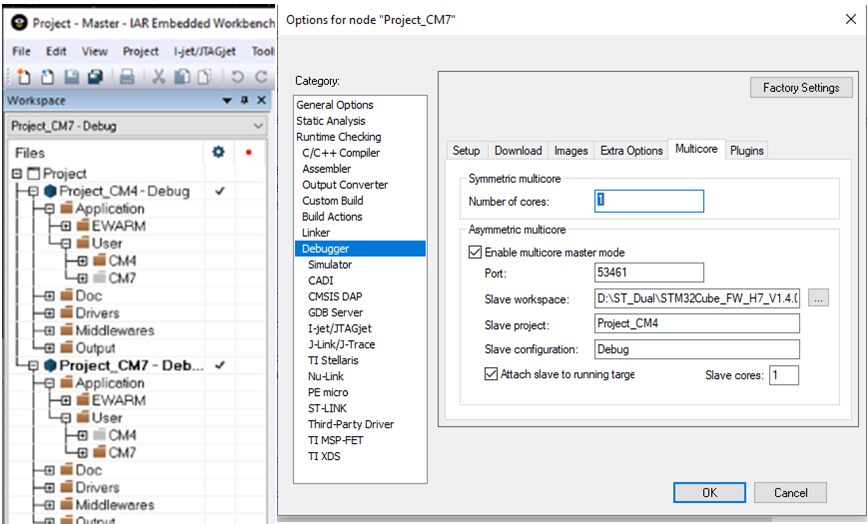
Im Workspace Explorer sind die beiden Projekte (Cortex-M7 und Cortex-M4) sichtbar, und der Nutzer kann Fokus zwischen ihnen wechseln. Das Master-Projekt startet die zweite IDE-Instanz automatisch, was AMP-Debugging vereinfacht.
Zusammenfassung
Multicore-Architekturen liefern die Performance, die nötig ist, während Moores Law verlangsamt, aber sie verlangen diszipliniertes Software-Design und raffinierte Debugging-Tools. Einmal konfiguriert, finden Entwickler, dass Multicore-Debugging überraschend unkompliziert ist, besonders im Vergleich zu den Herausforderungen, die oft von denen berichtet werden, die nur mit Mono-Core-Systemen gearbeitet haben.
Moderne Hardware und integrierte Software-Tooling machen es jetzt praktikabel, Multicore-Performance zu nutzen, während Reliability und Traceability gewahrt bleiben.
Hinweis: Figurenbilder sind von IAR Systems, sofern nicht anders angegeben.
 Aaron Bauch ist Senior Field Application Engineer bei IAR Systems und arbeitet mit Kunden im östlichen USA und Kanada. Aaron hat mit Embedded Systems und Software für Unternehmen einschließlich Intel, Analog Devices und Digital Equipment Corporation gearbeitet. Seine Designs decken einen breiten Anwendungsbereich ab einschließlich medizinischer Instrumentierung, Navigation und Bankensysteme. Aaron hat auch mehrere College-Level-Kurse unterrichtet einschließlich Embedded System Design als Professor an der Southern NH University. Mr. Bauch hält einen Bachelor in Electrical Engineering von The Cooper Union und einen Masters in Electrical Engineering von der Columbia University, beide in New York, NY.
Verwandte Inhalte:
- Software Timing Behavior in kritischen multicore-basierten Embedded Systems sicherstellen
- Multicore Systems, Hypervisors und Multicore Frameworks
- High-Performance Embedded Computing – Parallelism und Compiler Optimization
- Du denkst deine Software funktioniert? Beweis es!
- Software Tracing in field-deployed Devices
- Compiler in der alien Welt der funktionalen Sicherheit
Für mehr Embedded, abonnieren Sie Embeddeds wöchentlichen E-Mail-Newsletter.
Eingebettet
- SaaS & WiFi meistern: Wie IT Teams Cloud-Herausforderungen überwinden
- Wichtige Breakout-Boards für Raspberry Pi: I2C, UART, GPIO & Mehr – Kits, Header & Schutz
- 5Gs Top 5 Herausforderungen: Spektrum, Kosten, Abdeckung, Geräte, Sicherheit navigieren
- Multidimensionale Risiken in Luftfahrt & Verteidigung meistern
- 5G & IoT: Treiber für Next-Gen Supply Chain Resilienz
- IoT-Daten-ETL-Herausforderungen meistern für ROI-Steigerung
- Hartdrehen meistern: Herausforderungen mit fortschrittlicher Werkzeugtechnik überwinden
- Vier Schlüsselherausforderungen der Aerospace-&-Defense-OEM-Industrie
- Warum aktuelle Dokumentation kritisch ist: Vorteile und Herausforderungen für Ihr Unternehmen
- Hybrid-Fertigung: Wesentliche Vorteile, Herausforderungen und Branchenauswirkungen