



Den Data-Science-Lebenszyklus meistern: Ein umfassender Leitfaden
Seit dem Aufkommen von Big Data hat die moderne Informatik neue Fähigkeiten und Verarbeitungsleistungs-Benchmarks erreicht. Heutzutage ist es nicht ungewöhnlich, Anwendungen zu finden, die Datensätze von 100 Terabyte oder mehr erzeugen – was als Big Data gilt.
Bei solch großen Datenmengen ist es leicht, den Überblick zu verlieren und Zeit mit nutzlosen Inhalten zu verschwenden. Das sind zwei Gründe, warum es sehr wichtig ist, einer Methodik zu folgen, die die Effizienz und Wirksamkeit eines Big-Data-Projekts erhöht.
Abbildung 1. Moderne Data Science arbeitet mit sehr großen Datensätzen, auch bekannt als Big Data.
Der Data-Science-Lebenszyklus bietet einen Rahmen, der hilft, Big-Data-Projekte zu definieren, zu sammeln, zu organisieren, zu bewerten und bereitzustellen. Es ist ein iterativer Prozess, der aus einer Reihe von logisch aufeinanderfolgenden Schritten besteht und Feedback sowie Kurskorrekturen ermöglicht.
Wie sieht die Lebenszyklus-Sequenz aus? Die Antwort: Es gibt kein einzelnes universelles Modell, dem alle folgen. Viele Unternehmen, die Big-Data-Projekte durchführen, passen den Data-Science-Lebenszyklus an ihre Geschäftsprozesse an, meist mit zusätzlichen Schritten. Trotz dieser Vielfalt haben alle Modelle und Prozessflüsse gemeinsame Nenner. Dieser Artikel verwendet das CRISP-DM-Prozessmodell, eines der ersten und beliebtesten Data-Science-Lebenszyklus-Modelle.
Das CRISP-DM-Modell
CRISP-DM steht für Cross Industry Standard Process for Data Mining. Es wurde 1999 von ESPRIT, einem europäischen Programm zur Förderung der IT-Forschung, erstmals veröffentlicht. Das CRISP-DM-Modell besteht aus sechs Phasen, die das Big-Data-Projekt leiten. Es ermutigt Stakeholder, über das Geschäft nachzudenken, indem es wichtige Fragen zum Problem stellt und beantwortet.
Lassen Sie uns die sechs Phasen des CRISP-DM-Modells im Detail betrachten.
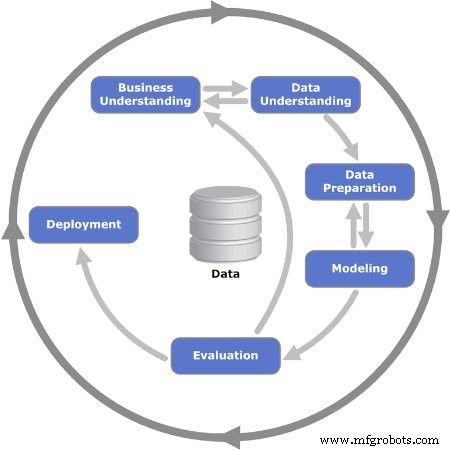
Abbildung 2. Die iterativen sechs Phasen des CRISP-DM-Modells. Bild mit freundlicher Genehmigung von Kenneth Jensen
Phase 1: Geschäftsverständnis
Die erste Phase besteht aus mehreren Aufgaben, die das Problem definieren und Ziele festlegen. Hier werden die Projektziele mit Fokus auf das Geschäft – oder anders gesagt: den Kunden – gesetzt. Normalerweise muss das Team, das an einem Big-Data-Projekt arbeitet, eine Lösung für den Kunden liefern, der ein anderer Bereich oder eine andere Abteilung im Unternehmen sein kann.
Sobald der geschäftliche Bedarf oder das Problem festgelegt ist, folgt die Definition von Erfolgsmesskriterien. Dies können Key Performance Indicators (KPIs) oder Service Level Agreements (SLAs) sein, die objektive Mittel zur Bewertung von Fortschritt und Abschluss bieten.
Als Nächstes muss die Geschäftssituation analysiert werden, um Risiken, Rollback-Pläne, Notfallmaßnahmen und vor allem Ressourcenverfügbarkeit zu identifizieren. Ein Projektplan wird erstellt, einschließlich Meilensteine und Ressourcen.
Phase 2: Datenverständnis
Sobald die Grundlagen in der vorherigen Phase gelegt sind, richtet sich der Fokus auf die Daten. Diese Phase beginnt mit einer ersten Definition der benötigten Daten und dokumentiert Details: Wo finden sie sich, Datentyp, Format, Beziehungen zwischen verschiedenen Datenfeldern usw.
Mit der ersten Dokumentation erfolgt der erste Datenerfassungslauf. Dies liefert einen nützlichen Schnappschuss der sich formenden Struktur. Dieser Informationsschnappschuss wird dann auf Qualität geprüft.
Phase 3: Datenvorbereitung
Die dritte Phase stärkt die vorherige und bereitet den Datensatz für die Modellierung vor. Datenfelder der ersten Erhebung werden weiter kuratiert, und als unnötig erachtete Informationen werden entfernt: Dies nennt man Datenbereinigung.
Zudem muss eine bestimmte Information möglicherweise aus anderen verfügbaren Informationen abgeleitet oder kombiniert werden. Kurz gesagt: Die Daten müssen verarbeitet werden, um ein finales Format zu erzeugen.
Phase 4: Modellierung
Die wichtigste Aufgabe in dieser Phase ist die Auswahl eines Algorithmus zur Verarbeitung der gesammelten Daten. In diesem Kontext ist ein Algorithmus eine Reihe von Sequenzschritten und Regeln, die in Computersoftware für Big-Data-Projekte programmiert sind.
Viele Algorithmen können verwendet werden: lineare Regression, Entscheidungsbäume, Support Vector Machines sind einige Beispiele. Die Wahl des richtigen Algorithmus zur Lösung des Problems erfordert Fähigkeiten, die erfahrene Data Scientists besitzen.
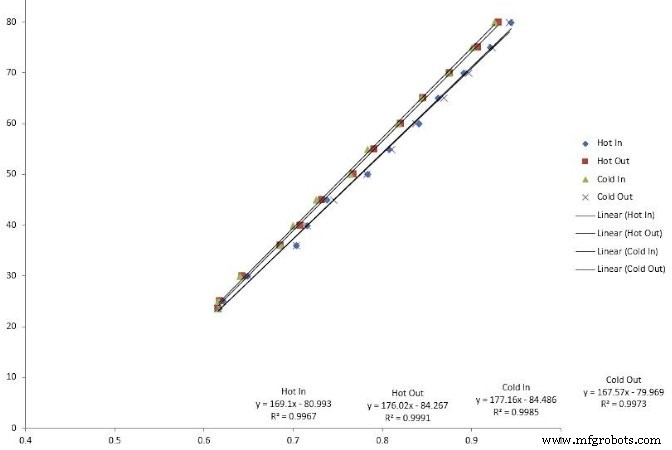
Abbildung 3. Lineare Regression ist ein Algorithmus-Typ, der in der Big-Data-Modellierung verwendet wird.
Der nächste Schritt ist die Implementierung des Algorithmus in der Softwareanwendung. Hier wird auch die Testphase geplant, die die Zuweisung spezifischer Datensätze für Test und Validierung umfasst.
Phase 5: Evaluierung
Manchmal ist es schwierig, von Anfang an einen Algorithmus auszuwählen. In diesem Fall führen Wissenschaftler mehrere Algorithmen aus und analysieren die Ergebnisse, um eine finale Entscheidung zu treffen. Nach Abschluss der Testphase werden die Ergebnisse auf Vollständigkeit und Genauigkeit überprüft.
Wichtiger noch: Dies ist die Gelegenheit zu bewerten, ob die Ergebnisse auf eine Lösung hinweisen. Im iterativen Modell ist dies ein entscheidender Schnittpunkt, an dem größere Iterationssequenzen gestartet oder die Entscheidung zur finalen Phase getroffen werden kann.
Phase 6: Bereitstellung (Deployment)
Hier geht das Projekt von der Testumgebung in die produktive Live-Umgebung über. Die Planung des Bereitstellungszeitplans und der Strategie ist sehr wichtig, um Risiken und potenzielle Systemausfallzeiten zu reduzieren.
Obwohl das Modell-Diagramm suggeriert, dass dies das Projektende ist, folgen noch zahlreiche Schritte: Monitoring und Wartung. Monitoring ist eine Phase engmaschiger Beobachtung (Hyper Care) unmittelbar nach dem Go-Live. Wartung ist ein semi-permanenter Prozess zur Instandhaltung und Weiterentwicklung der implementierten Lösung.
Big Data heißt nicht umsonst so: Es gibt eine riesige Menge an Daten zu durchforsten. Die Implementierung eines Data-Science-Lebenszyklus-Modells hilft zu entscheiden, welche Informationen wertvoll sind, um sie für Prozesse wie Predictive Maintenance zu behalten und zu nutzen.
Internet der Dinge-Technologie
- Sound nutzen: Data Transmission jenseits Smartphones transformieren
- Outsourcing von KI und Deep Learning im Gesundheitswesen: Schutz der Datenschutz
- Predictive Maintenance: Industry 4.0 für unterbrechungsfreie Produktion nutzen
- SIM-Lebenszyklus straffen: Digitale Strategie für CSPs
- Demokratisierung des Internet der Dinge: Next-Gen Satelliten-IoT bringt universelle, bezahlbare Konnektivität
- Den Wert von IoT-Daten erschließen: Sichere, insight-gesteuerte Strategien
- Fach-Experten mit Data Science befähigen für smartere Fertigungs-Insights
- Warum direkte Gerätekonnektivität der nächste Meilenstein im Industrial IoT ist
- Warum analoge Messungen die Anlagenleistung antreiben
- Tableau: Rohdaten in strategische Insights verwandeln