



KI-gestütztes Hindernisvermeidungssystem mit Arduino und Ultraschallsensoren
Komponenten und Zubehör
| Komponente | Menge | Hinweise |
|---|---|---|
| SparkFun Arduino Pro Mini 328 - 5V/16MHz | 1 | |
| Ultraschallsensor HC-SR04 | 1 | |
| SparkFun Dual H-Bridge Motor Treiber L298 | 1 | |
| DC Motor (60 RPM) | 2 | |
| Räder | 4 | |
| Jumper-Kabel | 1 | |
| Lötbare Steckplatine (Mini) | 1 | |
| Li-Ion Akku 7,2 V | 1 | |
| 9 V Blockbatterie | 1 | |
| 9 V Batterieclip | 1 | |
| PCBWay Custom PCB | 1 | |
| C&K Switches JS Series Schalter | 1 |
Benötigte Werkzeuge
- Lötkolben
- Lötzinn (bleifrei)
- Lötflussmittel
- Entlötpumpe
- Abisolierzange
- Heißklebepistole
- Doppelseitiges Klebeband
Apps und Online-Dienste
- Arduino IDE
Projekt: Hindernisvermeidender Roboter mit KI / Reinforcement Learning
Problemstellung
Ziel: Der Roboter soll in „N“ Episoden lernen, Hindernissen auszuweichen und die optimale Aktion (hier: „Rechts“) zu erlernen.
Verwendeter Algorithmus: Q-Learning
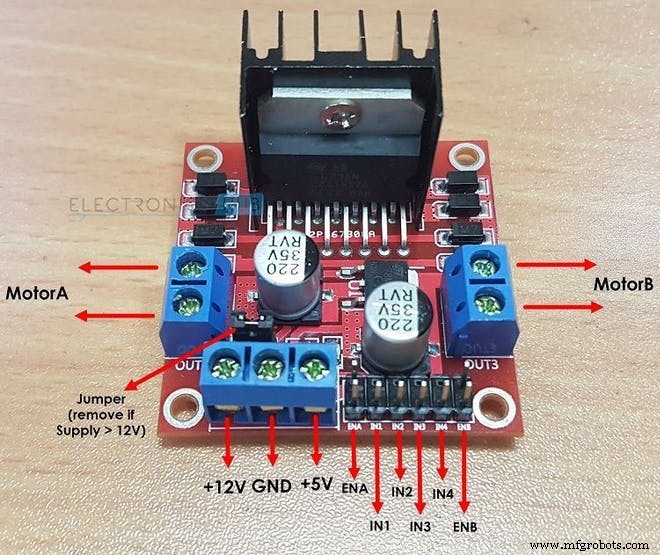
Wie der L298N zwei DC-Motoren antreibt
Wie der HC-SR04 Abstand misst

Wichtige Begriffe im Reinforcement Learning
- STATE (Zustand): Situation des Roboters. Hier zwei grundlegende Zustände: 1. Kein Hindernis nah, 2. Hindernis vorne. (Im Code 10 Zustände für komplexere Umgebung.)
- ACTION (Aktion): In Zustand 2 vier mögliche Aktionen: FORWARD, BACKWARD, LEFT, STOP. In Zustand 1 nur FORWARD.
int ACTIONS = [0,1,2,3]; // 0 = FORWARD, 1 = BACKWARD, 2 = STOP, 3 = RIGHT - NEXT STATE (Folgezustand): Zustand nach der Aktion. Entweder „CRASHED“ oder „SURVIVED“ (Startzustand).
- Q-TABLE / Q-MATRIX: Tabelle mit Zuständen (Zeilen) und Aktionen (Spalten). Initial 0,0. Unerwünschte Aktionen auf -1,0 setzen.
float Q[10][4] = {{0,0,0,0}, ...}; - TERMINAL STATE: Nicht vorhanden – Roboter lernt kontinuierlich.
- REWARD MATRIX: Belohnung für Aktionen. Positiv für gut, negativ für schlecht.
int REWARDS[10][4] = {{-10,-2,-1,10}, ...}; // FORWARD=-10, BACKWARD=-2, STOP=-1, RIGHT=+10 - ENVIRONMENT (Umgebung): Die Welt des Roboters (hier der Parcours).
Hyperparameter
- Learning Rate (Alpha) = 0,2: Wie stark neue Informationen alte überschreiben. 0 = kein Lernen, 1 = nur neuestes.
- Discount Factor (Gamma) = 0,9: Wichtung zukünftiger Belohnungen. 0 = kurzfristig, →1 = langfristig.
- Exploration Rate (Epsilon) = 0,75: Anteil zufälliger Aktionen (Exploration). Sinkt mit der Zeit, wird aber bei Unterschreiten eines Schwellenwerts zurückgesetzt, damit der Roboter lebenslang erkundet.
Q-Learning Algorithmus
- Q-Tabelle initialisieren (hier 0,0).
- Aktuellen Zustand s beobachten.
- Aktion a wählen (ε-greedy Policy): Mit Wahrscheinlichkeit ε zufällige Aktion (Exploration), sonst beste Aktion aus Q-Tabelle (Exploitation).
- Aktion ausführen, Belohnung r und neuen Zustand s' beobachten.
- Q-Wert aktualisieren:
Q_new = (1-α)*Q_old + α*(r + γ*max(Q(s',a')))(Bellman-Gleichung). - Zustand = neuer Zustand, wiederholen.

// Epsilon-Greedy Policy
PROB = RANDOM(EPSILON);
if (PROB <= EPSILON) { ACTION = random(0,4); FLAG = 2; } // Explore
else { ACTION = ARGMAX(Q, STATE); FLAG = 2; } // Exploit

// Q-Update
Q_OLD = Q_TABLE[S][A];
Q_MAX = MAX(Q_TABLE, NEXT_S);
Q_NEW = (1-LEARNING_RATE)*Q_OLD + LEARNING_RATE*(R + DISCOUNT_FACTOR*Q_MAX);
Q_TABLE[S][A] = Q_NEW;
Funktionsvideo
Siehe Video im Originalprojekt.
Arduino Code (Q-Learning)
/* Obstacle Avoiding Robot using Reinforcement Learning / AI
   Author: Varun Walimbe
   Algorithm: Q-Learning
   Hardware: Arduino Pro Mini, HC-SR04, L298N, 2x 60 RPM DC Motoren
*/
////////// ROBOT HARDWARE PARAMETER //////////
int TRIG_PIN = 7;
int ECHO_PIN = 8;
int duration;
float distance;
int M1 = 13, M2 = 12, M3 = 11, M4 = 10;
bool Obstacle = false;
int FLAG;

////////// Q-LEARNING PARAMETER //////////
float ALPHA = 0.1;
float GAMMA = 0.5;
float EPSILON = 0.90;
int REWARD;
int EPISODES = 100;
int STATE = 0;
int ACTION = 0;
float PROB;
bool ACTION_TAKEN = false;
int NEXT_STATE;
const int STATES = 10;
int ACTIONS[4] = {1,2,3,4};
const int NUMBER_OF_ACTIONS = 4;

float Q[STATES][NUMBER_OF_ACTIONS] = {
  {0,0,0,0},{0,0,0,0},{0,0,0,0},{0,0,0,0},{0,0,0,0},
  {0,0,0,0},{0,0,0,0},{0,0,0,0},{0,0,0,0},{0,0,0,0}
};

int REWARDS[STATES][NUMBER_OF_ACTIONS] = {
  {-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10},
  {-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10},{-10,-2,-1,10}
};

////////// Q-LEARNING UPDATE PARAMETER //////////
float Q_OLD, Q_NEW, Q_MAX;

void setup() {
  Serial.begin(9600);
  pinMode(TRIG_PIN, OUTPUT); pinMode(ECHO_PIN, INPUT);
  pinMode(M1, OUTPUT); pinMode(M2, OUTPUT); pinMode(M3, OUTPUT); pinMode(M4, OUTPUT);
  randomSeed(analogRead(A0));
  STATE = 0;
  Serial.println("TRAINING STARTET IN 5 SEKUNDEN:");
  delay(5000);
}

// Roboter-Bewegungsfunktionen
void Forward()  { digitalWrite(M1,LOW); digitalWrite(M2,HIGH); digitalWrite(M3,LOW); digitalWrite(M4,HIGH); }
void Backward() { digitalWrite(M1,HIGH); digitalWrite(M2,LOW); digitalWrite(M3,HIGH); digitalWrite(M4,LOW); }
void Left()     { digitalWrite(M1,HIGH); digitalWrite(M2,LOW); digitalWrite(M3,LOW); digitalWrite(M4,HIGH); }
void Right()    { digitalWrite(M1,LOW); digitalWrite(M2,HIGH); digitalWrite(M3,HIGH); digitalWrite(M4,LOW); }
void Stop()     { digitalWrite(M1,LOW); digitalWrite(M2,LOW); digitalWrite(M3,LOW); digitalWrite(M4,LOW); }

bool Obstacle_Avoider() {
  digitalWrite(TRIG_PIN, HIGH); delayMicroseconds(10); digitalWrite(TRIG_PIN, LOW);
  duration = pulseIn(ECHO_PIN, HIGH);
  distance = (duration/2)/29.1;
  Obstacle = (distance < 15);
  delay(10);
  return Obstacle;
}

// Q-Learning Hilfsfunktionen
float RANDOM(float EXPLORATION_PARAMETER) {
  float RANDOM_VARIABLE = random(0,100);
  return RANDOM_VARIABLE/100;
}
float DECAY(float PARAMETER) { return PARAMETER * 0.98; }
int GET_STATE() { return random(0,10); }

float MAX(float Q_Table[][4], int NEXT_S) {
  float MAX_VALUE = 0;
  for (int b=0; b<=3; b++) {
    if (Q_Table[NEXT_S][b] > MAX_VALUE) MAX_VALUE = Q_Table[NEXT_S][b];
  }
  return MAX_VALUE;
}
int ARGMAX(float Q_Table[][4], int S) {
  float MAX_VALUE = 0; int MAX_INDEX = 0;
  for (int u=0; u<=3; u++) if (Q_Table[S][u] > MAX_VALUE) { MAX_VALUE = Q_Table[S][u]; MAX_INDEX = u; }
  return MAX_INDEX;
}
void Update(float Q_TABLE[][4], int S, int NEXT_S, int A, int ACTIONS[], int R, float LEARNING_RATE, float DISCOUNT_FACTOR) {
  Q_OLD = Q_TABLE[S][A];
  Q_MAX = MAX(Q_TABLE, NEXT_S);
  Q_NEW = (1-LEARNING_RATE)*Q_OLD + LEARNING_RATE*(R + DISCOUNT_FACTOR*Q_MAX);
  Serial.print("Q VALUE: "); Serial.println(Q_NEW);
  Q_TABLE[S][A] = Q_NEW;
}

// HAUPTSCHLEIFE
void loop() {
  // TRAINING
  for (int I=0; I
Schaltplan
Fritzing-Datei: obstacle_avoiding_robot_using_ai_DcoMCWIOFm.fzz
LED-Helligkeit per PWM und Taster am Arduino Mega steuern
Modellbahn DCC-Zentrale selbst bauen mit Arduino – Kostenlose App inklusive
Herstellungsprozess
- Arrow Electronics startet AI Experience Tour mit Intel, Microsoft, Nvidia
- Visionsbasierter Hindernis-vermeidender Mobiler Roboter auf Raspberry Pi
- Bosch stellt KI‑gestützte Fertigungslösung auf der Hannover Messe vor
- Künstliche Intelligenz im Retail: Bewiesene Vorteile, kein Hype
- Kubernetes befähigt KI-Start-ups mit skalierbaren, containerisierten Lösungen
- Wie KI die Internet-of-Things-Landschaft transformiert
- Künstliche Intelligenz noch nicht bereit für Industrial-Control-System-Cybersicherheit
- KI sagt Quanten-Vorteil voraus: Neuronales Netz prognostiziert Systemverhalten
- KI-gestützte Verfolgung der Entwaldung im Amazonas
- KI-gestützte Robotik: Spitzenklasse intelligenter Maschinen