



FRACAS: Reliable Asset Performance freischalten
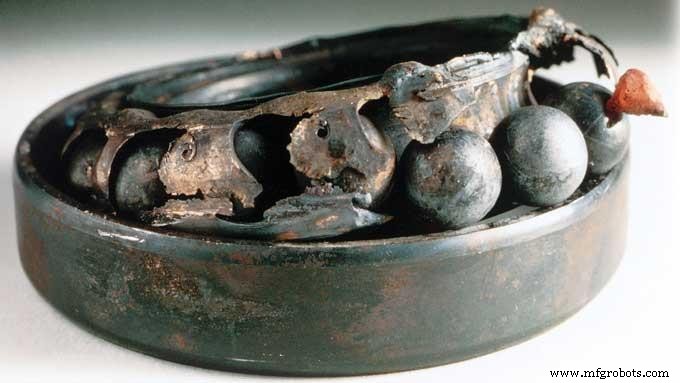
Reliability Engineering ist fundamental darauf ausgerichtet, Failures vorauszusehen und zu verhindern. Durch Katalogisierung jedes potentiellen Failure Modes können Sie Detection, Mitigation oder Prevention Strategies designen, die Probleme stoppen, bevor sie manifestieren.
Failure Reporting, Analysis, and Corrective Action System (FRACAS) ist eine strukturierte Methodik, die mögliche Asset Failures zurück zu ihren Root Causes mapped. Der resultierende Blueprint leitet Teams an, Issues prompt zu adressieren und rekurrente Probleme an ihrer Quelle zu eliminieren.
Ein robustes FRACAS Framework incorporiert Component Criticality über das System und relies auf erfahrene Planner, Maintenance Professionals und Operators, um jeden Failure Pathway zu enumerieren.
Failure verstehen
Failure ist jede Operating Condition, die vom Ideal abweicht. Es ist nicht auf Total Shutdowns limitiert; Operating in einem degraded State ist equally ein Failure. Bei einem kürzlichen Plant Visit wurde eine Maschine für höhere Speed retoolt. Während Operators den verbesserten Throughput feierten, verursachte der erhöhte Feed Rate Product Spillage an der nächsten Pumpe, was signifikanten Waste erzeugte. Also kann Failure Over-Performance bedeuten, die unbeabsichtigte Konsequenzen verursacht.
Beginnen Sie mit dem Aufbrechen des Systems in Subcomponents – bis hin zu Bolzen, Sensoren oder ersetzbaren Motoren. Cross-Referenzieren Sie Ihr Material Inventory System, ob es an CMMS gebunden oder standalone Tool ist, um Spare Parts für Corrective Actions zu bestimmen.
Recording und Reporting
Konsistente Dokumentation ist kritisch. Ein erfahrener Maintenance Manager sagte einmal: „You gotta write it down.“ Nutzen Sie strukturierte Tools – Projects, Spreadsheets oder spezialisierte Software – um Failure Data zu erfassen. Eine kaskadierende Hierarchie von Subcomponents und Failure Types offenbart Patterns; Repeat Failures surfacen schnell, enabling targeted Interventions.
Für einen visuelleren Ansatz erstellen Sie eine Cause-Map für jedes System. Ein simples Diagram der Maschine mit annotierten Failure Boxes hilft Stakeholdern außerhalb des FRACAS Teams, Issues auf einen Blick zu erfassen.
Root Cause Analysis
Mit einer umfassenden Failure List reviewed ein Subject-Matter Team Trends, leveraging Historical Data. Distinguieren Sie Chronic Failures von One-off Events; letztere bieten limitierten Lernwert. Parallel führen Sie eine Criticality Assessment durch – evaluieren Sie Repair Cost, Labor und Downtime Impact –, um zu entscheiden, wie tief Sie jeden Failure untersuchen.
In Lean/6-Sigma Kontexten informiert diese Analyse Inventory Decisions: Komponenten, die on-hand gehalten werden können vs. jene, die Just-in-Time geordert werden. Zum Beispiel: Eine Maschine, die bei 90 % Kapazität einen Monat operieren kann während auf Replacement gewartet wird, könnte 93 % Overall Plant Output yield – eine Verbesserung, die lohnenswert ist.
Corrective Actions
Dokumentieren Sie jede mögliche Corrective Action pro Failure: Replace, Repair oder in einigen Fällen „Run to Failure“ bis Root Cause adressiert ist. Assignieren Sie Cost Estimates covering Parts und Labor, und pre-populieren Sie Work Orders in Ihrem CMMS für Rapid Deployment bei Failure.
Anwendung des Pareto-Prinzips – Fokus auf die 20 % der Faults, die 80 % der Downtime verursachen – yields eine manageable Action List, die substanzielle Reliability Gains liefert.
System Integration und Kultur
FRACAS muss ein Living System sein: Repeatable, Scalable und Adaptable an neue Equipment, Technologies oder Personnel. Regelmäßig Corrective Action Efficacy reviewen und Analysis Group erweitern für frische Perspektiven. Broader Workforce educieren; frühe Involvement fostert Ownership und promotet Continuous Improvement Culture.
Während Failures random sein mögen, ermöglichen systematische Datenerfassung, Expertenanalyse und Cost-based Decision Making proaktive Detection, Delay oder Prevention. Über Zeit elevieren diese Practices, gekoppelt mit inklusivem Training, Asset Reliability und verstärken eine resiliente Operationelle Kultur. Remember: You want a FRACAS, not a fracas.
Gerätewartung und Reparatur
- Warum Mobile Wartung entscheidend ist – Fiix Gast im Asset Reliability @ Work Podcast
- Die Kernverantwortlichkeiten eines Reliability Engineers: Asset Performance schützen
- Der Schlüssel zum Zuverlässigkeitserfolg: Kulturwandel vor Technologie
- Human Resources: Das fehlende Glied zur Anlagenzuverlässigkeit
- Reliability Excellence: Die menschliche Seite meistern für transformativen Erfolg
- Wie Trending die Zuverlässigkeit von Elektromotoren verbessert
- Warum Reliability as a Service (RaaS) intelligente Predictive Maintenance antreibt
- Die fundamentale Architektur der IoT-Revolution
- Wie IIoT Asset-Monitoring-Systeme verbessert: Zuverlässigkeit & Effizienz steigern
- Warum Hydrauliksysteme für das moderne Engineering unverzichtbar sind