



Jenseits von Trial & Error: Bewährter Leitfaden für effektives Wartungs-Troubleshooting
Eine umfassende Ressource für Wartungsteams, die Troubleshooting von willkürlichen Fixes in einen systematischen, datengetriebenen Prozess verwandelt, der Ausfallzeiten reduziert und Zuverlässigkeit erhöht.
Inhaltsverzeichnis
- Was ist Troubleshooting?
- Strategien zur Schärfung Ihrer Troubleshooting-Skills
- Wartungssoftware für schnellere Resolution nutzen
- Kernaussagen
In der Wartungswelt fühlt sich Troubleshooting oft wie Kunst an – spontan, intuitiv, oft unvorhersehbar. Mit strukturierter Methodik wird es zur präzisen Wissenschaft, die Problemlösung beschleunigt, Produktionsverluste minimiert und Compliance unterstützt.
Was ist Troubleshooting?
Anlagenausfälle sind unvermeidlich, ob Förderband, Industriebohrer oder kritisches Asset. Troubleshooting ist die disziplinierte Praxis, ein nicht sofort offensichtliches Problem zu diagnostizieren. Der effektivste Prozess folgt einem Vier-Schritte-Zyklus: Problem identifizieren, Reaktion planen, Lösung testen, Resolution bestätigen. Diese Schritte werden wiederholt, bis die Root Cause eliminiert ist.
Problem identifizieren
Reaktion planen
Lösung testen
Wiederholen bis gelöst
Beispiel: Wenn ein Förderband unerwartet stoppt, ortet der Techniker zuerst die fehlerhafte Komponente, plant dann eine Reparatur – vielleicht Lager neu ausrichten oder schmieren – und testet den Fix. Besteht das Problem, wird das Teil getauscht, letztlich wird Funktionalität wiederhergestellt.
Wie wird Troubleshooting typischerweise in der Wartung durchgeführt?
Oft wird ein defektes Asset von Operatoren, Handbüchern und historischen Notizen untersucht, was zu einer Serie von Test-Fixes führt, bevor der Techniker zum nächsten Notfall abberufen wird. Dieser fragmentierte Ansatz – besonders wenn Aufzeichnungen auf Papier oder in unstrukturierten Spreadsheets geführt werden – schafft Verzögerungen und erhöht Fehldiagnose-Risiken.
Warum ist Troubleshooting in der Wartung wichtig?
Unerwartete Ausfälle sind der Grund, warum Wartung existiert. Während präventive und zustandsbasierte Strategien Risiko reduzieren, können sie ungeplante Ausfallzeiten nicht eliminieren. Robuste Troubleshooting-Prozeduren befähigen Teams, Probleme schnell zu diagnostizieren, zu korrigieren und Wiederholungen zu verhindern – schützen Produktivität, Sicherheit und regulatorische Compliance.
Menschliche Expertise bleibt essenziell, aber Technologie kann Datenerfassung, Analyse und Wissensaustausch straffen. Ein verfeinerter Troubleshooting-Workflow verwandelt Ausfallzeit in Chance für Continuous Improvement statt in kostentreibenden Albtraum.
Strategien zur Schärfung Ihrer Troubleshooting-Skills
Hier sind praktische Schritte, die die Troubleshooting-Fähigkeiten Ihres Teams erhöhen.
Anlagenleistung quantifizieren und Daten interpretieren
Tiefe Vertrautheit mit dem Normalbetrieb eines Assets ist fundamental, aber wahre Meisterschaft kommt durch Analyse von Performance-Metriken – wie Mean Time Between Failures (MTBF) und Overall Equipment Effectiveness (OEE). Durch Korrelation von Sensordaten mit KPIs können Techniker subtile Abweichungen detektieren, die drohende Ausfälle signalisieren.
Best Practices für Asset-Daten-Tracking & -Nutzung
Alleines Vertrauen auf anekdotische Erfahrung kann Entscheidungen zum jüngsten Fix verzerren und tiefere Ursachen übersehen. Kreuzreferenzierung aktueller Symptome mit historischen Daten mindert Recency Bias und stellt sicher, dass Lösungen Root Causes statt Oberflächensymptome adressieren.
Umfassende Anlagenhistorien erstellen
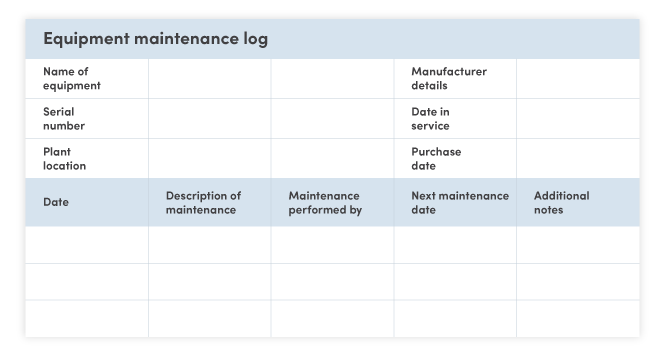
Eine gut dokumentierte Historie ist das Rückgrat effizienten Troubleshootings. Jede Interaktion erfassen: Ausfälle, präventive Wartung (PM), Inspektionen, Teiletausch, Produktionspläne, abnormale Beobachtungen wie Rauch oder ungewöhnliche Geräusche. Die erfolgreiche Resolution hervorheben – inkl. Teile, Arbeit, PSA.
Strukturiertes Wartungslog für diese Details nutzen. Unser Template herunterladen.
Root Cause Analysis (RCA) und Fehlercodes einsetzen
RCA involviert iteratives „Warum“-Fragen, bis das zugrundeliegende Problem freigelegt ist. Beispiel:
- Anlage fiel aus, weil ein Lager verschlissen war.
- Lager verschliss durch falsch ausgerichtete Kupplung.
- Kupplung falsch ausgerichtet, weil nicht gewartet.
- Wartung nicht geplant wegen unklarer Intervalle.
- Intervalle unklar wegen unzureichender Daten.
Dieser Prozess identifiziert sowohl sofortige Fixes als auch systemische Verbesserungen.
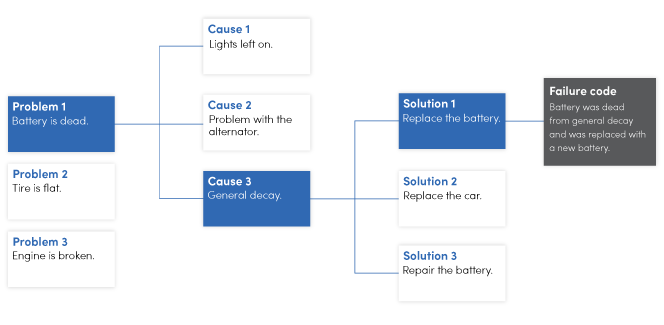
Fehlercodes standardisieren die Beschreibung von Vorfällen. Sie erfassen Problemtyp, Root Cause und empfohlenes Gegenmittel, ermöglichen schnelle Cross-Asset-Analyse und präventive Aktion.
Detaillierte Aufgabenlisten entwickeln
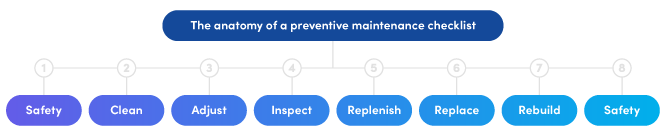
Klare, schrittweise Aufgabenlisten führen Techniker durch Inspektionen, Reparaturen und PMs, reduzieren Auslassungsrisiko. Alle nötigen Materialien, Ressourcen und persönliche Schutzausrüstung (PSA) einbeziehen. Aufgabenlisten dienen auch als Audit-Trails und geben Einblick in jüngste Arbeit bei der Diagnose von Ausfällen.
Informationen jederzeit zugänglich machen
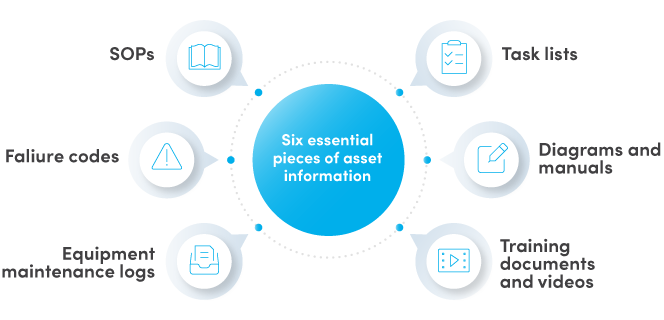
Daten, SOPs, Diagramme, Trainingsvideos, Handbücher sollten nach Asset organisiert in einem digitalen Knowledge Hub liegen. Mobile-freundliche Plattformen erlauben Technikern, kritische Infos auf dem Shopfloor abzurufen – ohne physische Dateien zu durchsuchen oder auf einzelnes Gedächtnis zu vertrauen.
Alles, was Sie über Wartungsmetriken wissen müssen
Wartungssoftware für schnellere Resolution nutzen
Digitale Plattformen wie Computerized Maintenance Management Systems (CMMS) zentralisieren Daten, automatisieren Workflows und liefern Echtzeit-Insights. Sie straffen Anlagenhistorie-Erstellung, Fehlercode-Management und Aufgabenlisten-Ausführung, befreien Techniker, um sich auf Analyse statt Dateneingabe zu fokussieren.
Beispiel: Ein CMMS kann Techniker während eines Fehlers mit strukturiertem Fragebogen prompten, Notizen sofort erfassen und den Eintrag mit der Anlagenhistorie verknüpfen. Tritt ein ähnliches Problem anderswo auf, zeigt das System relevante Vorfälle und empfohlene Lösungen.
Kernaussagen
Troubleshooting wird immer Teil der Wartung sein. Durch systematische Ansätze – Root Cause Analysis, Fehlercodes, detaillierte Aufgabenlisten, digitale Knowledge Hubs – können Sie die Abhängigkeit von Trial and Error reduzieren, Reparaturzeiten verkürzen und die Gesamtanlagenverlässlichkeit verbessern.
Gerätewartung und Reparatur
- Mobile Wartung: Die Cloud-getriebene Revolution im CMMS
- Mehr als Tickets: Wie Fiix' Work-Request-Portal Total Productive Maintenance vorantreibt
- Transformation von Betrieb & Instandhaltung: Praktischer Leitfaden für effektive Planung
- Lean Machines für Weltklasse-Fertigung und Instandhaltung: Praktischer Leitfaden zur Anlagenexzellenz
- U.S. Army treibt Condition-Based Maintenance mit innovativen Sensoren und Predictive Analytics voran
- Instandhaltungsproduktivität maximieren durch Multi-Skill-Training
- 5 bewährte Regeln zur Stärkung der Partnerschaft zwischen Betrieb & Instandhaltung
- Jenseits der Instandhaltung: Ein ganzheitlicher Ansatz zur Steigerung der Equipment-Verfügbarkeit
- Span of Control und Planung für Instandhaltungsteams optimieren
- Zuverlässigkeit von Kraftübertragungskomponenten steigern: Bewährte Strategien für Bergbau, Fertigung & Industrie