



Fehlertoleranz: Zuverlässigkeit, Verfügbarkeit und Sicherheit in kritischen Systemen steigern
Systeme ohne Fehlertoleranz sind inhärent weniger zuverlässig. Für Ingenieure, die sich auf RAMS – Reliability, Availability, Maintainability und Safety – konzentrieren, ist das Design mit Fehlertoleranz daher essenziell, besonders bei kritischer Ausrüstung, wo Ausfall das gesamte System gefährden kann.
In diesem Artikel skizzieren wir die Kernmerkmale fehlertoleranter Systeme und zeigen, wie redundantes Design die Zuverlässigkeit erhöht.
Was ist Fehlertoleranz?
Fehlertoleranz ist die Fähigkeit eines Systems, bei Auftreten eines Fehlers weiter zu operieren. Hoch-fehlertolerante Designs – ob durch Hardware-Redundanz, Software-Redundanz oder aktives Monitoring – müssen Single Points of Failure (SPOFs) eliminieren, um teilweisen oder vollständigen Betrieb aufrechtzuerhalten.
Das Wesen fehlertoleranter Designs
Die Entwicklung eines fehlertoleranten Designs erfordert tiefes Verständnis potenzieller Ausfallmodi über den gesamten Gerätelebenszyklus, deren Grundursachen und resultierende Auswirkungen. Ingenieure müssen gewünschte Zuverlässigkeit gegen Kosten und Ressourcenbeschränkungen abwägen. Es ist ein Missverständnis, dass ein fehlertolerantes System gegen jeden möglichen Fehler schützen muss; stattdessen sollte die Toleranz der Kritikalität des Fehlers entsprechen, um kostenoptimierte Optimierung zu erreichen.
Merkmale fehlertoleranter Systeme
Die Schaffung eines fehlertoleranten Systems erfordert bewusste Maßnahmen in jeder Lebenszyklusphase – Spezifikation, Design, Validierung und Verifikation (V&V), Wartung, Betrieb und Entsorgung. Folgende Techniken werden häufig angewendet:
- Fehlererkennung und -anzeige
- Fehlerdiagnose und -eindämmung
- Fehlermaskierung und -kompensation
1) Fehlererkennung und -anzeige
Erkennung ist das fundamentale Element jedes fehlertoleranten Designs. Ohne präzise Fehlersensorik und Benachrichtigung können nachfolgende Minderungsebenen nicht funktionieren. Beispielsweise nutzt ein Reifendrucküberwachungssystem (TPMS) einen Drucksensor, um den Fahrer zu warnen, wenn ein Reifen überdruck ist. Die einzige akzeptable Toleranz hier ist präzise Erkennung und Alarmierung; jegliche Korrekturmaßnahme liegt außerhalb des TPMS-Umfangs.
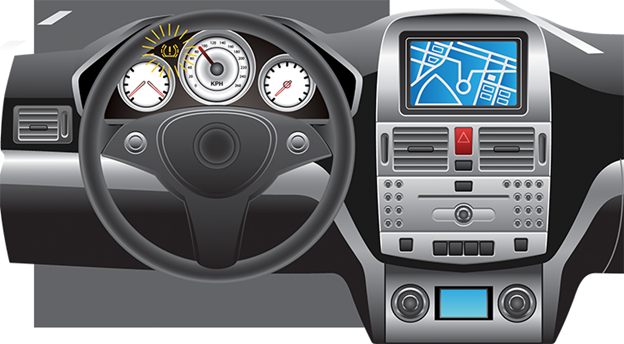
Darstellung der TPMS-Aktivierung
2) Fehlerdiagnose und -eindämmung
In kritischen Anwendungen folgt auf Erkennung diagnostische Algorithmen, die den Fehler lokalisieren und Eindämmungsmaßnahmen auslösen. Ein verteiltes Leitsystem (DCS) für ein Prozesswerk überwacht Sensoren, identifiziert abnormalen Druck und öffnet automatisch ein Sicherheitsventil, um Überdruck in einen Fackelstack abzulassen und Brand oder Explosion zu verhindern.
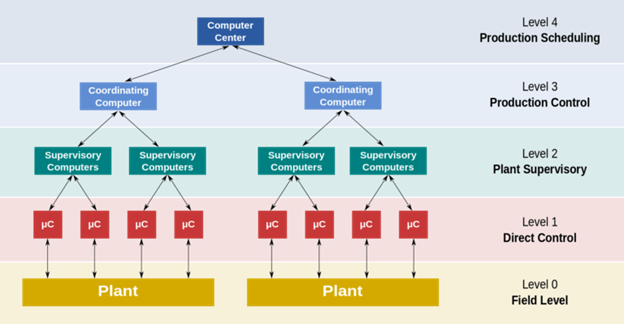
Darstellung des DCS-Systems
3) Fehlermaskierung und -kompensation
Fehlermaskierung ist besonders wertvoll in IoT-fähiger Ausrüstung, wo Cyberangriffe falsche Daten injizieren können. Durch Erkennung anormaler Datenströme und Ersetzung durch korrekte Werte verhindert das System die Weitergabe fehlerhafter Zustandsinformationen. In Stromnetzen überwachen SCADA-Systeme Spannung und Frequenz; ein Cyberangriff, der diese Grenzwerte manipuliert, könnte einen Stromausfall auslösen. Maskierungsalgorithmen schützen vor solcher Manipulation.
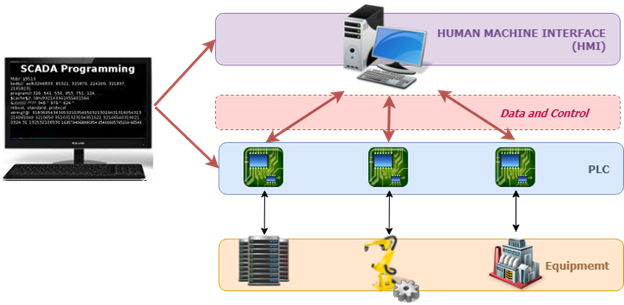
Darstellung des SCADA-Systems
Fehlertoleranz durch redundante Designs verbessern
Redundanz – Bereitstellung eines alternativen Systems, das die Funktion übernimmt, wenn das primäre ausfällt – ist der direkteste Weg, Fehlertoleranz zu erhöhen. Doch wahllose Redundanz kann Kosten und Komplexität aufblähen, daher muss die Entscheidung durch eine rigorose Kosten-Nutzen-Analyse gerechtfertigt sein.
Während Redundanz die Fehlertoleranz verbessert, sollte das wahllose Hinzufügen von Systemen nicht das Ziel sein, da die Kosten für jedes neue System den erreichbaren Zuverlässigkeitsnutzen deutlich übersteigen können.
Redundanztypen lassen sich grob in aktiv und passiv klassifizieren.
Aktive Redundanzen
Aktive Redundanz betreibt mehrere Einheiten gleichzeitig. Ein einfaches Beispiel: zwei Pumpen laufen mit halber Kapazität; gemeinsam erreichen sie den Zieldruck. Fortgeschrittenere Schemata – K-von-N-Redundanz und graceful degradation – erlauben, dass eine Teilmenge der Einheiten online bleibt, während andere als Hot Spares dienen, was fortgesetzten Betrieb bei Komponentenausfall sicherstellt.
K-von-N-Redundanz hält eine vordefinierte Teilmenge von Einheiten in Betrieb, wodurch ein größerer Pool an Spares beim Ausfall übernehmen kann. Graceful Degradation erlaubt, dass die Systemleistung proportional zum Komponentenverlust abnimmt, was teure identische Sparesets vermeidet.
Passive Redundanzen
Passive Redundanz stellt Standby-Ausrüstung bereit, die nur bei Ausfall des Primärsystems aktiviert wird. Zwei Varianten existieren:
- Operierende passive Redundanzen – Hot Spares, die unter Lastlos-Bedingungen im Leerlauf warten. Beispiel: ein Standby-Generator synchronisiert automatisch, wenn der Primärgenerator ausfällt.
- Nicht-operierende passive Redundanzen – Cold Spares, die hochgefahren oder manuell gestartet werden müssen. Eine kommunale Wasserpumpe, die manuell eingeschaltet wird, wenn die Hauptpumpe ausfällt, ist ein typisches Beispiel.
Zuverlässigkeitstechniken zur Analyse der Fehlertoleranz
Die Analyse der Fehlertoleranz stützt sich auf bewährte Zuverlässigkeitswerkzeuge: Failure Mode Effect Analysis (FMEA) und Fault Tree Analysis (FTA). FMEA untersucht einzelne Komponenten bottom-up, während FTA die Ausfallausbreitung top-down modelliert. Markov-Modelle und Monte-Carlo-Simulationen quantifizieren weiter, wie Ausfallwahrscheinlichkeiten sich über Zeit entwickeln und wie Unsicherheit die Gesamtleistung beeinflusst.
Fehlertoleranz und Wartungsbetrieb
Fehlertolerante Systeme eliminieren Wartung nicht, aber sie bieten einen Sicherheitsbuffer, der das Intervall zwischen Eingriffen verlängert. Ein Computer-Aided Maintenance Management System (CMMS) bleibt essenziell, um Korrekturmaßnahmen zu planen, bevor akkumulierte Fehler zu katastrophalem Ausfall führen. In der Praxis gewährt Fehlertoleranz Wartungsteams Spielraum, kritische Reparaturen zu priorisieren und nicht-dringende Arbeiten zu verschieben.
Trotz höherer Vorabkosten und Designkomplexität liefern fehlertolerante Designs messbare Gewinne in Gerätezuverlässigkeit und Systemverfügbarkeit.
Gerätewartung und Reparatur
- COVID-19 und die Cloud: Wie große Anbieter Unternehmen während der Pandemie stärkten
- Top-Performance in Instandhaltung & Zuverlässigkeit: Bewährte Strategien für langfristigen Erfolg
- Instandhaltung & Zuverlässigkeit: Warum „Gut genug ist nie gut genug“ Geschäftserfolg treibt
- Warum Liebe zum Detail Wartung & Zuverlässigkeit zum Erfolg führt
- Maintenance & Reliability Lieferanten: Ein kritischer Einkaufsleitfaden
- Flexibilität und Zuverlässigkeit in der modernen Fertigung in Einklang bringen
- Entropie nutzen für Exzellenz in Instandhaltung & Zuverlässigkeit
- Universität Tennessee gründet Reliability & Maintainability Center mit Fokus auf Zuverlässigkeitsexzellenz
- Zuverlässigkeits- & Sicherheitslektionen aus einem Kajak-Abenteuer
- ISA veröffentlicht aktualisierte 3. Auflage von Control Systems Safety Evaluation & Reliability