



FMEA meistern: Schritt-für-Schritt-Anleitung für Instandhaltungsmanager zum Aufbau und Nutzung der Fehlermöglichkeits- und Einflussanalyse
Ein bösartiger Ransomware-Angriff traf die Stadt Atlanta im März 2018. Er wurde zu einer der kostspieligsten Sicherheitsverletzungen des letzten Jahrzehnts. Öffentliche Services wurden gestört. Abteilungen wurden gezwungen, essenzielle Papierarbeit manuell zu erledigen. Und es kostete die Stadtregierung 17 Millionen Dollar.
Als sich der Staub gelegt hatte, war eines klar: Die Stadt war auf diese Katastrophe nicht vorbereitet. Ein Audit zwei Monate vor dem Breach fand 2.000 Vulnerabilitäten im IT-System der Stadt. Es war ein guter Schritt, aber zu wenig, zu spät.
Was in Atlanta passierte, ist eine warnende Geschichte mit einer großen Lektion – Risiko kann nie eliminiert, aber gemanagt werden. Das gilt besonders in der Instandhaltung. Equipment-Ausfall ist unvermeidlich. Aber zu wissen, wie man die Wahrscheinlichkeit von Ausfällen reduziert und wie man reagiert, wenn sie passieren, ist kritisch für Erfolg.
Eine Fehlermöglichkeits- und Einflussanalyse (FMEA) ist ein Werkzeug, um Ausfälle zu verstehen und zu antizipieren, damit Sie deren Auswirkungen begrenzen können. In diesem Artikel lernen Sie:
- Was eine FMEA ist
- Die verschiedenen Arten von FMEAs
- Wie man eine FMEA erstellt
- Und wie Instandhaltungsteams eine FMEA nutzen können
Was ist eine FMEA?
Eine Failure Mode and Effects Analysis (FMEA) identifiziert und dokumentiert alle Arten, wie ein Equipment ausfallen kann, und die potenziellen Auswirkungen dieser Ausfälle. Sie skizziert:
- Fehlermodi für individuelle Komponenten
- Die Konsequenzen von Ausfall auf Produktivität und Sicherheit
- Einen Plan zur Prävention oder Reaktion auf diese Issues
FMEAs aufzubauen ist eine Schlüsselkomponente von Reliability-Centered Maintenance (RCM).
Es gibt drei Hauptziele einer FMEA:
- Zukünftige Breakdowns verhindern, indem die Wahrscheinlichkeit häufiger und kritischer Ausfälle durch geplante Wartung und SOPs reduziert wird
- Reaktionszeiten verkürzen, Ausfallzeiten verringern, Gesundheit und Sicherheit verbessern, wenn Asset-Ausfall eintritt
- Präventive und korrektive Wartung in Nicht-Notfallsituationen priorisieren
Was sind die verschiedenen Arten von FMEA?
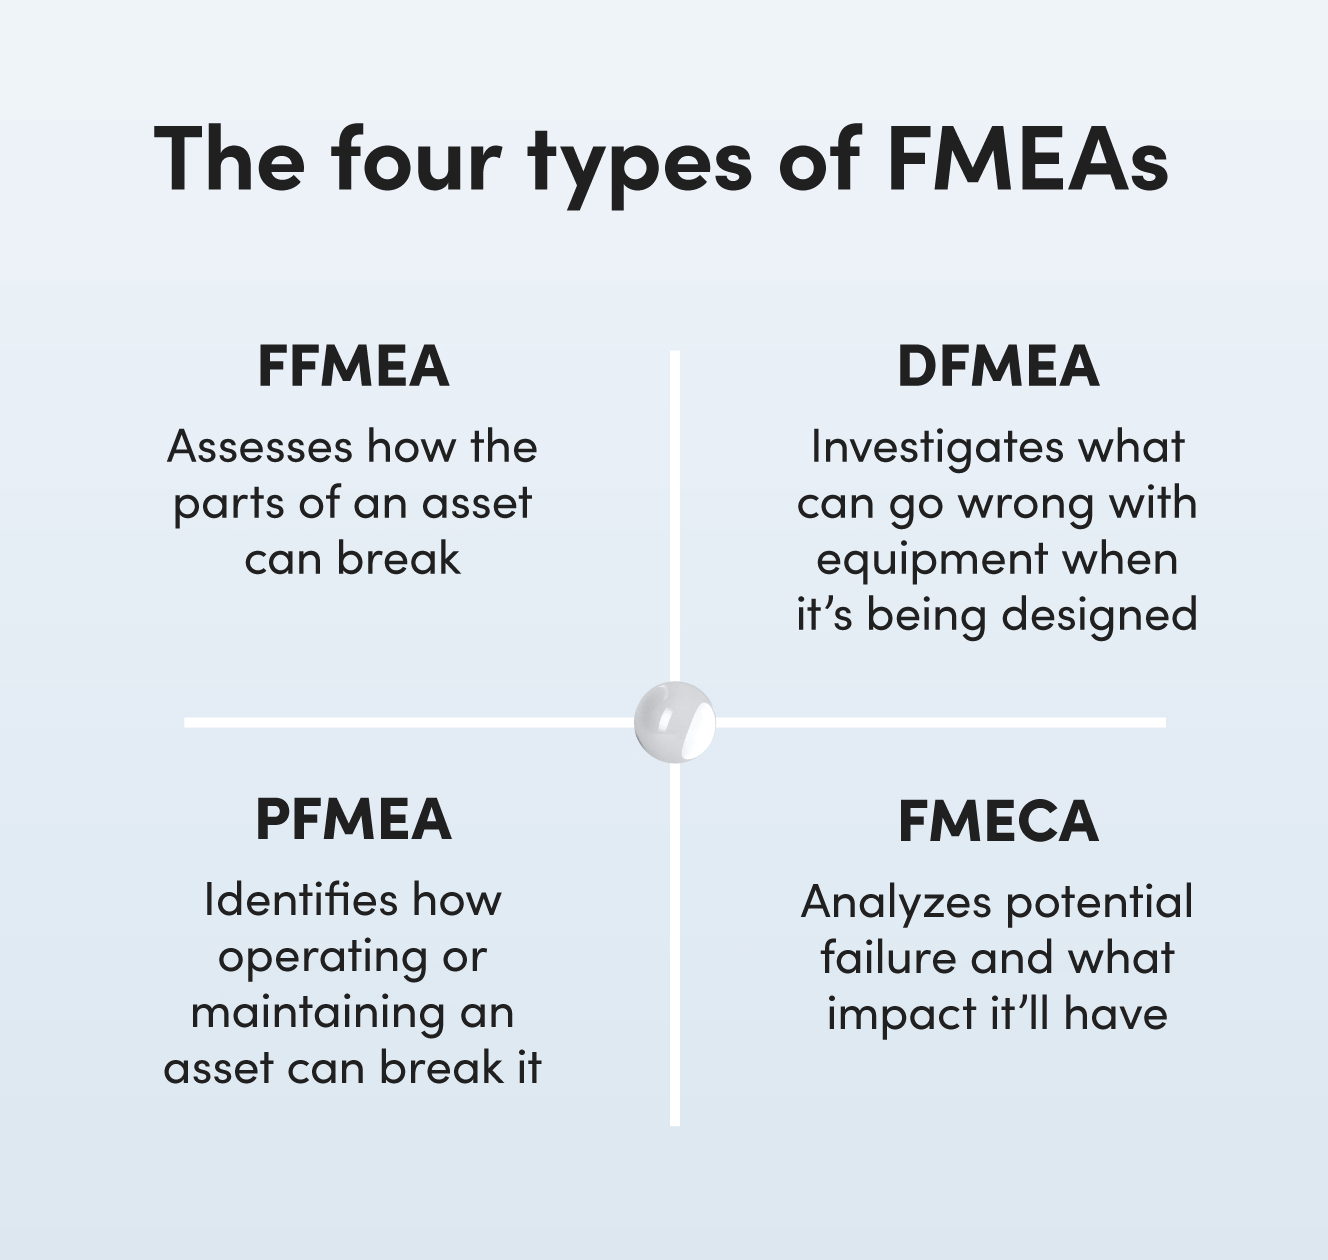
FMEAs können in Subtypen kategorisiert werden, basierend auf der Art des Risikos, das sie bewerten, und der Wirkung, die sie haben. Hier ein kurzer Überblick:
- FFMEA (Functional Failure Mode and Effects Analysis): Eine FFMEA analysiert Risiken, die die Systemfunktion beeinflussen. Ziel ist, diese Ausfälle vor ihrem Eintreten zu verhindern.
- DFMEA (Design Failure Mode and Effects Analysis): Eine DFMEA bewertet Risiken eines Assets in der Designphase. Ziel ist, potenzielle Issues vor Deployment zu finden und zu korrigieren, um Zuverlässigkeit zu erhöhen, Wartungsbedarf zu reduzieren und Asset-Lebenszyklus zu verlängern.
- PFMEA (Process Failure Mode and Effects Analysis): Eine PFMEA sucht nach möglichen Fehlern innerhalb eines Prozesses. Der Unterschied zu anderen FMEAs: Fokus auf das, was während Betrieb und Wartung eines Systems schiefgehen kann.
- FMECA (Failure Mode, Effects, and Criticality Analysis): Eine FMECA (oder Kritikalitätsanalyse) analysiert sowohl Fehlermodi als auch das zugehörige Risikolevel.
Unterschied zwischen Failure Mode und Failure Code
Ein Failure Mode ist ein Fehler oder Defekt, der ein System zum Malfunction bringt. Beispiel für einen Failure Mode an einem variablen Geschwindigkeits-Förderband: Lagerfestfressen. Ein gebrochenes Lager lässt das Band langsamer werden oder funktionsunfähig werden.
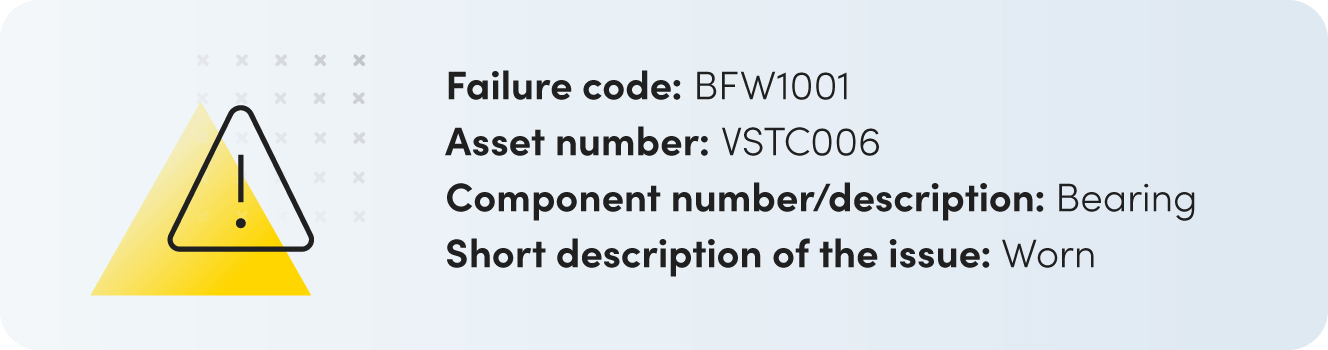
Ein Failure Code ist ein Fehlermodus, dargestellt durch einen alphanumerischen Tag. Failure Codes werden oft in CMMS-Software genutzt, um Information schnell zu vermitteln und nach Failure zu sortieren oder zu reporten. Failure Codes werden meist von drei Kontext-Informationen unterstützt. Ein Beispiel:
Unterschied zwischen FMEA und FRACAS
Eine FMEA skizziert möglichen Ausfall, seine Ursachen und Auswirkungen. Es ist ein proaktiver Prozess, der mögliche zukünftige Incidents und ihre wahrscheinlichen Root Causes listet.
Ein Failure Reporting, Analysis, and Corrective Action System (FRACAS) ist ein Closed-Loop-Reporting-System, das bereits eingetretene Ausfälle analysiert. Es untersucht vergangene Failures, um herauszufinden, warum sie passiert sind und welchen Impact sie hatten, damit sie zukünftig verhindert werden können. Es ist ein reaktives Maß.
FMEAs für Instandhaltung zu erstellen ist ein Schlüsselteil beim Aufbau eines FRACAS. Tatsächlich ist es der erste Schritt des Prozesses. Eine FMEA ist eine Baseline für Failure sowie Team- und Equipment-Performance. Sie können Entscheidungen basieren, wie welche Reports zu erstellen oder welche Failures zu targeten, auf dieser Information.
Wie Sie FMEAs für Instandhaltung nutzen können
Es gibt drei Hauptwege, wie Instandhaltungsteams eine FMEA nutzen können:
- Einen präventiven Wartungsplan erstellen, der die Wahrscheinlichkeit von Asset-Ausfall reduziert und Ressourcen optimiert
- Sich auf Notfallwartung vorbereiten, damit Assets schnell repariert und Ausfallzeiten minimiert werden können
- Korrektive Wartung und Wartungs-Backlog priorisieren
FMEAs nutzen, um einen präventiven Wartungsplan zu erstellen
Drei Wege, FMEAs für ein Weltklasse-Präventivwartungsprogramm zu nutzen:
- Neue präventive Wartungsaufgaben erstellen
- Präventive Wartung priorisieren
- Präventive Wartung optimieren
Laden Sie diese Vorlage herunter, um einen präventiven Wartungsplan zu erstellen
Der erste Schritt bei der Erstellung eines Präventivwartungsprogramms ist zu verstehen, welche Ausfälle auftreten können und wie oft. Eine FMEA skizziert diese Information. Wenn z. B. ein neues Asset designed wird, erlaubt eine FMEA herauszufinden, welche PMs nötig sind, um mögliche Failure Modes zu verhindern und wie oft sie durchgeführt werden müssen. Das ermöglicht das Mapping von Inputs für die Erstellung neuer PMs: wer zugewiesen wird, was den Work triggert, was es kostet, wie lange es dauert.
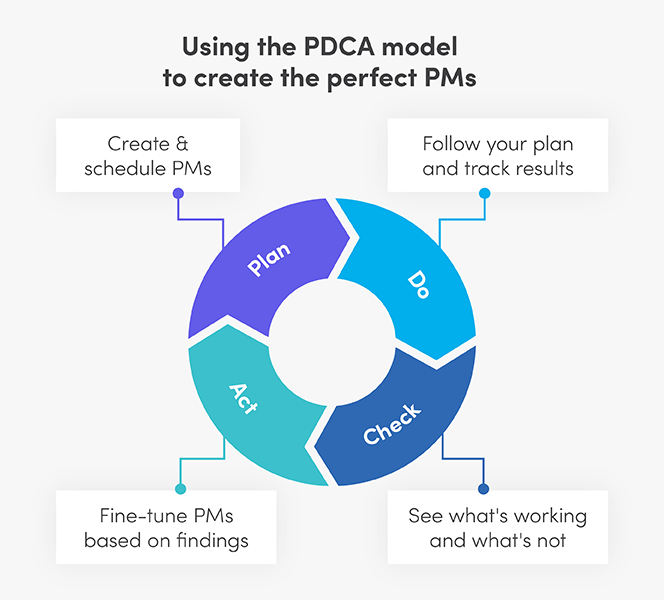
Der Erfolg Ihres Präventivwartungsprogramms hängt sowohl davon ab, wie viele Ausfälle Sie finden und stoppen, als auch von deren Impact. Wenn Sie 100 kleine Breakdowns verhindern, aber die fünf oder sechs Ausfälle nicht abfangen, die Ihr Unternehmen Millionen kosten, ist Ihr Programm fehlerhaft. Eine FMEA hat alle Informationen, die Sie brauchen, um PMs zu priorisieren und die wahrscheinlichsten und disruptivsten Breakdowns zu targeten.
Während FMEAs Ihnen eine Baseline für die Erstellung eines Präventivwartungsplans geben, halten Ihre Pläne nicht ewig. Ihr Betrieb ändert sich ständig. Ihr PM-Schedule muss sich mitändern. Work Order und Reparaturhistorien zur Aktualisierung von FMEAs zu nutzen, hilft Ihnen, Ihren Schedule zu optimieren und mit anderen Änderungen Schritt zu halten. Zum Beispiel tritt ein Failure Mode möglicherweise nicht so häufig auf wie vorhergesagt. Diese Daten können Sie dazu führen, die Frequenz der PM, die diesen Failure Mode verhindern soll, zu reduzieren. Sie können diese Ressourcen dann auf eine andere Wartungsaufgabe lenken.
FMEAs nutzen, um sich auf Notfallwartung vorzubereiten
Keine Menge an Wartung wird Failure totally eliminieren. Das Beste, was Sie tun können, ist, für High-Risk, High-Impact-Breakdowns zu planen, damit Ihr Team sie in einer Stunde statt zwei fixen kann. Eine FMEA ist ein wertvolles Werkzeug, um diese Notfallmaßnahmen zu platzieren.
Beginnen Sie damit, Ausfälle anzusehen, die den größten Impact haben und am häufigsten passieren. Aus dieser Liste picken Sie Failure Modes, die schwer zu detektieren sind. Sie enden mit Failure Modes, die schwer zu entdecken sind und das größte Chaos verursachen. Bauen Sie einen Notfallreaktionsplan für diese Breakdowns.
Ihr Notfallreaktionsplan sollte alle Informationen enthalten, die Reaktions- und Reparaturzeiten reduzieren. Er sollte auch Health & Safety berücksichtigen. Das kann Folgendes umfassen:
- Parts Kitting, um Zeit für das Abrufen kritischer Spares und PSA zu reduzieren (Parts Kitting Template herunterladen)
- Detaillierte Task-Liste oder Troubleshooting-Tipps erstellen
- Diagramme, Manuals, Fotos und andere visuelle Hilfen an Arbeitsaufträge anhängen
- Liste von Technikern oder Contractors, die die Reparatur durchführen können, erstellen
- Einen Weg etablieren, schnell mit Technikern zu kommunizieren, wie CMMS-Software
FMEAs nutzen, um korrektive Wartung und Wartungs-Backlog zu priorisieren
Früherkennung von Failure hilft, bedeutet aber nichts, wenn Sie keinen Prozess haben, diesen Failure schnell und effektiv zu korrigieren. Eine FMEA hilft Ihnen, diesen Prozess zu bauen.
Der erste Schritt ist, Failure Modes mit hohem Severity Score zu identifizieren (Assets, die Ihr Unternehmen am meisten kosten, wenn sie ausfallen). Korrekturmaßnahmen sollten an diesem Equipment so schnell wie möglich erfolgen. Diese Liste erlaubt Ihnen, Trainingsmaterialien und Response-Pläne zu bauen, damit alle wissen, wie auf Failure zu reagieren ist.
Sie können einen ähnlichen Ansatz beim Priorisieren des Wartungs-Backlogs anwenden, mit einem zusätzlichen Schritt. Nach Ranking der deferred work nach Severity, schauen Sie auf übrige Work nach Failure Frequency. Vergleichen Sie dies mit wie spät die Arbeit ist. Wenn ein Failure Mode eine Frequency Rate hat, die die Anzahl verpasster Inspektionen übersteigt, sollte diese Arbeit Priorität haben, da die Ausfallwahrscheinlichkeit höher ist.
Dieses kostenlose Template hilft Ihnen, Ihren Wartungs-Backlog zu priorisieren
Wie man eine FMEA erstellt
Das untenstehende FMEA-Template hilft Ihnen, Risiken in Ihrem Betrieb zu erkennen und Aktionen zu deren Prävention zu ergreifen.
Laden Sie Ihr eigenes FMEA-Template hier herunter
Zuerst: Wie man Daten für die FMEA beschafft
Gute FMEAs hängen von guten Daten ab. Ohne Daten bauen Sie Ihr Instandhaltungsprogramm auf Vermutungen und Annahmen. Wie finden Sie die benötigten Informationen für eine FMEA? Drei Quellen geben ein solides Fundament:
- OEM Guidelines: Das ist Ihr Startpunkt. Diese Guidelines geben eine Baseline für das Ausfüllen einer FMEA, wenn Sie keine anderen Daten haben.
- Interviews mit Operatoren und Technikern: Zapfen Sie die Erfahrung derer an, die täglich mit Equipment arbeiten. Sie geben Insights, die Sie nirgendwo anders finden – z. B. ob eine Komponente doppelt so viel Schmierung braucht wie vorgeschlagen oder ob die Failure-Frequenz gestiegen ist, weil Machine Specs sich geändert haben.
- Work Order Data: Ihre Arbeitsaufträge zeigen, wie Equipment performt und sind eine großartige Quelle für das Tweaken und Verbessern Ihrer FMEAs. Suchen Sie nach häufigen Failures, welche Actions zur Root Cause Findung und Fix unternommen wurden, was eine Reparatur verzögerte, und wie einfach ein Failure zu detektieren war.
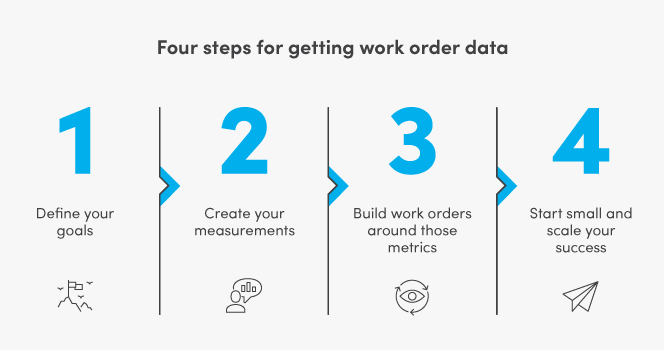
Keine dieser Quellen funktioniert allein. Kombinieren Sie sie, um ein vollständiges Bild zu erhalten, wie Ihr Equipment operiert, wie es ausfallen kann, der Impact von Failure und was dagegen zu tun ist.
Ein FMEA-Template
1. Asset-Komponenten identifizieren
Dokumentieren Sie jede Asset-Komponente, die brechen oder degradieren kann. Beispiel: Komponenten einer Abfülllinie können Getriebe, Motoren, Kettenräder, Lager und Düsen umfassen.
Starten Sie mit Ihren kritischsten Assets und arbeiten Sie nach unten. Ein guter Zeitpunkt, klare Namenskonventionen und Asset-Hierarchie zu erstellen, falls noch nicht vorhanden.
2. Potenzielle Failure Modes identifizieren
Identifizieren Sie, wie diese Komponenten ausfallen können. Wenn eine einzelne Komponente mehrere Failure Modes hat, listen Sie jeden entsprechend auf. Beispiel: Failure Modes eines Lagers können Fehlausrichtung, Korrosion oder Kontamination umfassen.
3. Potenzielle Failure Effects auflisten
Beschreiben Sie das Resultat eines Ausfalls und wie er Produktion und Staff-Sicherheit betrifft. Beispiel: Ein fehlausgerichtetes Lager wird eine Linie stilllegen, bis es ersetzt werden kann (ca. drei Stunden), mit potenziellem Verlust von 1.800 Einheiten.
4. Severity Score
Dies misst den Impact eines Ausfalls auf Produktion und Sicherheit. Skaliert 1 bis 10, wobei 1 ein Low-Impact-Event und 10 ein High-Impact-Event ist. Den Asset-Zustand beim Scoring berücksichtigen. Beispiel: Ein Auto, dessen Reifen bei niedriger Geschwindigkeit platzt, hat geringere Lenkprobleme; ein Reifenplatzer bei hoher Geschwindigkeit ist weit gefährlicher.
Berechnen Sie den Severity Score eines Assets mit diesem Criticality Analysis Template
5. Potenzielle Ursachen auflisten
Listen Sie alle möglichen Gründe auf, warum ein Failure aufgetreten sein könnte. Gehen Sie über die direkte Ursache hinaus. Beispiel: Ein korrodiertes Lager könnte passieren, weil Vorräte falsch beschriftet waren oder Anweisungen unklar waren, was zu falscher Schmierung führte.
Zum Grund des Failures vordringen mit diesem praktischen (und kostenlosen!) Root Cause Analysis Template
6. Erwarteter Frequency Score
Dies misst, wie häufig ein Failure Mode ist. Skaliert 1 bis 10, wobei 1 ein seltenes Event und 10 ein sehr häufiges Event repräsentiert.
7. Aktuelle Process Controls auflisten
Dokumentieren Sie alle Maßnahmen, die zur Prävention oder Detektion eines Failures vorhanden sind. Process Controls können wöchentliche PM-Inspektionen, monatliche Teileersetzungen und Sensoren zur Detektion gefährlich hoher Schwingungen umfassen.
8. Detection Score
Diese Zahl bestimmt, wie einfach es ist, ein Issue vor Total Failure zu detektieren. Skaliert 1 bis 10. Score 1 für ein Event, das nie detektiert werden kann. Score 10 für ein Event, das fast immer detektiert werden kann. Beispiel: Ein platter Reifen kann manchmal in frühen Stadien detektiert werden – Score 5. Ein Steinschlag in der Windschutzscheibe wird oft durch unvorhersehbare Events verursacht, schwer zu detektieren – Score 9.
9. Risk Priority Number (RPN)
Die Risk Priority Number berechnet Failure Modes mit höchstem Impact und höchster Präventierbarkeit. RPN = Severity × Frequency × Detection. Beispiel: Severity 8, Frequency 5, Detection 10 → RPN 400. Je höher die Zahl, desto mehr Ressourcen in Prävention dieses Failures investieren.
10. Empfohlene Aktion bestimmen
Einen Plan zur Reduzierung der Ausfallwahrscheinlichkeit oder Erhöhung der Früherkennungs-Chancen erstellen. Dies kann Erhöhung der PM-Frequenz an einer Komponente oder Investition in Condition-Monitoring-Equipment umfassen.
| Asset Komponente | Potenzieller Failure Mode | Potenzieller Failure Effect | Severity Scale* | Potenzieller Ursachen | Erwartete Frequency** | Aktuelle Process Controls | Detection Scale*** | Risk Priority Number | Empfohlene Aktion |
|---|
Welche Komponente ist betroffen? Wie kann diese Komponente fehlschlagen? Was ist der Impact auf Produktion/Sicherheit? Wie schwerwiegend ist der Impact? Was könnte den Ausfall verursachen? Wie oft wird die Ursache erwartet? Welche bestehenden Controls verhindern/entdecken den Failure Mode? Wie wahrscheinlich ist Detektion? Gesamt-Risiko (Severity × Frequency × Detection)? Aktionen zur Reduktion der Ursache oder Verbesserung der Detektion?
FMEAs managen
FMEAs sind lebende Dokumente, die regelmäßig reviewt und aktualisiert werden sollten. Events, die ein FMEA-Review triggern können:
- Ein neues Asset wird designed oder in Ihrer Facility installiert
- Ein neuer Techniker oder Operator joint das Team
- Änderung an Maschinen-Betriebsmodus (z. B. häufiger Betrieb oder Spec-Änderung)
- Ein Failure Mode tritt häufiger auf
- Neue Technologie wird implementiert, die Detektion/Prävention erleichtert
- Sie finden einen neuen Failure Mode oder Grund für bestehenden Failure
- Der Impact von Failure ändert sich (z. B. neues Produkt mit teurerem Material)
Sowohl Instandhaltungs- als auch Operations-Staff sollten an Modifikation und Erweiterung einer FMEA beteiligt sein. Die Vielfalt an Perspektiven und Erfahrungen mit Equipment hilft, Lücken in Ihren FMEAs zu vermeiden.
FMEAs sind eine langfristige Investition in Erfolg
Eine Failure Mode and Effects Analysis ist kein Pflaster oder Troubleshooting-Tool. Es ist eine kontinuierliche Aktivität mit dem Ziel, Failure wo möglich zu verhindern und seine Effects zu mildern, wo nicht. Es ist eine Planungsressource und Schutzschild gegen finanziellen Verlust und Sicherheitsrisiken.
Während das Erstellen von FMEAs beträchtlichen Zeitaufwand erfordert, zahlt es sich langfristig aus, indem es Ihnen hilft, vorauszuplanen, reaktive Wartung zu verhindern und Team-Erfolg zu tracken.
Gerätewartung und Reparatur
- Instandhaltung proaktiv halten: Lektionen von Sisyphus für kontinuierliche Verbesserung
- Vorbeugende & zustandsbasierte Instandhaltung meistern: Praktischer PM-Entwicklungsleitfaden
- Top-Performance in Instandhaltung & Zuverlässigkeit: Bewährte Strategien für langfristigen Erfolg
- Warum Liebe zum Detail Wartung & Zuverlässigkeit zum Erfolg führt
- Instandhaltung vereinfachen: Grundlegende Sinne und praktische Einsicht nutzen
- 5 Hauptursachen für Equipment-Ausfälle und bewährte Präventionsstrategien
- Produktivität maximieren: Wie Wartungssoftware Kosten senkt und Zeit spart
- Ausfallberichterstattung für Instandhaltungsteams optimieren
- Expertenrat zur Skilift-Wartung & Schlüsselteile
- Kranbetrieb & Wartung: Umfassender Sicherheits- und Pflegeleitfaden