



Fehlererkennung & Diagnostik: Anlagenverlässlichkeit und Instandhaltungseffizienz steigern
Die Ursachen von Geräteausfällen zu verstehen und proaktive Erkennungs- und Diagnosestrategien zu implementieren, ist fundamental für moderne Instandhaltungspraktiken.
Dieser Artikel bietet einen umfassenden Überblick über Fault Detection and Diagnostics (FDD) und wie es Anlagenverlässlichkeit erhöht und Instandhaltungsworkflows strafft.
Die Evolution von Fehlererkennung und Diagnostik
Historisch basierte Instandhaltung auf reaktiven Reparaturen und starren zeitbasierten Plänen. Fachleute waren durch verfügbare Technologie für Erfassung, Speicherung und Analyse von Anlagenzustandsdaten limitiert.
Fortschritte bei Mikroprozessoren, Automatisierung, Echtzeit-Datenerfassung und FDD-Systemen haben revolutioniert, wie wir Instandhaltung angehen – und prädiktive sowie präskriptive Strategien ermöglicht, die Stillstand reduzieren und Anlagenlebensdauer verlängern.
Was FDD für die Geräte-Instandhaltung bringt
FDD zielt darauf ab, Instandhaltungskosten zu optimieren, während gleichzeitig Reliability, Availability, Maintainability und Safety (RAMS) von Geräten verbessert werden. Dies geschieht durch kontinuierliche Überwachung von Zustandsdaten, Anomalieerkennung und Einspeisung in Fehlerdiagnose-Algorithmen, die Alarme für Bediener generieren und in einigen Fällen automatisierte Eindämmungsaktionen auslösen, um Normalbetrieb wiederherzustellen.
Kernkomponenten eines effektiven FDD-Systems
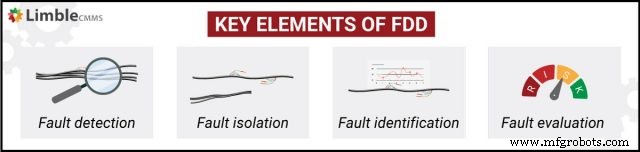
Im Kern führt FDD Fehlererkennung, -isolierung, -identifikation und -bewertung durch. Diese Prozesse laufen oft parallel, aber jeder spielt eine distinkte Rolle:
1. Fehlererkennung
Fehlererkennung ist der erste und kritischste Schritt. Sie muss das Vorhandensein eines Fehlers identifizieren, bevor er zum Ausfall eskaliert. Genauigkeit hier bestimmt die Effektivität nachgelagerter Prozesse.
Zwei Hauptansätze existieren:
- Modellbasierte Erkennung: Basiert auf mathematischen Modellen, die physikalische Beziehungen im System abbilden. Wenn eine Regel verletzt wird, flaggt der Algorithmus einen Fehler.
- Wissensbasierte Erkennung: Nutzt historische Performancedaten, um eine normale Betriebssignatur zu etablieren und Abweichungen durch statistische oder Machine-Learning-Techniken zu flaggen.
Modellbasiertes Erkennungsbeispiel
Time-Domain Reflectometry (TDR) ist eine klassische modellbasierte Methode zur Fehlererkennung in Erdkabeln. Durch Analyse von Rücksignalzeit und -geschwindigkeit unterscheidet TDR zwischen Offen- und Kurzschlussfehlern.
In einer Flaschenabfülllinie kann eine simple Regel wie „Flaschen können nicht verkappt werden, bevor sie gefüllt sind“ einen Fehleralarm triggern, wenn der Verkappungsmechanismus versagt – und so nachgelagerte Verpackungsstörungen verhindern.
Wissensbasiertes Erkennungsbeispiel
Baseline durch Erfassung von Parametern wie Spannung, Strom, Vibration, Temperatur und Druck im Normalbetrieb erstellen. Kontinuierliches Monitoring vergleicht Live-Daten gegen diese Baseline mittels Machine-Learning-Modellen, um subtile Abweichungen zu detektieren, die auf drohende Ausfälle hindeuten – z. B. Motorlagerverschleiß.
2. Fehlerisolierung
Isolierung grenzt den Fehler auf die granularste austauschbare Komponente ein, minimiert Stillstand und Reparaturaufwand. Effektive Isolierung nutzt oft dieselben Algorithmen wie die Erkennung und liefert Standortdaten in Echtzeit.
Beispielsweise bestätigt TDR nicht nur einen Kabelbruch, sondern ortet ihn exakt durch Timing des reflektierten Pulses. Ebenso kann Isolierung in einem Fördersystem identifizieren, ob das Problem in der Verkappungs-Steuerkarte oder dem Verpackungsmodul liegt.
3. Fehleridentifikation
Identifikation bestimmt Ausfallmodus, Ausmaß und Root Cause. Der Prozess umfasst typischerweise drei Schritte:
- Ausfallmodus charakterisieren durch Analyse seiner zeitvarianten Signatur.
- Fehlergröße quantifizieren, um Toleranz und notwendige Sanierung zu bewerten.
- Root Causes zurückverfolgen mittels datengetriebener Modelle, die Sensorsignaturen mit bekannten Ausfallmechanismen korrelieren.
Beispielsweise kann ein Hochspannungs-Drehstrom-Asynchronmotor bei gebrochenen Rotorstäben eine verdoppelte Statorstromfrequenz zeigen. FDD-Algorithmen detektieren dieses Muster, schließen auf den mechanischen Fehler und zeigen die Root Cause im Live-Dashboard.
Automatisierte Root-Cause-Diagnostik verkürzt Troubleshooting-Zeit drastisch, reduziert Stillstand, verbessert Mean-Time-To-Repair und boostet Anlagenverlässlichkeit.
4. Fehlerbewertung
Bewertung beurteilt die Auswirkung des Fehlers auf Systemperformance, Sicherheit, Umwelt und Finanzen. Dieser Schritt informiert die Wartungsstrategiewahl – ob Run-to-Failure, präventiv oder prädiktiv – und leitet Kapitalaustauschentscheidungen.
Beispielsweise kann eine schnell steigende Ausfallrate mit minimaler operativer Auswirkung einen Run-to-Failure-Ansatz rechtfertigen, während ein hochwirksamer Fehler ein stringentes prädiktives Programm triggert, trotz höherer Kosten.
Instandhaltung mit FDD optimieren
FDD transformiert Instandhaltung von reaktiv zu prädiktiv. Advanced Computing, Big-Data-Analytik und Machine Learning haben traditionelle Fehlererkennung in vollautomatisierte Fault-Management-Systeme gewandelt, die Fehler autonom detektieren, diagnostizieren und korrigieren.
Zuverlässigkeitsingenieure nutzen FDD-Insights nun, um Anlagenzustand zu prognostizieren, Wartung präzise zu planen und Ressourcen effizient zu allokieren – oft integriert mit ihrem Computerized Maintenance Management System (CMMS).
Durch FDD-Nutzung können Organisationen Anlagenlebensdauer verlängern, ungeplante Stillstandszeiten reduzieren und signifikante Kosteneinsparungen über den Equipment-Lebenszyklus erzielen.
Gerätewartung und Reparatur
- Wie sich industrielle Instandhaltung entwickelt hat: Von reaktiv zu vorausschauend
- Instandhaltung weise wählen: Risiko und Ausrüstung Ihre Strategie leiten lassen
- Wie Gesundheitsausgaben die Instandhaltung spiegeln: Lehren für langfristige Zuverlässigkeit
- Top-Performance in Instandhaltung & Zuverlässigkeit: Bewährte Strategien für langfristigen Erfolg
- Lean Machines für Weltklasse-Fertigung und Instandhaltung: Praktischer Leitfaden zur Anlagenexzellenz
- Warum Liebe zum Detail Wartung & Zuverlässigkeit zum Erfolg führt
- 5 Schlüsselelemente, die Anlagenverlässlichkeit durch Wartungsplanung antreiben
- 5 Hauptursachen für Equipment-Ausfälle und bewährte Präventionsstrategien
- 3 wesentliche Tipps für erfolgreiches Industriemaschinen-Mieten & Warten
- Bewährte Motorwartungsstrategien zum Schutz schwerer Maschinen