



Entdeckung neuer thermoelektrischer Materialien mit Wort-Einbettungen
Sprechen Sie heute mit jemandem, und er wird Ihnen sagen, dass Künstliche Intelligenz das nächste große Ding ist – die heiße Kartoffel, von der jeder ein Stück will, aber niemand kauen kann.
Eine große Mehrheit wird Ihnen auch sagen, dass vieles, was als KI herumgeht, eigentlich nur Hype ist – eine Verherrlichung von gutem alten maschinellem Lernen und Mathematik, verkleidet in PowerPoint. Und im Großen und Ganzen hätten sie recht.
Es gibt jedoch einen Bereich, in dem die Anwendung von KI-Tools wie Deep Learning nichts weniger als revolutionär war: die Verarbeitung natürlicher Sprache (Natural Language Processing, NLP).
Ein einfaches Beispiel sind die Chatbots, die Websites bemannen. Sie werden von relativ komplizierten Deep-Learning-Architekturen betrieben, sogenannten Long Short-Term Memory (LSTM) neuronalen Netzen. Diese Algorithmen können „verstehen“, was wir ihnen sagen, und zusammenhängende, lesbare Sätze als Antwort zusammenfügen. Sicher, dieser Bot ist kein Sokrates, aber er würfelt nicht einfach ein zufälliges Durcheinander von Wörtern zusammen. Es gibt den unbestreitbaren Hinweis auf eine Art niedrigstufiger Intelligenz.
Wort-Einbettungen (Word Embeddings)
Das moderne Zeitalter des Deep Learning in der Sprachverarbeitung begann mit der Veröffentlichung von Tomas Mikolovs word2vec-Papier 2013. Ihr Triumph lag in der Entwicklung einer rechnerisch machbaren Methode zur Erzeugung von Wort-Einbettungen oder Wortvektoren mithilfe neuronaler Netze.
Betrachten Sie die Wörter Mann, Frau, König und Königin. Wenn Sie aufgefordert würden, diese Wörter zu gruppieren, hätten Sie eine Reihe von gesundem Menschenverstand basierten Optionen. Ich tendiere dazu, [Mann, Frau] und [König, Königin] zu sehen. Sie könnten [Mann, König] und [Frau, Königin] sehen.
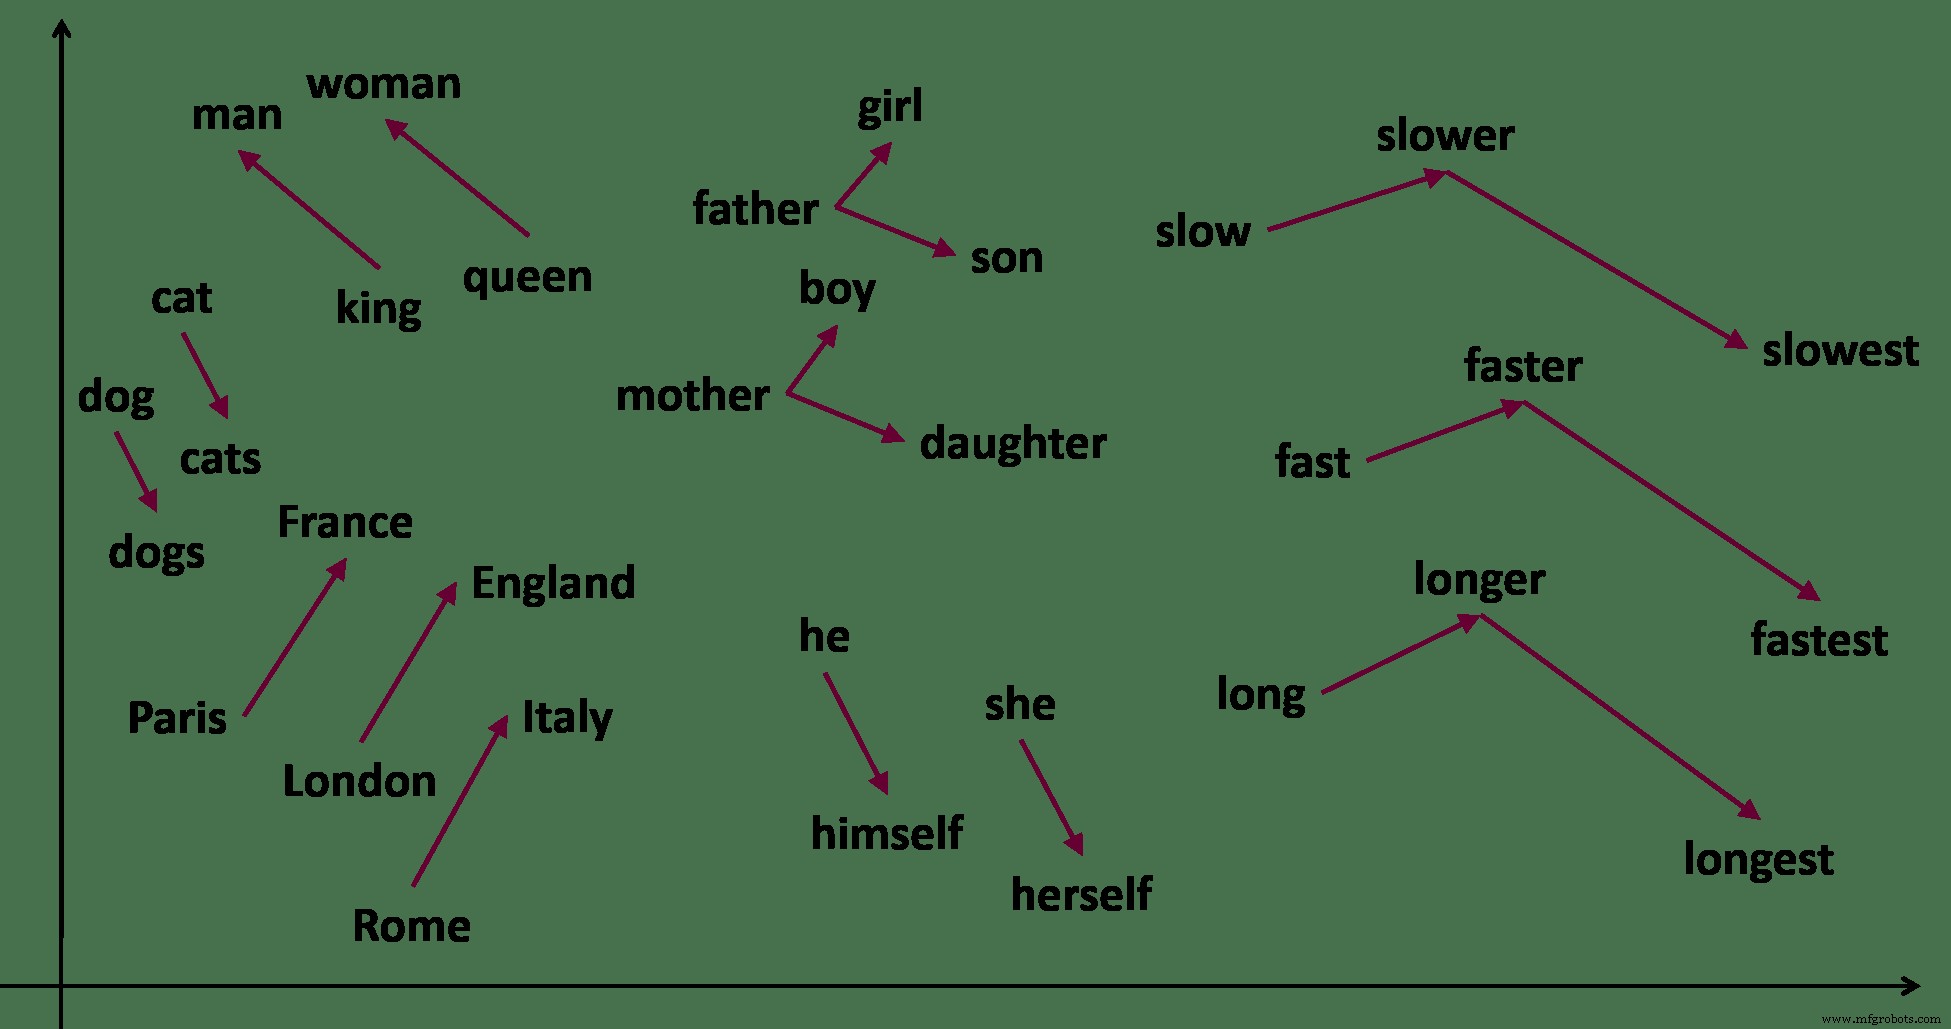
Ich weiß auch, dass das Wort König und Mann exakt so zueinander in Beziehung stehen wie Frau und Königin.
Mann:König = Frau:Königin
Selbst wenn ich diese Wörter nie zuvor gehört hätte, könnte ich diese Beziehungen lernen, indem ich die Sätze beobachte, die ich antreffe. „Dieser Mann ist ein König“, „Die Königin war eine gottgleiche Frau“, „Sie regierte als Königin der Leinwand“, „Sein Königreich wird kommen“. Diese Sätze deuten allein durch die Nähe der Wörter an, dass der König meist ein Mann ist und eine Königin höchstwahrscheinlich eine Frau.
Wort-Einbettungen machen dasselbe, aber für Millionen von Wörtern aus Tausenden von Dokumenten. Der Schlüssel ist, dass die Wörter aus dem Kontext gelernt werden. Was diese mathematische Analogie ermöglicht, sind die Kräfte moderner Computertechnik und die Magie des Deep Learning.
Deep-Learning-Wort-Einbettungen
Angenommen, wir wollen die Einbettungen für alle Wörter in Harry Potter finden.
Zuerst erstellen wir eine Art mathematisches Tresor-Bibliothek-Kammer. Ein monströses multidimensionales Ungetüm, groß genug, um alle Wörter aufzunehmen, die wir brauchen. Dies ist der Vektorraum.
Das Ziel ist, Harry Potter Wort für Wort durchzugehen und jedes Wort in einen Tresor in der Kammer zu legen. Ähnliche Wörter wie Kleid und Mantel kommen in denselben Tresor. Quidditch und Schnatz sind in benachbarten Tresoren. Auto und Zentaur sind so weit voneinander entfernt wie Banane und Voldemort.
Die Wort-Einbettung eines Wortes ist die Adresse des Tresors, in dem es zu finden ist. Mathematisch macht dies es zu einem Vektor im Vektorraum.
Man kann verstehen, warum kein Mensch diesen Job je wollen würde. Es gibt viel zu viele Wörter und viel zu viel Hin und Her.
Ein neuronales Netz macht dies jedoch außerordentlich gut. Es tut dies durch, nun ja, Magie.
Ein tiefes neuronales Netz ist eine Art massive Maschine mit Millionen von Zahnrädern und Hebeln. Am Anfang ist es alles Chaos und nichts passt zu irgendetwas, obwohl überall gemischt wird. Dann langsam beginnen sich einige Zahnräder zu verriegeln. Die Hebel fallen an ihren Platz – und Ordnung entsteht aus dem Chaos. Die Maschine beginnt sich zu bewegen. Frankenstein lebt!
Die Sprache ist hier absichtlich vage. Ich möchte Sie zu den Anwendungen von Wort-Einbettungen führen, statt wie sie hergeleitet werden. Dass gesagt, auf fundamentaler Ebene wissen wir nicht ganz, wie neuronale Netze tun, was sie tun. Daher müssen wir in unseren Experimenten mit der Anzahl der Schichten, den Aktivierungsfunktionen, der Anzahl der Neuronen in jeder Schicht usw. herumspielen, bevor wir zu unserer Aufgabe kommen. Aber das ist ein Thema für einen anderen Tag.
Thermoelektrika
In einem 2019 veröffentlichten Paper erzeugte ein Forscherteam am Lawrence Berkeley Lab die Wort-Einbettungen aller Abstracts in etwa 3,3 Millionen Papers, die in 1000 Journalen veröffentlicht wurden. Diese Liste ist offensichtlich riesig und deckt fast jedes Thema ab, das in der Materialwissenschaft in den letzten paar Jahrzehnten veröffentlicht wurde.
Bei wissenschaftlichem Text sind chemische Formeln und Symbole auch „Wörter“. Daher gibt es einen Wortvektor für LiCoO2 – ein gängiger Batteriekathodenstoff. Man kann dann Fragen stellen wie: Was sind die nächsten Wortvektoren zu LiCoO2?
Wir wissen, dass LiCoO2 ein Vektor im Vektorraum ist. Also müssen wir nur Vektoren finden, die in der Nähe sind.
Die Antwort lautet: LiMn2O4, LiNi0.5Mn1.5O4, LiNi0.8Co0.2O2, LiNi0.8Co0.15Al0.05O2 und LiNiO2 – allesamt ebenfalls Lithium-Ionen-Kathodenmaterialien.
Sehen Sie, was wir hier getan haben?
Wir versuchten wirklich, andere Materialien zu erforschen, die unserer Lieblingskathode ähnlich sind. Statt tausend Papers zu lesen, Notizen zu machen und eine Liste von Lithiumverbindungen zu erstellen, löste die Wort-Einbettung die Aufgabe in wenigen Sekunden.
Das ist die Macht der Wort-Einbettung. Indem semantische Anfragen in mathematische Vektoroperationen umgewandelt werden, ermöglicht dieser Ansatz, große Textdatenbanken besser und effizienter abzufragen und zu verstehen.
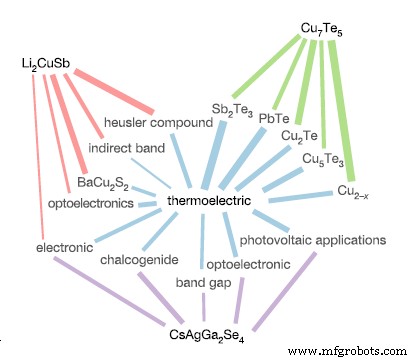
Als weiteres Beispiel untersuchten die Forscher, wie oft eine chemische Verbindung in der Nähe des Vektors für „thermoelektrisch“ gefunden wurde. (Dies sind Materialien, die elektrische Energie in Wärme oder umgekehrt umwandeln).
Dies können Sie durch eine einfache Vektoroperation namens Skalarprodukt tun. Vektoren, die ähnlich sind, haben ein Skalarprodukt, das sich der Eins nähert. Unähnliche Vektoren haben ein nahezu null Skalarprodukt.
Indem man dieselbe Operation auf chemische Verbindungen in der Datenbank und das Wort „thermoelektrisch“ anwendet, fanden die Autoren alle Chemikalien, die wahrscheinlich thermoelektrisch sind.
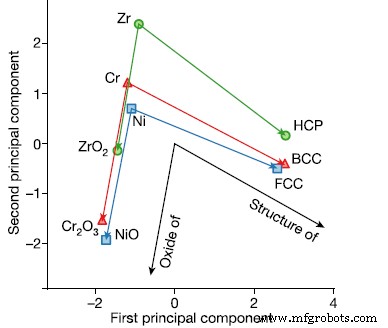
Die Autoren zeigen weiter, dass ähnliche Beziehungen für mehrere Materialeigenschaften wie Kristallstruktur und Ferroelektrizität demonstriert werden können. Weiterhin zeigen sie, dass mit dieser Technik mehrere der aktuellen Thermoelektrika Jahre zuvor aus bestehender Literatur hätten vorhergesagt werden können.
Die Analyse ist ein sehr schöner, eleganter, aber täuschend einfacher Ausdruck der Frage: „Von all den vom Menschen untersuchten Materialien, welche sind wahrscheinlich thermoelektrisch?“
Materialdatenbanken sind die Notwendigkeit der Stunde
Man würde annehmen, dass wir diese Liste bereits haben –显然有人一直在记录我们所做的所有工作?编纂材料手册和电子数据库?
Die Antwort ist ein überraschendes Nein. Der riesige Wissensschatz, den wir über die Jahre angehäuft haben, ist in Texten wie Büchern, Journalen und Papers eingeschlossen. Es gibt so viele davon, dass es für uns unmöglich ist, sie manuell zu durchsuchen.
Genau deshalb sind Wort-Einbettungen und die in diesem Paper demonstrierten Techniken nichts weniger als revolutionär.
Sie versprechen, die Art und Weise zu verändern, wie wir mit Text interagieren, und unsere Materialdatenbanken rasant zu beschleunigen.
Welche Materialien wurden auf Piezoelektrizität untersucht? Gibt es einen Supraleiter, den wir in der Literatur übersehen haben? Gibt es ein neues Medikament, das Alzheimer heilen kann?
Fragen Sie die Wort-Einbettungen. Sie würden es wissen.
Industrietechnik
- CMMS-Training meistern: Teams engagieren & Retention boostern
- Python Print ohne Newline: Den end-Parameter & andere Techniken meistern
- ASC 842 erklärt: Wie der neue Lease Accounting Standard Transport & Logistik transformiert
- Wie sich die Lebensmittelindustrie an rasche Verhaltensänderungen der Verbraucher anpasst
- Silver Fern Farms meistert Pandemie: Globale Fleisch-Exporte sichern
- Im neuen Zeitalter des Cross-Border E-Commerce gedeihen: Bewährte Strategien für Erfolg
- Händler: Bewährte Strategien gegen steigende Versandzuschläge
- Umsatz steigern, indem Sie neue Kunden gezielt ansprechen – auch wenn Bestellungen zurückgehen
- Pennsylvania stellt 110.000 $ bereit, um Fertigungskarrieren für Philadelphia-Schüler zu erweitern
- MTConnect: Präzision und Rentabilität in der modernen Fertigung vorantreiben